
机器学习入门:随机森林(Random Forest)
机器学习入门:随机森林(Random Forest)
前言:本文是"机器学习入门"系列的第五站。在上一站中,我们深入学习了决策树,明白了它是一棵通过"如果……那么……"规则进行分类的白盒模型。但单棵决策树往往有一个致命的弱点——容易过拟合,且对数据的扰动非常敏感。那么,如果我们种下一片森林,让多棵树一起投票表决呢?这就是今天的主角:随机森林(Random Forest)。它汇聚众树之所长,大幅提升了模型的准确率和稳定性。
目录
- 一、从单棵树到一片森林
- 二、随机森林的核心原理
- 三、随机森林 vs 决策树
- 四、随机森林的优缺点
- 五、典型应用场景
- 六、随机森林核心 API 速查
- 七、实战案例
- 八、总结
一、从单棵树到一片森林
1.1 为什么要集成?
想象你要诊断一种疑难杂症:
- 场景A:只咨询一位医生,可能因个人状态或经验局限而误判。
- 场景B:邀请100位专家医生独立会诊,然后投票决定结果。
显然,多数投票的群体决策比单一专家更稳妥。
这就是集成的核心思想。
1.2 什么是集成学习?
集成学习(Ensemble Learning)的核心逻辑很简单:三个臭皮匠,顶个诸葛亮。
它组合多个弱学习器来构建一个强学习器。单个弱学习器效果一般,但组合后长短互补、优劣相抵,最终实现整体远胜部分的效果。
随机森林正是集成学习最具代表性的算法之一——它以决策树为弱学习器,让每棵树"各有所长",最终通过投票汇聚众智。
1.3 为什么要放弃单棵树?
单棵决策树有两个致命的痛点:
- 对数据极度敏感:数据微小变化就可能导致树结构截然不同,稳定性差。
- 过拟合风险极高:倾向于"死记硬背"训练样本,泛化能力弱。
随机森林正是为此而生——通过双重随机化抵消单棵树的偏误,用群体决策取代个人判断。
二、随机森林的核心原理
随机森林(Random Forest)是由多棵决策树组成的分类或回归模型。其核心思想可以概括为两个"随机":
2.1 随机性一:样本随机(Bagging 思想)
传统决策树训练时,使用的是全部训练样本。而在随机森林中,每棵树在训练时,并不使用所有数据。
- 做法:从总训练集中,采用**有放回采样(Bootstrap Sampling)**的方式,随机抽取一定数量的样本,构成该树的专属训练集。
- 效果:这就导致每棵树看到的训练数据都不尽相同。有些样本可能被一棵树多次抽中,而有些样本可能从未被抽到。
2.2 随机性二:特征随机
在传统决策树中,选择分裂节点时会遍历所有特征去寻找最优切分点。而在随机森林中,为了避免所有树都长得过于相似,引入了第二重随机:
- 做法:在每棵树进行节点分裂时,算法不会考察全部特征,而是从总特征中随机抽取部分特征(通常取总特征数的平方根),仅在这部分特征中寻找最优切分。
- 效果:这确保了森林中的每棵树都各有侧重、相互独立,从而降低整体方差。
2.3 最终决策
当输入一个新的测试样本时,森林中所有的决策树都会给出自己的预测结果:
- 分类任务:采用多数投票法(Majority Voting)——哪个类别得票最多,就作为最终分类结果。
- 回归任务:采用平均值法(Averaging)——将所有树的预测结果取平均,作为最终输出。
2.4 特征重要性计算方式
随机森林通过记录每个特征在所有树中参与分裂时所带来的不纯度减少量(Gini 不纯度减少或信息增益),并将这些减少量按特征汇总、归一化,最终得到每个特征的重要性得分。得分越高,说明该特征对分类或回归的贡献越大。这使得随机森林自带特征选择能力,在实际项目中非常实用。
三、随机森林 vs 决策树
| 对比维度 | 单棵决策树(CART) | 随机森林(Random Forest) |
|---|---|---|
| 模型复杂度 | 低,单模型 | 高,多棵树的集成 |
| 过拟合风险 | 极高(容易死记硬背) | 显著降低(双重随机性有效抑制方差) |
| 训练速度 | 快 | 较慢(需训练多棵树,但可并行) |
| 特征重要性 | 可通过 Gini 或信息增益计算 | 内置特征重要性评估(非常实用) |
| 数据敏感度 | 对数据扰动非常敏感 | 极度稳定,抗噪声能力强 |
| 是否需要标准化 | 否 | 否(同样基于树的阈值分裂规则) |
| 可解释性 | 强(白盒模型,可直观展示决策路径) | 弱(数百棵树投票,难以直观理解) |
四、随机森林的优缺点
4.1 优点
- 抗过拟合能力突出:双重随机性使得模型即使在特征多、样本相对较少的情况下,也不易过拟合。
- 高维数据处理能力强:无需提前做特征选择,它能自动评估特征的重要性。
- 能处理缺失值:内置了缺失值处理机制(通过代理分裂等方式)。
- 易于并行化:每棵树相互独立,非常适合在多核 CPU 上并行训练,效率较高(相对其他集成算法而言)。
- 对异常值不敏感:基于树的模型天然对异常值有较强的鲁棒性。
4.2 缺点
- 可解释性较差:决策树是白盒模型,但当数百棵树一起决策时,人类难以直观理解其内部逻辑。它可被视为一个"黑盒中的白盒"。
- 在某些高噪声数据集上可能过拟合:当数据噪声较大时,随机森林仍可能过度学习噪声。
- 模型体积较大:需保存全部树的结构,内存占用和推理时间相对较高。
- 对稀疏数据表现一般:在极度稀疏的高维数据(如文本分类)上,随机森林的表现通常不如线性模型或 SVM。
五、典型应用场景
- 金融风控(信用评分):判断用户是否具有违约风险,准确率通常优于单一的逻辑回归和决策树。
- 特征工程与特征筛选:利用随机森林输出的特征重要性,剔除无关冗余特征,为其他模型做降维铺垫。
- 遥感与生态学:处理多波段遥感影像,进行土地覆盖分类和植被类型识别。
- 医疗诊断辅助:基于多个临床指标对疾病风险进行综合预测。
- 推荐系统:作为排序模型或点击率预测的基模型之一。
六、随机森林核心 API 速查
6.1 导包方式
分类任务与回归任务分别从 sklearn.ensemble 中导入对应的类:
- 分类:
RandomForestClassifier - 回归:
RandomForestRegressor
其他常配套使用的模块包括:数据集划分(train_test_split)、交叉验证(cross_val_score)以及各类评估指标(分类报告、混淆矩阵、MSE、R² 等)。
6.2 核心参数详解
随机森林的参数可分为三类:树结构参数、随机性参数、工程优化参数。
| 参数名 | 类型 | 默认值 | 说明 |
|---|---|---|---|
| 树结构参数 | |||
n_estimators | int | 100 | 森林中树的数量,越多模型越稳定,但训练和推理越慢。通常 100~300 即可达到较好效果 |
max_depth | int / None | None | 每棵树的最大深度,默认 None 表示不限制(树会完全生长),推荐手动设置(如 10~30)以防过拟合 |
max_leaf_nodes | int / None | None | 树的最大叶节点数,限制叶节点数量可有效控制模型复杂度,防止过拟合 |
min_samples_split | int / float | 2 | 内部节点再分裂所需的最小样本数,值越大,树越保守,过拟合风险越低 |
min_samples_leaf | int / float | 1 | 叶节点所需的最小样本数,值越大,树越平滑 |
max_features | int / str / float | "sqrt" | 每次分裂时随机考虑的特征数,分类推荐 "sqrt"(即总特征数的平方根),回归推荐总特征数的 1/3 |
| 随机性参数 | |||
bootstrap | bool | True | 是否采用有放回抽样,True 即为 Bagging 方式,False 则每棵树使用全部样本(易过拟合) |
oob_score | bool | False | 是否使用袋外样本计算验证分数,设为 True 可省去额外划分验证集 |
random_state | int / None | None | 随机种子,固定后结果可复现 |
| 工程优化参数 | |||
n_jobs | int | None | 并行训练的 CPU 核心数,设为 -1 表示使用全部核心 |
verbose | int | 0 | 训练过程日志输出级别,0 不输出,1 输出进度条 |
warm_start | bool | False | 是否复用前一次训练结果增量训练,适合在逐步增加 n_estimators 时使用 |
6.3 常用属性
训练完成后,可通过以下属性获取模型内部信息:
| 属性名 | 说明 |
|---|---|
feature_importances_ | 特征重要性(最常用),返回长度为特征数的数组,值越大表示该特征对预测越关键 |
oob_score_ | 袋外评分(需事先设置 oob_score=True),可作为模型泛化能力的参考指标 |
estimators_ | 森林中所有决策树对象的列表,可单独查看每棵树的结构 |
n_features_in_ | 训练时使用的特征数量 |
classes_ | 分类任务中所有类别的标签(分类模型专属) |
n_classes_ | 分类任务中的类别数量(分类模型专属) |
6.4 常用方法
| 方法名 | 适用任务 | 说明 |
|---|---|---|
fit(X, y) | 分类 / 回归 | 训练模型,一切开始的地方 |
predict(X) | 分类 / 回归 | 预测新样本的类别(分类)或数值(回归) |
predict_proba(X) | 分类专属 | 预测新样本属于每个类别的概率,输出如 [[0.1, 0.9]] 表示 10% 概率为类别 0,90% 为类别 1 |
predict_log_proba(X) | 分类专属 | 概率的对数形式,数值更稳定,适合概率连乘场景 |
score(X, y) | 分类 / 回归 | 返回评估分数:分类返回准确率,回归返回决定系数(R²) |
apply(X) | 分类 / 回归 | 返回每个样本在每棵树中落入的叶节点索引,可用于理解样本在森林中的路径 |
七、实战案例:垃圾邮件识别
7.1 案例背景
垃圾邮件识别是机器学习在文本处理领域的经典应用。本案例使用的 spambase 数据集(共 4601 条样本,57 个特征),构建随机森林分类器,实现邮件的自动分类。
7.2 完整代码
import matplotlib.pyplot as plt
import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split, cross_val_score
from sklearn.ensemble import RandomForestClassifier
from sklearn import metrics


def cm_plot(yt, yp):
    from sklearn.metrics import confusion_matrix
    import matplotlib.pyplot as plt
    cm = confusion_matrix(yt, yp)
    plt.matshow(cm, cmap=plt.cm.Reds)
    plt.colorbar()
    for x_ in range(len(cm)):
        for y_ in range(len(cm)):
            plt.annotate(cm[x_, y_], xy=(y_, x_), va='center', ha='center')
            plt.ylabel('True label')
            plt.xlabel('Predicted label')
    return plt


# ===================导入数据=========================
datas = pd.read_csv('spambase.csv')
X = datas.iloc[:, :-1]
y = datas.iloc[:, -1]

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# ===================交叉验证选择最优深度=========================
depth_range = range(1, 30)
best_score = -1
best_depth = None

print("===== 交叉验证(11折)=====")
for depth in depth_range:
    rf = RandomForestClassifier(
        n_estimators=100,
        max_depth=depth,
        random_state=42,
        n_jobs=-2
    )
    scores = cross_val_score(rf, X_train, y_train, cv=11, scoring='recall')
    score_mean = np.mean(scores)
    print(f'depth={depth:2d}, recall={score_mean:.4f} ')

    if score_mean > best_score:
        best_score = score_mean
        best_depth = depth

print(f'\n最优深度: {best_depth}, 最优召回率: {best_score:.4f}')

# ===================使用最优深度训练模型=========================

rf = RandomForestClassifier(
    n_estimators=100,
    max_depth=best_depth,
    random_state=42,
    n_jobs=-2
)
rf.fit(X_train, y_train)

# ===================训练集评估=========================

train_pred = rf.predict(X_train)
print("\n训练集分类报告:")
print(metrics.classification_report(y_train, train_pred))
cm_plot(y_train, train_pred).show()

# ===================测试集评估=========================
test_pred = rf.predict(X_test)
print("\n测试集分类报告:")
print(metrics.classification_report(y_test, test_pred))
cm_plot(y_test, test_pred).show()

# ===================特征重要性分析=========================

importances = rf.feature_importances_
im = pd.DataFrame(importances, columns=["importances"])
clos = datas.columns
clos_1 = clos.values
clos_2 = clos_1.tolist()
clos = clos_2[0:-1]
im['clos'] = clos

im = im.sort_values(by=['importances'], ascending=False)[:10]

index = range(len(im))
plt.yticks(index, im.clos)
plt.barh(index, im['importances'])
plt.show()
输出示例:
===== 交叉验证(11折)=====
depth= 1, recall=0.5680
depth= 2, recall=0.7498
depth= 3, recall=0.8027
depth= 4, recall=0.8330
······
depth=25, recall=0.9225
depth=26, recall=0.9246
depth=27, recall=0.9211
depth=28, recall=0.9239
depth=29, recall=0.9183

最优深度: 23, 最优召回率: 0.9274

训练集分类报告:
              precision    recall  f1-score   support

           0       1.00      1.00      1.00      2258
           1       1.00      0.99      1.00      1419

    accuracy                           1.00      3677
   macro avg       1.00      1.00      1.00      3677
weighted avg       1.00      1.00      1.00      3677


测试集分类报告:
              precision    recall  f1-score   support

           0       0.94      0.98      0.96       527
           1       0.97      0.92      0.94       393

    accuracy                           0.95       920
   macro avg       0.95      0.95      0.95       920
weighted avg       0.95      0.95      0.95       920
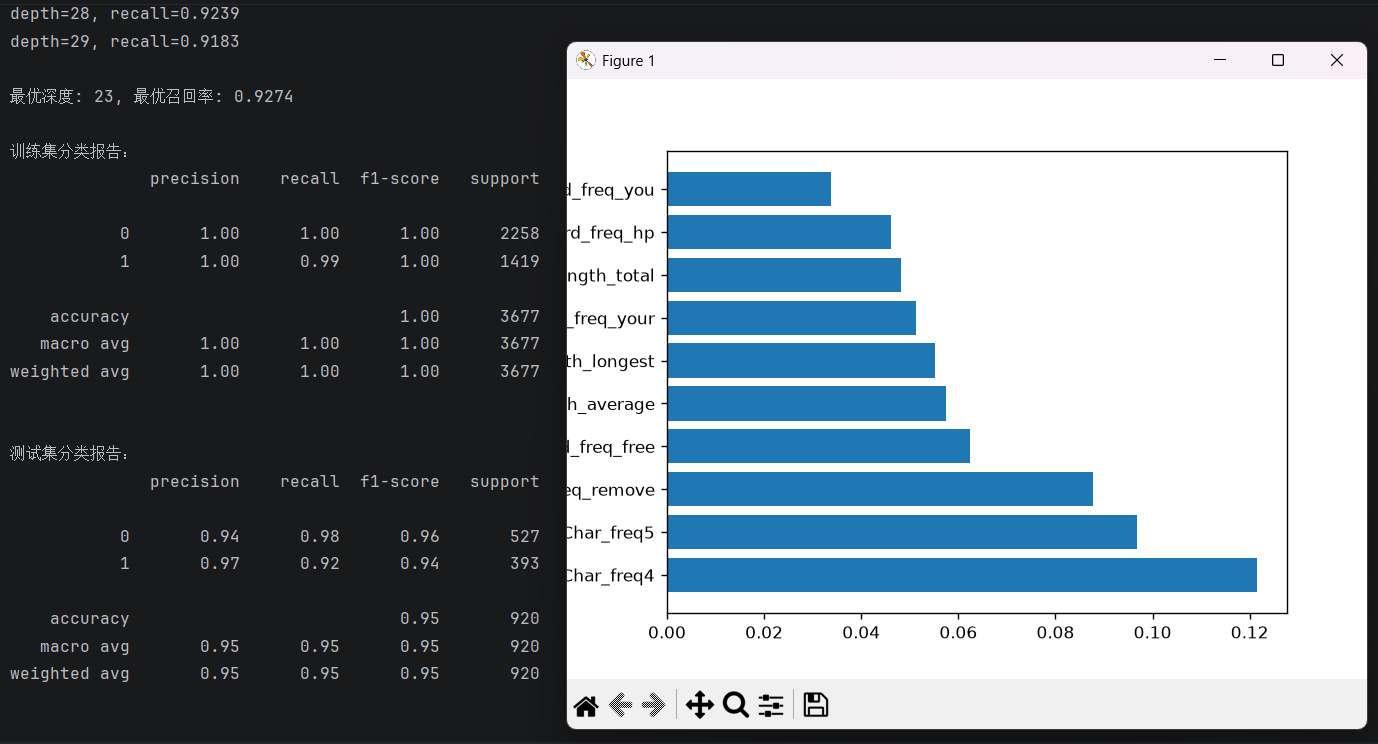
7.3 关键步骤说明
| 步骤 | 说明 |
|---|---|
| 数据加载 | Spambase 数据集共 4601 条样本,57 个特征,最后一列为标签(1 表示垃圾邮件,0 表示正常邮件) |
| 交叉验证选参 | 遍历深度 1~29,采用 11 折交叉验证,以召回率(recall)为评估指标,选出最优深度 |
| 模型训练 | 固定最优深度,树数量设为 100,其余参数保持默认 |
| 模型评估 | 分别输出训练集和测试集的分类报告,并通过混淆矩阵可视化预测结果 |
| 特征重要性 | 提取 Top 10 重要特征并可视化,帮助理解哪些邮件特征最能区分垃圾邮件 |
八、总结
核心知识点速查
| 知识点 | 关键概念 |
|---|---|
| 集成学习 | 组合多个弱学习器构建强学习器 |
| Bagging | 有放回抽样构建训练集 |
| 特征随机 | 分裂时仅考虑部分特征 |
| 最终决策 | 多数投票(分类)/ 平均(回归) |
| 特征重要性 | 基于 Gini 不纯度减少量汇总 |
核心 API 一览
| 用途 | 对应模块 / 方法 |
|---|---|
| 分类模型 | sklearn.ensemble.RandomForestClassifier |
| 回归模型 | sklearn.ensemble.RandomForestRegressor |
| 训练 | fit(X, y) |
| 预测 | predict(X) |
| 概率预测(分类) | predict_proba(X) |
| 特征重要性 | feature_importances_ |
注意事项
| 要点 | 说明 |
|---|---|
| 无需剪枝 | 双重随机性替代了剪枝操作 |
| 树的数量 | 并非越多越好,100~300 后收益递减 |
| 单机瓶颈 | 树过多时内存和推理时间上升 |
| 随机种子 | 固定 random_state 确保结果可复现 |
| 特征数选择 | 分类用 sqrt,回归用 1/3 总特征数 |
系列直达
- 上篇:机器学习入门:决策树(Decision Tree)
- 本篇:机器学习入门:随机森林(Random Forest)(本文)
- 下篇:机器学习入门:朴素贝叶斯(Naive Bayes)
更多推荐



 9
 0
- 0


 已为社区贡献15条内容

所有评论(0)