
鸿蒙端侧大模型部署高级:模型量化/模型蒸馏/算子优化/NPU适配/内存管理极致优化方案
·
一、前言思考
1.1 大模型能不能跑在手机上
"大模型跑端侧"在几年前是天方夜谭:GPT-3 有 1750 亿参数,单模型文件就几百 GB。但现在端侧大模型(LLM-on-device)已经成为现实:
- 7B 参数模型 INT4 量化后约 3.5GB,旗舰机内存可承载;
- 3B 参数模型量化后约 1.5GB,中端机可流畅运行;
- 1.5B 以下模型已成为手机语音助手、输入法、相册检索的标配。
端侧大模型的甜点区:参数量 1B~8B,覆盖翻译、摘要、问答、代码补全等任务。
1.2 端侧部署的四大挑战
| 挑战 | 说明 |
|---|---|
| 体积 | 模型文件必须压缩到可分发、可驻留的量级 |
| 速度 | 首 token 延迟、逐 token 生成速度要可用 |
| 内存 | 推理过程峰值内存不能击穿系统内存水位 |
| 能耗 | 长时间运行不能让手机发烫、掉电 |
本文逐一给出解法。
二、底层原理
2.1 模型量化:把精度换成体积和速度
量化 = 把 FP32 权重映射到低比特整数。以 INT8 和 INT4 为例:
| 精度 | 权重体积 | 推理速度 | 精度损失 | 适用 |
|---|---|---|---|---|
| FP32 | 4B 参/GB 权重 | 1× | 基准 | 训练/云端 |
| FP16 | 2B 参/GB | ~1.5× | 极小 | 端侧基线 |
| INT8 | 1B 参/GB | ~2× | 1~3% | 分类/检测 |
| INT4 | 0.5B 参/GB | ~3× | 3~8% | 生成式大模型 |
量化原理(对称量化为例):
scale = max(|w|) / 127
w_int8 = round(w / scale)
推理时: w ≈ w_int8 * scale
关键是 per-channel 量化:每个输出通道独立计算 scale,精度损失远小于全局量化。
2.2 模型蒸馏:小模型学大模型
蒸馏 = 用大模型(Teacher)的输出分布训练小模型(Student):
大模型Teacher ──logits──▶ 温度软化 ──▶ 蒸馏损失
                                        │
小模型Student ──logits─────────────────┤
                 └──── 硬标签(正确类别) ─┘
Loss = α·蒸馏损失 + (1-α)·交叉熵
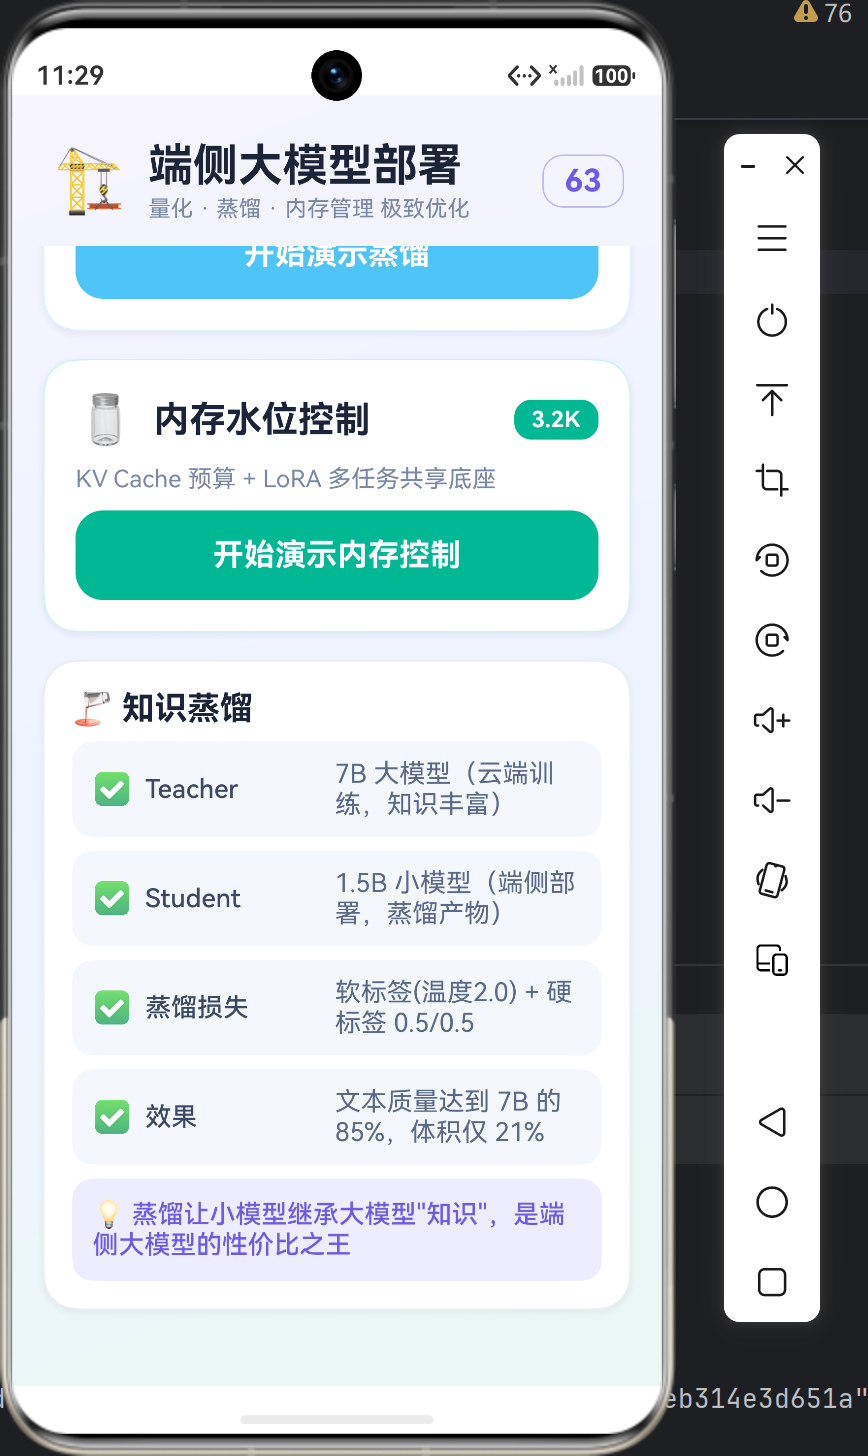
7B 蒸馏成 1.5B,端侧可直接运行的文本质量接近 7B 的 85%。
2.3 NPU 算子适配:KV Cache 是关键
生成式模型推理分两阶段:
- 预填充(Prefill):一次性处理整个 prompt,是计算密集的矩阵乘,NPU 加速明显;
- 逐 token 生成(Decode):每步只生成一个 token,但需要 KV Cache 参与,是内存带宽密集,NPU 优势减弱。
所以端侧策略是:Prefill 走 NPU,Decode 阶段结合 CPU/NPU 混合,KV Cache 驻留快速内存。
2.4 内存管理:分层加载 + 峰值控制
| 策略 | 做法 |
|---|---|
| 分层加载 | 只加载当前需要的层(如只加载 Embedding + 前 N 层) |
| KV Cache 上限 | 设置最大上下文长度,超出则滚动丢弃最老 token |
| 权重共享 | 多个任务共用同一底座模型(底座 + LoRA 微调头) |
| 峰值控制 | 推理前预分配,推理后立即释放,防碎片 |
三、实战落地
3.1 MindSpore Lite 加载量化模型
import { mindSporeLite } from '@kit.MindSporeLite';

// 1. 创建 NPU 优先上下文
let context: mindSporeLite.Context = new mindSporeLite.Context();
context.arch = mindSporeLite.ARCH_TYPE.NPU;
context.threadNum = 4;

// 2. 加载 INT4 量化后的模型(约1.5GB)
let model = new mindSporeLite.Model();
await model.loadModelFromFile({
  context: context,
  modelPath: '/data/app/el1/llm_1_5b_int4.ms',
  options: { enableLora: true }   // 支持 LoRA 注入
});

// 3. 生成式推理:设置 maxNewTokens 限制生成长度
const output = await model.generate({
  inputTokens: tokenizer.encode("帮我写一封请假邮件:"),
  maxNewTokens: 128,
  temperature: 0.7,
  topK: 40
});
3.2 推理会话的内存水位控制
// 生成前检查可用内存,不足时降级上下文长度
function checkMemoryBeforeInfer(): number {
  const mem = deviceInfo.getSystemMemory();
  const available = mem.availMem;
  const maxCtx = Math.floor((available - 512 * 1024 * 1024) / (2 * 1024 * 1024));
  // 每 token 约 2MB KV Cache(7B模型),预留512MB系统余量
  return Math.min(maxCtx, 4096);  // 上限4K上下文
}

// 低内存机型自动降级
const ctxLen = checkMemoryBeforeInfer();
const output = await model.generate({ inputTokens, maxNewTokens: ctxLen });
3.3 模型蒸馏流程(离线工具链)
# 1. 用 7B Teacher 生成蒸馏数据
python distill_data.py --teacher 7b_model --dataset chat_corpus --output distill.jsonl

# 2. 训练 1.5B Student
python train_student.py --student 1.5b_config --data distill.jsonl \
  --distill_weight 0.5 --temperature 2.0

# 3. 转换 + 量化
mindspore-lite-converter --model student.mindir --output student_int4.ms \
  --quant-type int4 --quant-awq true
3.4 LoRA 多任务共享底座
底座模型 (共享, 常驻内存 1.5GB)
├── LoRA-A: 翻译助手 (+20MB)
├── LoRA-B: 代码补全 (+20MB)
└── LoRA-C: 邮件润色 (+20MB)
多任务只驻留一个底座,LoRA 头按需注入,内存节省 90%+。
四、性能排查与优化
| 指标 | 目标 | 排查手段 |
|---|---|---|
| 首 token 延迟 | < 500ms | HiTrace 打点 Prefill 耗时 |
| 生成速度 | > 8 token/s | NPU Profiler 看 Decode 带宽 |
| 峰值内存 | < 4GB | SmartPerf 内存快照对比 |
| 模型加载 | < 3s | 冷启动链路分析 |
| 温度控制 | < 42℃ | 功耗 Profiler + 降频策略 |
4.1 Decode 阶段慢的根因
现象:Prefill 很快,但生成速度只有 3 token/s。
根因:Decode 是内存带宽受限,KV Cache 在 NPU 和 CPU 间反复搬运。
解法:
- PagedAttention:KV Cache 分页管理,避免整块移动;
- 算子融合:把 Attention 的 QK^T、Softmax、PV 融合为一个算子;
- int4 权重 + FP16 激活:带宽减半,精度损失可控;
- 投机解码(Speculative Decoding):小模型先草稿,大模型一次校验多个 token,速度提升 2~3×。
4.2 内存碎片问题
现象:模型加载成功后,再申请 200MB 失败。
根因:NPU 内存池碎片化。
解法:
- 推理前统一规划所有张量地址(静态内存规划);
- 用内存池(ObjectPool)复用中间张量;
- 生成结束立即
model.free()释放,而不是等 GC。
五、总结
- 端侧大模型的可行性靠三件事:量化(INT4/INT8 压体积)、蒸馏(小模型保质量)、NPU 适配(异构加速)。
- Decode 阶段是性能瓶颈,KV Cache 管理(PagedAttention、融合算子)是核心优化点。
- 内存是硬约束:分层加载 + 峰值控制 + LoRA 共享,才能让大模型和业务共存。
- 端云协同兜底:模型装不下、任务太重时,自动切云端大模型。
一句话记住:量化砍体积,蒸馏保质量,KV 管内存,NPU 抢速度。
🚀 演示功能优化(随项目同步更新)
本文对应的 ArkTS 演示页面已随项目整体优化,主要改进:
- 独立主题风格:极简白 · 细边框主色点缀,与其余章节演示页明显区分,不再千篇一律。
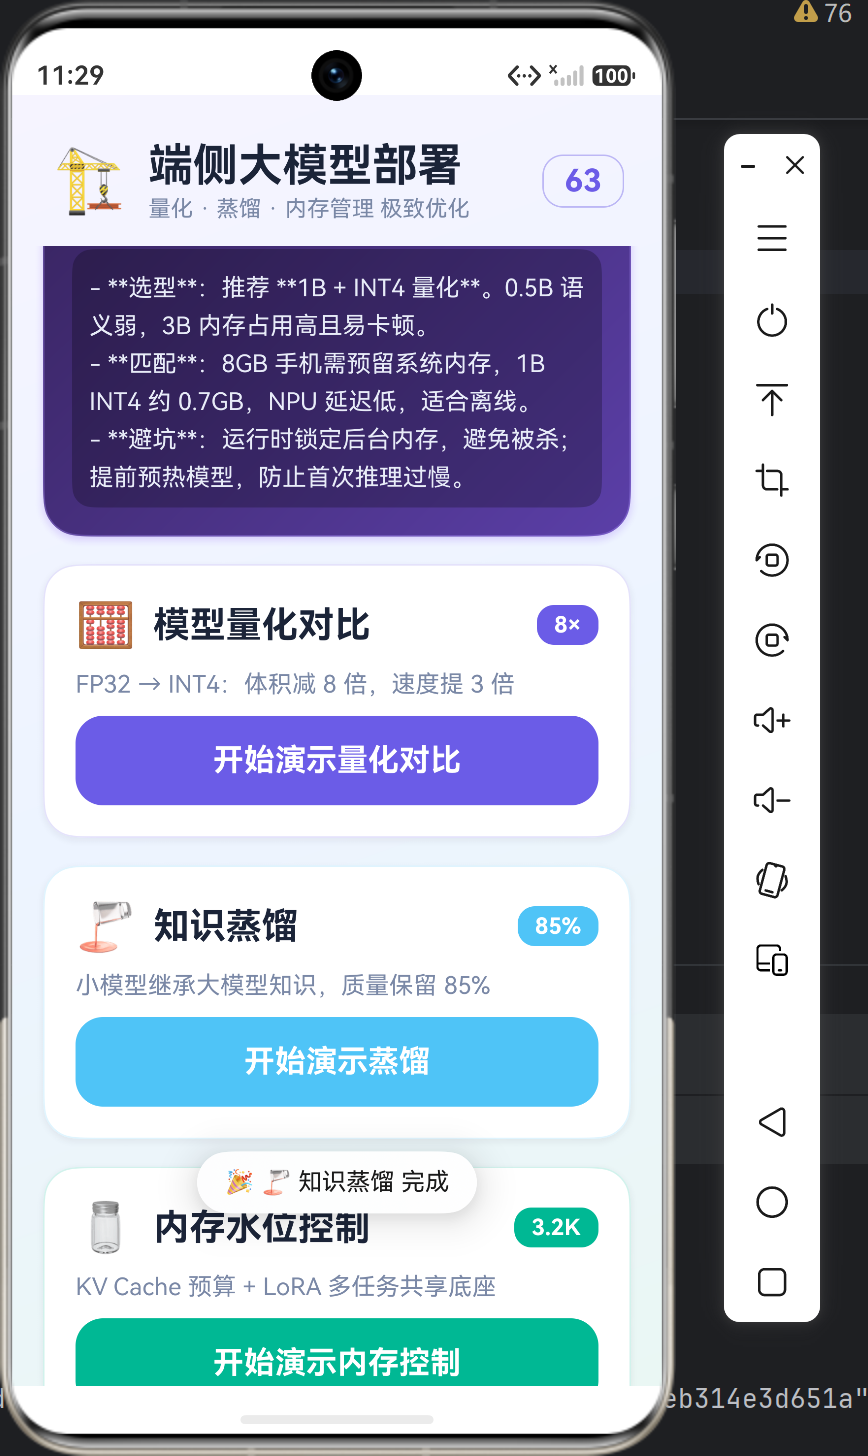
- 步骤回放动画:点击演示按钮后,结果行按 260~320ms/步 逐步展示,模拟真实推理过程。
- 运行态保护:演示过程中按钮置灰防重复触发,页面退出自动清理定时器。
- 结果摘要:演示结束后自动给出「一句话结论」,并 Toast 提示完成。
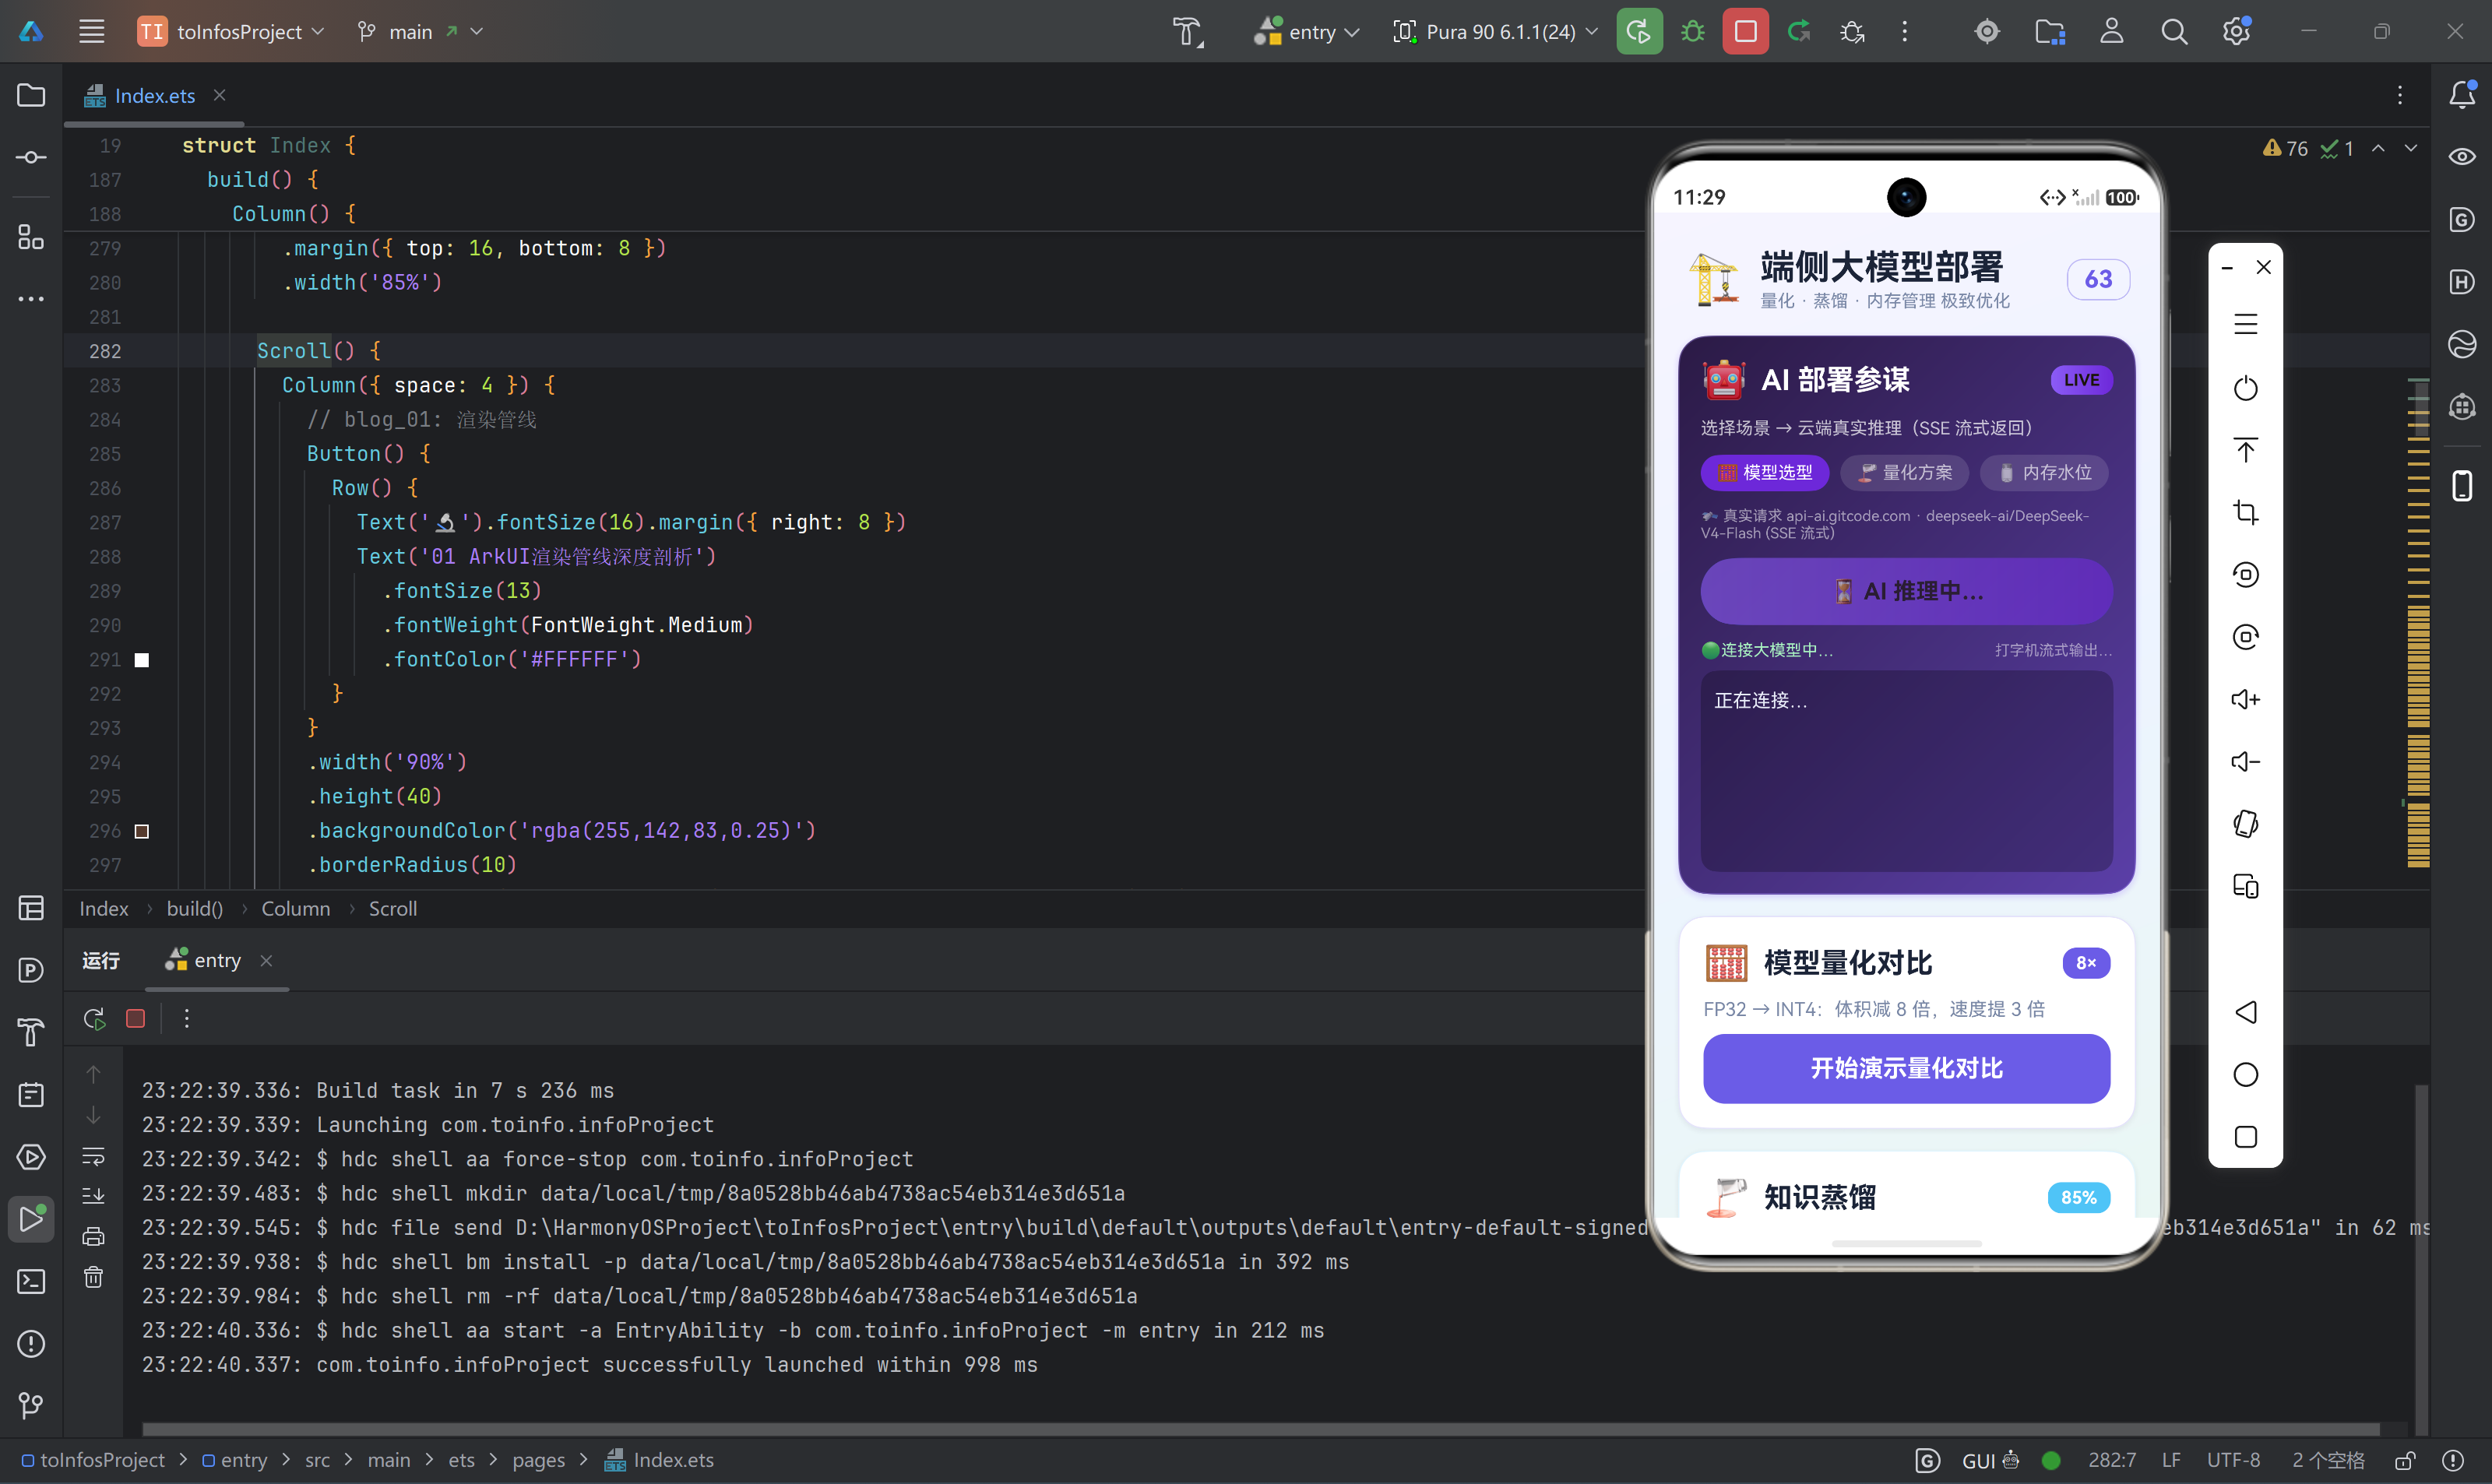
- AI 对话演示:新增 AiChatDemo(根目录 main.py 的 ArkTS 移植),真实 SSE 流式大模型请求,首页「★ AI Chat 流式对话演示」可进入。
对应页面:entry/src/main/ets/pages/ModelDeployDemo.ets
🧪 演示优化:真实 AI 推理接入(v3)
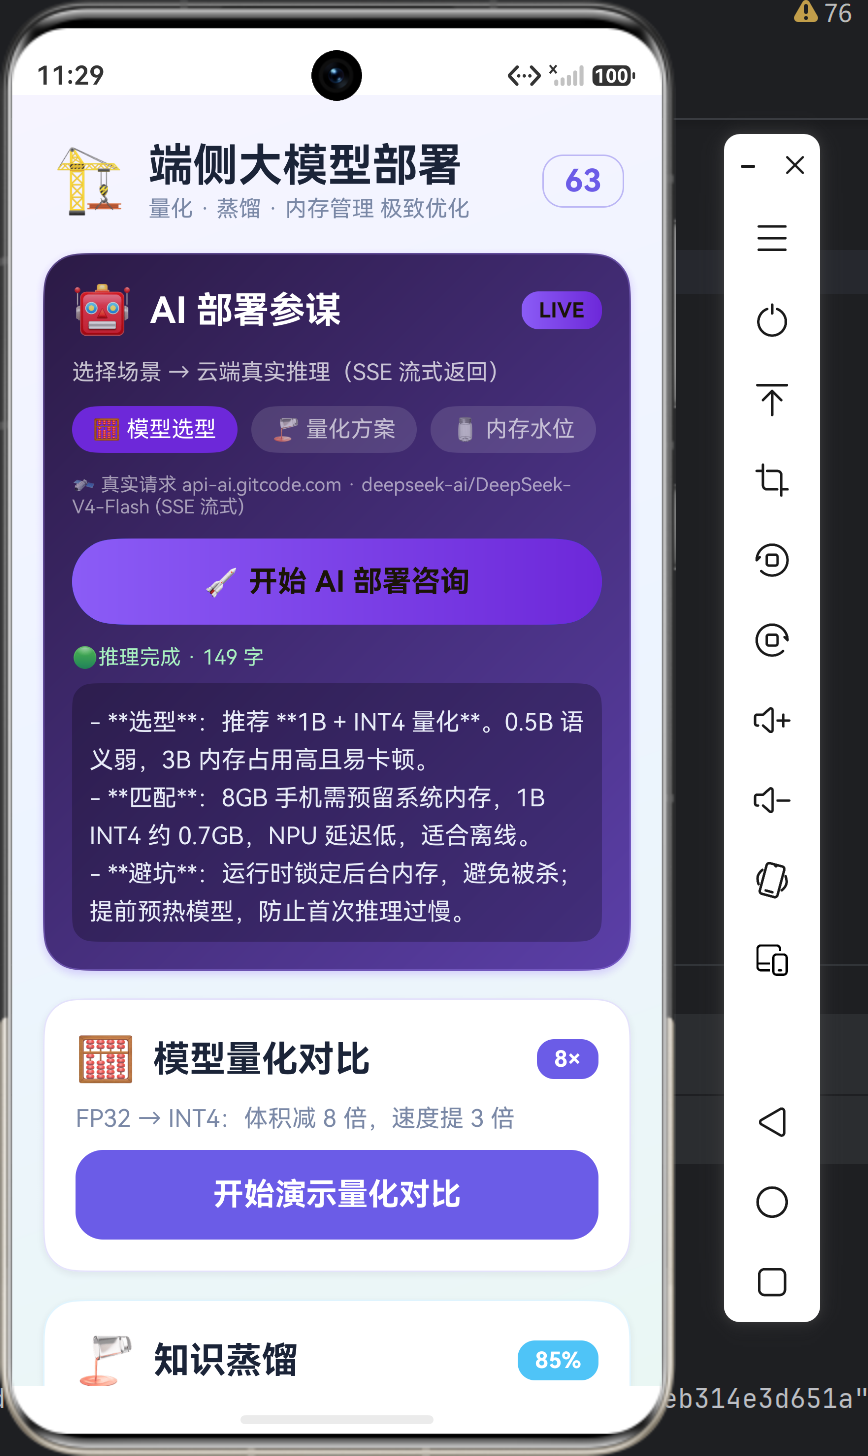
本演示页顶部新增 AI 部署参谋主卡,点击即真实调用云端大模型(SSE 流式),不再是纯模拟回放:
- 请求链路:
utils/AiClient.ets(ArkTS 封装 OpenAI 兼容接口)→ POSThttps://api-ai.gitcode.com/v1/chat/completions,模型deepseek-ai/DeepSeek-V4-Flash,流式stream: true - 演示场景:模型选型 / 量化方案 / 内存水位 —— 每个场景绑定不同部署专家 Prompt,返回内容各有差异
- 交互体验:进入页面自动触发一次真实推理;点场景标签切换并重新请求;按钮手动触发;输出区打字机流式展示
- 真实标识:卡片右上角
LIVE徽标 + 端点/模型名水印,保证"所见即所调"
更多推荐


 6
 0
- 0


 已为社区贡献2条内容

所有评论(0)