
从一到无穷大 #76:大模型可观测性——从性能诊断到稳定性闭环与统一数据底座
MegaScale 在一段持续数周的万卡训练里经历了 100 多次重启。ARGUS 记录过另一个更隐蔽的案例:一个 4096 GPU 任务没有挂,只是间歇性变慢,最后多花了约 23,758 GPU-hours,占训练算力的 7%。到了 AEGIS-SDC,问题又换了一种形态:系统在 3500 万 GPU-hours 的生产训练中发现 18 起 Silent Data Corruption,训练进程可以继续跑,硬件也没有给出足够明确的错误,计算结果已经不可信了。
这三个数字分别来自 MegaScale、ARGUS 和 Safeguarding LLM Training at Scale。把它们放在一起,大模型训练的稳定性问题大致有三种:任务停了;任务还在跑,但是被一个慢 Rank 拖着;任务看起来正常,某一步已经算错。
同步训练会把三类问题都放大。一张卡挂掉,整个通信组无法前进;一张卡慢 10%,其余 Rank 会在 Collective 或 Pipeline 依赖上等它;一张卡产生错误 Tensor,错误可能随着梯度同步、Optimizer 更新和后续 Checkpoint 继续传播。传统资源监控能看到 GPU 利用率、温度、网络吞吐和进程状态,却很难回答到底是谁先出问题、影响了哪一段训练、已有状态还能不能继续使用。
把 2019 到 2026 这批论文按时间排开,我看到的是观测结果离训练控制面越来越近。早期系统先解释时间花在哪里,随后开始自动定位 Rank、链路、Collective 和 Kernel;再往后,诊断结果进入节点隔离、拓扑调整、Checkpoint 恢复和重新准入。到了 2026,性能之外又补出一张 Correctness Plane,用来确认这一步到底有没有算对。Profiler 多记了哪些字段,只是这条演进里的实现细节。
本文讨论训练侧为主的这条演进。推理只看 StriaTrace,因为它刚好说明训练的方法不能原样搬到在线推理。调度器、Checkpoint Manager 和续训执行器本身也不属于可观测系统;它们需要可观测性给出足够强的证据,才能决定是否继续、如何继续,以及从哪个状态继续。这条边界后面会反复出现。
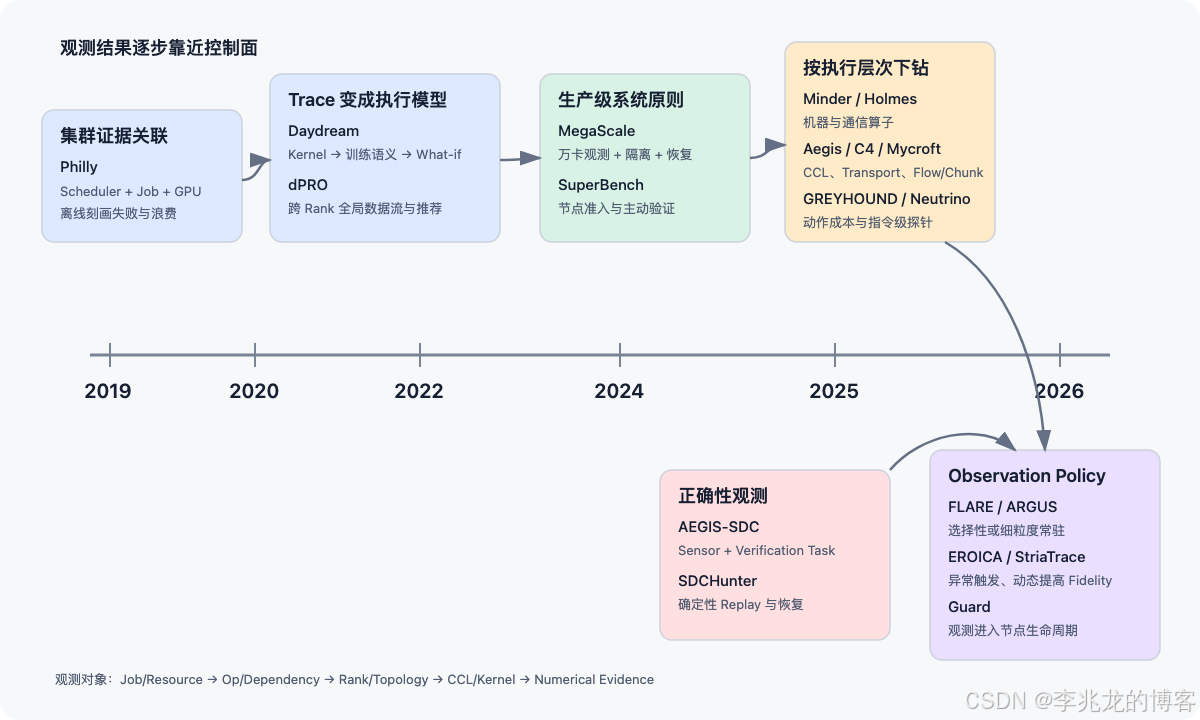
图 1:论文之间的连线表示方法位置和能力互补,不表示代码继承或论文作者声明的引用关系。
1 2019—2026:观测结果逐步靠近训练控制面
1.1 从 Trace 到可操作的执行模型
2019 年的 Analysis of Large-Scale Multi-Tenant GPU Clusters for DNN Training Workloads 研究的是微软 Philly 集群。论文把两个月的调度日志、每分钟资源指标、作业日志和训练 Loss 放到一起分析,覆盖 96,260 个任务。最终失败和被用户杀掉的作业消耗了约 55% GPU 时间,分配出去的 GPU 周期又有约 47.7% 没被实际利用。
Philly 还不是一个在线诊断系统。它的基本对象是 Job、GPU、Queue 和 Failure Category,主要输出也是离线统计。不过这篇论文已经碰到了后面所有工作的起点:只看 Scheduler 不知道训练进行到哪里,只看 GPU Utilization 不知道任务为什么没推进,只看错误日志又不知道失败之前浪费了多少算力。调度、资源和训练进度必须关联起来,Retry Policy 也不能对所有错误一视同仁。
2020 年的 Daydream 把视角从集群日志移到了单次训练的执行路径。它使用 CUPTI 采集 CPU/GPU Task、CUDA Stream、Kernel Launch 和 Memory Copy,再由框架侧的 Layer 时间戳把这些低层事件映射回 DNN 语义,最后构建一张细粒度 Dependency Graph。
有了图,由 Trace 派生出的执行模型就可以被修改。Daydream 保留原始事件作为观测输入,再用图变换描述 Mixed Precision、Kernel Fusion、Layer Fusion、Communication Scheduling 和 Distributed Training 等优化,在真正改代码之前模拟新的执行时间。它回答的是一个比热点分析更接近决策的问题:如果动这里,整个迭代会怎样。论文的实验仍然只有 4 台机器、16 张 RTX 2080 Ti,而且一次 Profile 后离线模拟;这套思路本身很重要,Trace 已经派生出了一个可以干预的运行模型。
2022 年的 dPRO 又把图扩展到了分布式训练。各 Worker 的计算 Trace、Tensor 级 SEND/RECV 与 Collective Trace 被合成 Global Data-flow Graph,系统还需要根据通信依赖修正跨机时钟和不准确的 Receive 时间。随后 dPRO Replay 全局执行、计算 Critical Path,并搜索 Computation、Communication 和 Memory 优化的组合。
dPRO 在最多 128 张 V100 上把多数配置的 Replay 误差控制在 5% 左右,搜索结果最高带来 3.48 倍加速;Profiling 本身约有 5.86% 开销。它已经形成了 观测 → 诊断 → 推荐 的半闭环,推荐结果通常仍要重启训练后才能应用,目标也是吞吐和内存,不含故障恢复与数值正确性。
所以 2019—2022 年完成的工作可以压成一条很具体的链路:Scheduler/Job Log 与分钟级 Resource Metric 先被关联,Kernel Execution Event 再被还原为训练语义,最后变成跨 Worker 的执行模型和 What-if 工具。这个阶段解决了如何理解一次训练,尚未解决如何在万卡任务里常驻、怎样实时找到偶发问题,以及动作执行后如何验证训练真的恢复。
1.2 万卡以后,可观测性进入系统设计
MegaScale 在 2024 年把 in-depth observability 列为万卡训练系统的设计原则。它同时保留 Executor Heartbeat、stdout/stderr、RDMA Traffic、毫秒级网络指标和关键代码段的 CUDA Event。CUDA Event 数据按 Rank 汇聚成 Heatmap 和 Timeline,工程师可以把 Forward、Backward、DP/TP/PP Communication、Pipeline Bubble 和 MFU 放在同一个时间轴上看。
更关键的是,这些信号进入了 Driver 的恢复状态机。Driver 检测到异常、Heartbeat 超时或网络流量停止后,暂停全部 Executor,执行轻量 RDMA、RNIC、GPU All-to-all、NCCL/AllReduce 自检,隔离故障节点,再补入健康节点并从最近的 Checkpoint 恢复。生产记录里,诊断测试平均少于 10 分钟,从 Checkpoint 追平中断前进度少于 15 分钟。论文报告超过 90% 的软硬件故障可以自动检测、定位和恢复。
这里要留一个边界。MegaScale 对常见显式故障已经做到了自动闭环,概率性硬件异常和复杂 Straggler 仍要依赖人工分析;论文也没有提供 SDC 所需的 Tensor Checksum、Numerical Invariant 或 Checkpoint 污染判断。Loss 最后收敛,不能反推训练中间没有出现过局部静默错误。
同年的 SuperBench 把诊断向作业之前推了一步。它不等用户任务踩中坏节点,先用 GPU Kernel Launch、GEMM、GPU Burn、PCIe/NVLink/IB/NCCL、通信计算重叠和端到端模型 Benchmark 验证基础设施。Selector 根据节点 Uptime、历史 Incident 和预测风险选择一组有成本约束的测试,Validator 学习同型节点的健康分布,结果再交给编排和维修系统。
SuperBench 在 Azure 运行两年,累计验证数十万 GPU。它建立的是 Healthy Pool:节点加入集群、发生 Incident 或风险升高时先做验证,只有通过的节点才值得分配给昂贵训练。具体训练 Step 的偶发慢点仍要交给运行时诊断。恢复系统同样需要这层能力。诊断出坏节点以后,随便换一台未经验证的机器,可能只是把故障换了一个位置。
Visual Diagnostics of Parallel Performance in Training Large-Scale DNN Models 代表了另一个当时仍然重要的方向。系统把 Parallelism Strategy、计算图、Operator Profile、通信量、内存与设备拓扑放进 Cluster、Device 和 Block 三层交互视图,帮助专家区分慢设备、Stage Imbalance、Collective Wait 和慢链路。论文的数据处理仍然离线,最终判断依赖工程师。
这篇可视化论文的价值不在界面本身。一个 300 ms 的等待放在 Timeline 里只能说明有等待,放回 Pipeline Stage、并行组和上下游依赖后,才知道它是根因还是被别人拖住的症状。后面的自动 RCA 其实是在把专家使用这些视图时的判断过程,逐步编译成在线算法。
到了 2024 年,约束已经很明确:覆盖全集群的粗指标可以长期运行,细 Trace 又能解释问题,两者之间隔着数据量、采集开销、跨 Rank 语义和分析延迟。生产系统得同时付这几笔账。
1.3 诊断沿执行栈下钻
2025 年出现了一批看起来很像、实际观测层次差异很大的系统。把它们按论文标题逐篇复述很容易乱。我更愿意按系统到底能看见哪一层来排。
1.3.1 哪台机器异常
Minder 使用 CPU、内存、磁盘、TCP/RDMA、PFC、GPU 利用率、功耗、温度、PCIe 和 NVLink 等机器指标。它利用同一个大规模训练任务里的机器行为应当近似一致这一点,以 LSTM-VAE 去噪,再通过机器间距离、Z-score 和连续异常窗口找 Faulty Machine。
Minder 部署超过一年,九个月验证了 150 个运行时故障,Precision 为 0.904、Recall 为 0.883。论文里经常被引用的 3.6 秒是一次后端分析调用的平均耗时,不是从故障发生到完成诊断的端到端时间;系统还要等待周期拉取和连续异常窗口。这个区别不大好看,但必须写清楚。
机器级指标便宜、覆盖广,也容易接入换机和重启。它的盲区同样明显。BSP 同步会让一个故障沿通信依赖传播,最后整组机器指标都不正常;全体等比例变慢、持续很短的 Network Jitter、只有训练语义才能解释的软件问题也不容易命中。
1.3.2 谁最先拖慢同步组
Holmes 把观测点推进到 Communication Operator。Logger 记录 Collective 类型、Duration、Timestamp、Communicator 和 Rank,Random Forest 先识别异常算子,Communication Operator Graph 再表达算子与并行组之间的依赖,最后跨迭代给可疑 GPU、链路或交换机排序。
它的插桩开销在 1024—6144 GPU 配置中约为 0.064%—0.19%,一次 Operator 不足 2 微秒。渐进拉取又把单次迭代日志从 24.36 GB 降到 0.84 GB。8192 GPU 条件下约 30.3 秒的定位结果来自生产网络上的 CPU 日志生成仿真测试床,不是一项真实占用 8192 GPU 的在线训练实验;准确率也从总体 97.21% 降到了这一规模下的 88.2%。规模越大,正常噪声和异常传播越难分。
Holmes 说明同步有两面。一个慢 Rank 会让等待传播,看起来像很多设备同时出问题;周期性的 Collective、相同并行角色和重复迭代又提供了天然参照,系统可以沿图反推最早异常源。
1.3.3 Collective 里面卡在哪里
Evolution of Aegis 展示了生产诊断从外围系统进入 CCL 的过程。第一阶段依靠训练日志、系统和网络指标、Pingmesh 与离线硬件检测,第二阶段开始修改 Collective Communication Library,为每个 Rank 记录 Collective Launch、Work Request、Work Completion、Operator Duration 和近期吞吐。
如果某个 Rank 连 Collective 都没有 Launch,问题更可能在计算或上层软件;Launch 了但 Work Request/Completion 没推进,范围就收到了通信侧。Aegis 运行一年后,论文报告诊断导致的 Idle Time 下降超过 97%,训练 Restart 数下降 84%,Performance Degradation 下降 71%。这些是生产前后结果,不是同一公开 Incident Set 上的横向 Benchmark。Aegis 的在线链路会定位并隔离 Culprit,随后进入 Repair/Restart;更深的底层软硬件原因仍留给离线处理,它也没有 Checkpoint Lineage 和 Resume 后状态验证。
C4 继续在 Communicator、Operation 和 Transport 三层记录 Rank、Collective、算法、数据量、QP、源/目的地址和传输时长。它利用 BSP 和 Ring AllReduce 的依赖,把异常矩阵中的单元、行和列映射到连接、发送端或接收端,再追到最早没有准备好的 Rank。C4D 的结果可以通知 Job Steering 隔离节点,并从最近有效 Checkpoint 重启;C4P 则把观察结果用于坏链路规避和 Elephant Flow 路径调整。
C4 报告,在一个 2400 GPU、持续一个多月的 175B 任务中,Error-induced Downtime 占总训练时间的比例由 31.19% 降至 1.16%;其中等待故障检测的时间占比由 3.41% 降至 0.05%。后一个数字是 Detection 阶段造成的停机时间,不是 C4 Tracing 的运行开销。两组数据来自不同月份的生产前后对比,同期 Checkpoint 频率和硬件错误率也发生了变化,不能把全部下降归因于 C4D。最近有效 Checkpoint 在论文里仍是恢复系统给出的对象,C4 没有证明其中的模型状态一定没有被静默污染。
Mycroft 打开的黑盒更深。它修改 NCCL,在少量 Tracepoint 上记录 Communicator、Channel、QP、Chunk 的 GPU-ready、RDMA-transmitted、RDMA-done 和 Stuck Time,再根据 Collective State Machine 判断数据卡在本地 GPU、发送、网络还是远端接收。
Mycroft 的 GPT 实验里 Iteration 从 1116 ms 增到 1119 ms,运行开销低于 1%;生产环境中 90% 异常在 15 秒内发现,RCA 全部在 1 分钟内完成。代价是数据基础设施本身已经不轻:论文估算 10,000 GPU 任务每天约产生 3 TB Trace,只保留一天,并预估更大规模可能需要去中心化分析。
Holmes、Aegis、C4 和 Mycroft 都在看通信,它们不能粗略归为一个粒度。Holmes 看到算子和并行组;Aegis/C4 已经穿过算子边界,使用 Work Request/Completion 或 Transport 状态;Mycroft 明确重建 Channel、QP、Flow/Chunk 的内部依赖。观测越深,版本维护、数据量和分析成本也一起上涨。
1.3.4 找到慢点以后做什么
GREYHOUND 把 Fail-slow 处理拆成 Tracking、Profiling、Validation 和 Mitigation。系统常驻拦截顶层 NCCL 调用,使用自相关识别训练周期和 BOCD 检测超过约 10% 的变化;触发后加 CUDA Event,比对相同通信量的并行组,再临时运行 GEMM 和训练实际路径上的 P2P Test,确认慢 GPU 或慢链路。
它的动作不是一律重启。S1 可以先观察;S2 在 DP Group 之间重分 Microbatch;S3 调整并行拓扑,让大流量避开异常链路,或者把慢 GPU 集中到较少 PP Stage;S4 才是 Checkpoint-and-restart。系统用累计吞吐损失和动作成本做类似 Ski-rental 的升级判断。
GREYHOUND 的 Tracking 平均开销约 0.39%;生产集群的 499 个 Probing Job 经人工交叉验证后正确诊断 498 个。256 张 H800 的故障注入实验中,包含检测、Profiling 和 Validation 的平均端到端反应时间为 10.56 秒,Mitigation 相对不处理提高 1.58 倍吞吐。低于 10% 或多次小步变化可能漏掉,S2/S3 也依赖训练框架暴露足够的重配置能力。
这篇论文把一个很重要的现实带进来了:更精确的根因只完成了闭环的一半。继续跑、加大观测、局部重平衡、改拓扑和重启的成本不同,控制器需要比较故障继续存在的损失与动作本身的代价。
1.3.5 慢并不等于机器坏了
Understanding Stragglers in Large Model Training Using What-if Analysis 采集约 10% Step 的 Forward/Backward、PP Send/Recv、DP AllGather/ReduceScatter,根据相同算子的均值或中位数构造一个无 Straggler 的反事实执行,再与实际 Timeline 比较。
论文从五个月生产数据中清洗出 3079 个可分析训练任务,覆盖原始集合的 38.2% Job 和 56.4% GPU-hours;过度重启、Trace 损坏、Step 太少或模拟误差过大的任务被排除。在这个分析集里,42.5% 至少慢了 10%,约 10.4% 已分配 GPU-hours 消耗在 Straggler 上。Stage Partition Imbalance、Sequence Length Imbalance 和 Python GC 都是重要来源;机器问题只在约 1.7% 的 Straggling Job 中贡献超过一半 Slowdown,但它一旦出现,平均会把任务拖慢约 3.04 倍。
这个结果对自动处置很有用。换节点很适合硬件慢点,对 Stage 划分、输入不均和 Python GC 没有帮助。系统若只会从资源指标找离群机器,可能不断重启一个结构上就不平衡的任务。
1.3.6 Kernel 里面还可以看到什么
Neutrino 在运行时抽取并插桩 PTX/GCN 汇编,Probe 可以记录指令时间、寄存器、内存地址和值,再用 Densified Memory Access Timeline 分析 Memory Coalescing、Block Tailing 和 Kernel 内部路径。它同时支持 NVIDIA 与 AMD。
轻量 Probe 后 Kernel Runtime 平均为 Baseline 的约 1.04 倍,也就是增加约 4%;重型 DMAT 后平均为 Baseline 的约 7.12 倍,也就是增加约 612%。这个数字已经说明了它在完整系统里的位置:先由集群和 CCL 级诊断把范围收敛到少数 Kernel,再短时打开指令级探针。让 DMAT 常驻全部 Kernel,训练很可能先被观测系统拖成慢节点。
Neutrino 能看到值域,为未来 SDC Probe 提供了底层条件;论文本身没有定义 Tensor Invariant、冗余比对、错误判定和污染恢复,所以不能把它算成 SDC 系统。
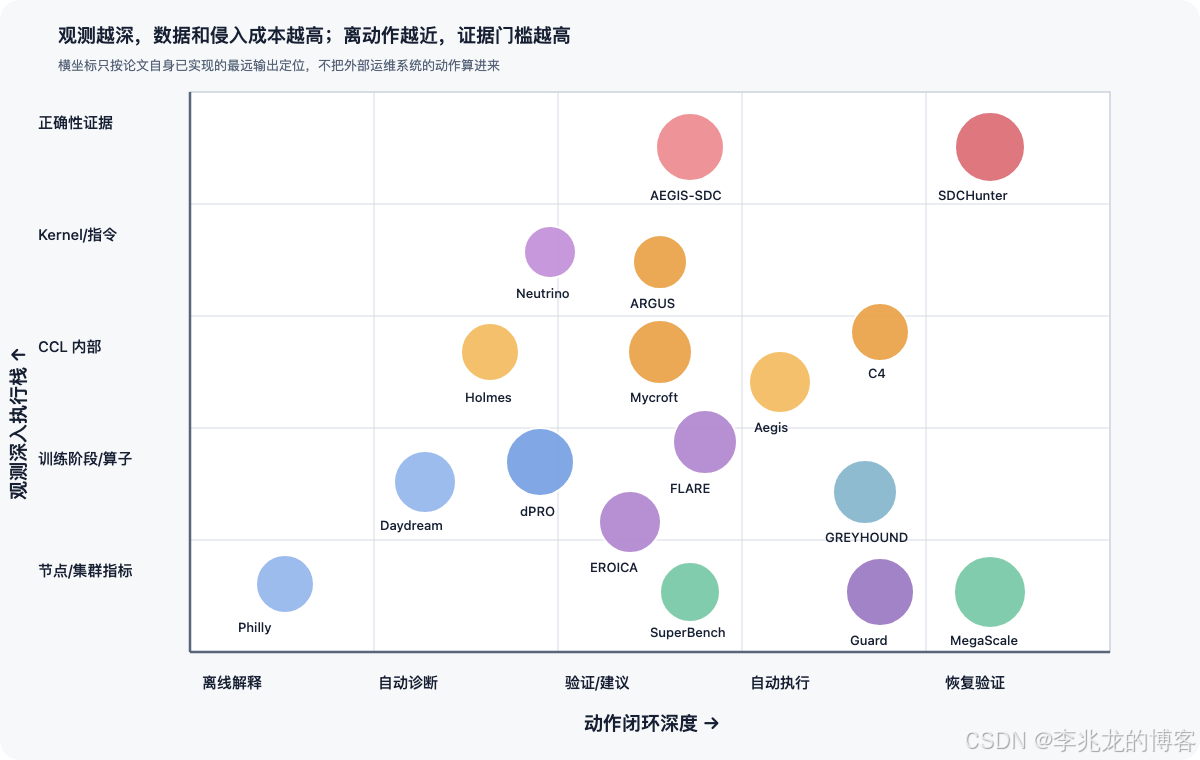
图 2:横轴是观测结果离动作有多近,纵轴是观测进入执行栈有多深。位置表示论文主要贡献,不代表系统只能覆盖一个点。
1.4 2026:常驻、触发与正确性
走到 2026 年,生产系统开始正面处理 Observability Policy:什么数据一直采,什么数据只保留摘要,异常之后把哪一层放大,昂贵验证应该在哪里运行。
FLARE(早期版本名为 XPUTimer)在每个训练进程里常驻 Selective Tracing,后台线程查询 CUDA Event 并输出数据。Python 层拦截 GC、DataLoader、GPU Synchronize 等关键 API,C++ 层拦截计算/通信 Kernel,以 CUDA Event 计时并保留 Input Shape/Layout。系统聚合训练吞吐、Kernel FLOPS、通信 Bandwidth、Kernel Issue Latency Distribution 和未覆盖区间的 Void Percentage。
FLARE 在 1024 张 H800 上的三个 LLM Backend 平均 Latency 开销约 0.43%,在约 6000 GPU 集群持续运行八个月。它覆盖 Error、Hang、Fail-slow 和轻微 Regression;对通信 Hang 还可以在任务已经挂起后使用 CUDA-GDB 读取 NCCL Kernel 的传输 Step,定位环中停滞的设备。对 Performance Regression,论文采用保守策略,只报告潜在回归和缩小后的原因,不直接终止训练;Error 和 Fail-slow 结果则交给外部运维链路处理。
ARGUS 把常驻粒度又推深了一步。它持续采集 py-spy CPU Stack、CUDA Event Framework Semantics 和每个 GPU Kernel 的 CUPTI Activity;Kernel Duration 按 (kernel, stream, rank) 做 KDE 聚类,每个 Cluster 只保留 count/p50/p99,再用重建的 CDF 和 Wasserstein-1 Distance 做跨 Rank 比较。
论文在 8 GPU 和 32 GPU、各 1000 个 Iteration 的实验中测得三条采集链合计开销低于 2%;系统另在 10,000+ GPU 生产集群部署超过六个月。每 Rank 每 Step 的 Kernel Event 从约 10 MB 压成 2.7 KB 结构化摘要,约 3700 倍;完整执行现场则编码为 Perfetto Trace 后另存对象存储。L1—L3 自动找到异常窗口、并行组内 Straggler、慢 Phase 和慢 Kernel,L4 完整 Execution Trace(用 Perfetto 分析)、L5 CPU Stack 仍主要由工程师确认。细节我已经在《问津集 #7:ARGUS——万卡训练集群里的常驻追踪与渐进式诊断》里拆过,本文只保留它在方法谱系里的位置:用统计摘要支撑在线筛选,同时保留完整 Perfetto Trace 供异常窗口回查。
EROICA(早期版本名为 PerfTracker)选了另一条路线。平时只记录 Step Boundary,最近 50 个 Iteration 的平均时间比近期最短值慢 5%,或者长时间收不到 Step Event,才对所有 Worker 同步触发约 20 秒 Profiling:优化后的 Torch Profiler/Kineto 记录函数与 Kernel Event,特权管理容器同步采集高频硬件样本。
单 Worker 原始 Profiling 数据约 3 GB,EROICA 只保留 Critical Path 上的函数,再把函数行为压成关键路径占比、相关资源平均利用率和利用率标准差三个量,最后约 30 KB。系统在约 10 万 GPU 集群运行 1.5 年,80 个既有工具无法定位的严重问题中找到 78 个。小模型和高 TP 条件下,触发窗口仍可能增加 11%—16% Step Time;正常期低成本不等于异常期没有观察者效应。完整机制见《问津集 #8:EROICA——把 3 GB Profiling 数据压成 30 KB》。
ARGUS、FLARE 和 EROICA 很容易被写成三套互相替代的 Profiler,实际取舍不同。ARGUS 保留持续的细粒度历史,FLARE 只拦截更有诊断价值的跨栈调用,EROICA 在异常之后才把 Profiling 深度拉满。系统最终很可能同时需要这些策略:便宜信号常驻,重复模式保留摘要,异常窗口提高 Fidelity,再给少量候选对象打开 CCL 或指令级 Probe,或者取回完整执行 Trace 用 Perfetto 深查。
Guard 把观测结果接到了节点生命周期。它比较同作业 Peer Node 的 Step Time、GPU Temperature/Utilization/Clock/Power、网络 Error/Retry/Link Flap 和实际传输率,要求多个信号在连续窗口持续偏离。节点根据影响程度进入 Pending Verification 或移出 Healthy Pool,再运行单节点、双节点 Sweep,验证 GPU Throughput、NVLink 和跨节点 Collective Bandwidth;只有全部通过才重新准入。
Guard 给出的动作很具体:训练暂无可见影响时继续观察;持续约 10% 退化可等到下一个 Checkpoint 处置;达到 20% 或任务停滞时立即换健康节点并重启。Grey Node 分类的 FPR 为 12.4%、FNR 为 7.8%,这个结果也提醒了一件事:自动动作不能只看一次模型分类,二次验证和动作风险门槛不是可选附件。
性能之外,2026 年还长出 Correctness Observability。
Safeguarding LLM Training at Scale 把系统命名为 AEGIS;为了与 2025 年的通信诊断系统 Aegis 分开,本文记作 AEGIS-SDC。它使用 cSensor → vTask → cVerifier:cSensor 在 MatMul、FlashAttention 或 Activation Recomputation 等路径上做轻量 Checksum/Fingerprint,把最小验证上下文封成 Verification Task;cVerifier 再利用 Pipeline Bubble 或保留时间片完成 Bitwise Comparison、重算确认。Heuristic Warning 与 Confirmed SDC 是两个状态,不能因为某个 Rank 的数值离群就直接判坏卡。
AEGIS-SDC 在 3500 万 GPU-hours 的生产训练中确认 18 起 SDC、13 张故障 GPU,生产开销约 0.86%。当前覆盖重点是 Transformer 主干中的 MatMul、FlashAttention 等主导 Kernel,主干外的 Element-wise Operation 仍有空白。论文也没有实现 Checkpoint 选择、Rollback 和续训,只为平台提供可以执行这些动作的确认结果。
SDCs in the Wild 中的 SDCHunter 走的是触发后确定性取证。系统必须保存原始 Model、Checkpoint、Input Shard、RNG、Operator Implementation、Parallel Configuration 和 Communication Schedule,锁定 Kernel Selection、MoE Dispatch 与 Collective 顺序,再复现触发异常的 Iteration。
Phase 1 把 DP 维度分成两个逻辑 Replica,输入同一个 Batch,只在 PP Communication Boundary 比较 Tensor Signature;发现一组偏离后先移出调度。论文称任务从 latest verified checkpoint 在健康机器恢复,Phase 2 再离线定位第一个 Divergent Tensor、Kernel 和物理 GPU。这里的 verified 是论文给定的恢复前提:论文没有公开它的判定规则和污染窗口,也没有验证恢复后的 Optimizer、RNG 与 Data Cursor 连续性,不能据此推出一套通用的可信恢复点管理机制。低于 4% 的完整实验开销来自 128/512 GPU、50B/150B 模型和生产训练 Trace 的评估,不是无条件的生产长期平均值;系统当前还依赖 Loss Spike、Shape Error 或 Fail-stop 等外部异常信号触发,Always-on SDC Shielding 仍是论文列出的未来工作。
最后看一下推理。StriaTrace 不以重复 Iteration 和同构 Rank 为基本单元,它观察 Request、Prefill/Decode、跨进程 RPC、外部 KV Cache、少量 Semantic Span、GPU Kernel 和 Memory Transfer。每个 Serving Instance 用 Token 数与 P99 Latency 拟合动态 Roofline,正常 Inference Step 只存聚合指标,只有被标为 Outlier 的 Step 才持久化完整 Kernel Trace。
StriaTrace 在 1700 多个推理实例运行六个月,每天处理约 1.8 亿请求。固定到达率为 8 req/s 时,完整系统在并发 8 的 Median TPOT 开销约 5.2%、TTFT 约 2.7%,并发 256 时才分别降到约 0.6% 和 0.8%。所以摘要里的低开销仍然有负载条件。推理异常零星、请求长度不同、SLO 直接暴露给用户,训练侧的 Rank/Iteration 比较不能直接复用;自适应提升 Trace Fidelity 这条原则倒是相通的。
| Observation policy | 代表工作 | 正常期保存什么 | 异常后增加的证据 | 主要盲区 |
|---|---|---|---|---|
| Always-on coarse telemetry | Minder、Guard | 节点、网络、Step 与健康指标 | Node sweep、Microbenchmark 或短时细粒度采样 | 很难定位函数、Kernel 与同步传播 |
| Always-on selective/deep trace | FLARE、ARGUS | 关键 API、Phase、Kernel 摘要及部分完整现场 | 完整 Execution Trace(以 Perfetto 分析)、CPU Stack、Hang Inspect | 存储和分析基础设施复杂 |
| Anomaly-triggered profiling | GREYHOUND、EROICA | Step/吞吐/动态基线 | Profiler、资源采样、Validation | 触发前的细节可能已经丢失 |
| Selective trace retention | StriaTrace | 关键同步点、Kernel 聚合指标或摘要 | 只为 Outlier Step 持久化完整 Trace | 常驻采集仍有负载相关开销 |
| Specialized active verification | SuperBench、AEGIS-SDC | SuperBench 保存节点历史、风险画像与按需测试;AEGIS-SDC 常驻轻量 Sensor | Sweep、Verifier | 覆盖域有限 |
| Triggered forensic replay | SDCHunter | 无常驻检测,由外部异常触发 | Exact Replay、Divergence Localization | 不能发现未触发的 SDC |
2 三类典型场景
2.1 显式中断:观测结果怎样进入续训决策
显式故障看起来最容易自动化。进程报错、Heartbeat 超时或通信不再推进,重启就好了。大规模训练把这条逻辑弄得复杂很多:同一个 NCCL Timeout 可能来自网卡、GPU、远端 Rank 没有 Launch Collective、上层 DataLoader 卡住,或者用户代码让各 Rank 走了不同控制流。系统若只匹配最后一行错误,很容易把症状当根因。
一个可靠的恢复决策至少需要回答四件事:
-
错误属于可重试基础设施故障、确定性软件错误,还是用户输入/配置问题。
-
哪些 Host、GPU、NIC 或 Parallel Group 不能出现在下一个 Attempt。
-
局部替换、重建 Communicator、改拓扑和整任务重启,哪个成本更低。
-
从哪个 Checkpoint 恢复。
前面几篇论文已经各自覆盖了一部分。Philly 提供 Failure Taxonomy 和 Retry 的统计基础;MegaScale、Aegis 与 C4 把 Heartbeat/Communication 诊断接到隔离、Repair 或恢复;Minder 给出异常机器候选;Mycroft 把通信 Hang 收敛到具体 Flow/Chunk 状态;SuperBench 和 Guard 决定节点能否进入 Healthy Pool;GREYHOUND 比较继续损失与动作成本。公开系统还没有给出一个通用接口,把这些证据交给同一个恢复状态机。
产品接口把恢复责任划得更直接。HyperPod Auto-resume可以在节点替换后重试带 --auto-resume=1 的当前 srun Job Step,Checkpoint 加载仍由入口脚本或训练框架完成;Ray Train V2重建 Worker Group,再把最近报告的 Checkpoint 交给训练函数;Mosaic Watchdog也明确区分重拉 Run 与 Composer Auto-resume。编排层能恢复进程拓扑,仍然无法证明最近的 Checkpoint 可信。
Checkpoint 又是单独一层状态。进程退出、Heartbeat 超时或 Timeout 只确认了失败形态,不是 Root Cause。自动恢复至少要把原因收敛到策略允许重试的基础设施故障或瞬时错误;原因仍不明确时,可以先隔离嫌疑资源和提升观测,不能仅凭 Fail-stop 自动复用最近 Checkpoint。候选 Checkpoint 还要通过原子提交、Manifest、分片完整性、状态版本和数据游标检查。latest 只是时间顺序,不是信任等级;Incident 可能涉及数值错误时,最新文件也可能保存了已经污染的状态。
自动续训的控制对象应该是一次 run 下面的多个 attempt。每个 Attempt 要绑定代码与配置 Digest、数据游标、并行拓扑、节点集合和 Checkpoint Lineage。恢复动作产生新 Attempt,系统再检查最初若干 Canary Step 的吞吐、Loss、通信健康与状态连续性。只有进程重新运行,不能算恢复完成。
这里的判断属于我基于公开系统做的组合推论。ARGUS、EROICA 和 FLARE 主要提供 Observation 与候选 Diagnosis;Minder 输出 Faulty Machine 候选;AEGIS-SDC 提供 Confirmed SDC 证据。MegaScale、Aegis、C4、Guard、GREYHOUND 和 SDCHunter 在各自限定的故障模型下触及隔离、Repair、重配置、节点替换或任务恢复。这些局部闭环不能拼成公开系统已经实现统一自动续训。
2.2 慢节点:从实时追踪收敛到动作
Fail-slow 麻烦在它不要求任何组件报错。一个 Rank 的 Backward Compute 变慢,下一层 Rank 会等梯度;一条链路退化,Collective Duration 拉长;一个 Python GC Stall,GPU 会出现 Idle Gap。最后所有 Rank 的 Iteration Time 可能非常接近,因为同步点把差异重新对齐了。
这条诊断链可以分成四层:
-
用低成本常开信号确定时间窗。 Iteration/Step Time、吞吐、GPU 利用率和节点指标适合做 Change Point、Regression 和持续偏离检测。这里已经不能只有固定阈值:多模态输入、动态 Sequence Length、MoE 路由和不同 Pipeline Stage 本来就有自然差异。StriaTrace 在推理侧使用动态 Roofline,训练侧则更依赖相同并行角色的 Peer Comparison。
-
把时间窗放回 Parallel Topology。 DP、TP、PP、EP、CP 的 Rank 角色不同,所有 Rank 混在一起计算均值很容易制造异常。ARGUS 按并行组比较 Phase,Holmes 按 Communication Operator Graph 追踪传播,What-if Analysis 用反事实执行拆出 Stage Imbalance 与正常负载变化。系统需要先回答谁在等、谁被等,再谈根因。
-
进入 CCL 和 Kernel。 Mycroft 看 Flow/Chunk State,C4 看 Transport 与 QP,ARGUS/FLARE 看 Kernel Distribution 和 Issue Latency;只有范围已经很小时,才值得拉 Perfetto、CPU Stack 或 Neutrino 的 Instruction Probe。这个顺序控制的是 Observability Budget。全面采集万级 RNIC 的 QP Telemetry,Holmes 估算单迭代可能超过 10 TB;一直打开 DMAT 又会把 Kernel Runtime 放大到平均约 7.12 倍。工程运行时也在保留这类现场:PyTorch Flight Recorder记录各 Rank Collective 的
scheduled/started/completed状态、Sequence ID 和调用栈,NCCL RAS用旁路网络汇总失联进程与 Collective 进度。它们输出的进度差异仍然是 Observation。分辨率没有免费的升级按钮。 -
运行验证。 GREYHOUND 的 GEMM/P2P Test、Guard 的 Node Sweep 和 SuperBench 的 Workload-aware Benchmark 用主动执行验证设备或链路问题;What-if Analysis 提供反事实诊断,判断 Slowdown 是否来自 Stage Partition、输入分布或 Python GC。后者可以阻止错误换机,不能单独授权节点隔离。
Google Cloud 的 CoMMA/AI Hypercomputer Monitoring 将输出明确命名为 Suspected Straggler,并提示检测可能延迟、误报或漏报;只有其他指标也显示 Workload 异常时才建议采取动作。这个接口提供的是嫌疑对象,不是已经确认的节点根因。公有云的动作边界也不相同:AWS HyperPod 的主动检查可以隔离失败节点并验证替换节点,Azure AKS Node Problem Detector 只发布 GPU Node Condition/Event,并明确不负责处置。这些产品已经提供控制面的证据入口,还没有形成共同的 Diagnosis、Verification 和 Recovery 闭环。
动作也应该分级。影响不明显时继续观察,提高 Trace Fidelity;局部慢点可以重分 Microbatch、调整拓扑或隔离节点;损失超过恢复成本后再 Checkpoint-and-restart。一个只会换机器的系统会不断重启同一个 Python GC 或 Stage Partition 问题,一个永远不动作的 Profiler 则只能把浪费记录得很漂亮。
2.3 静默错误:性能指标看不见的另一张平面
SDC 把性能可观测性的假设掀掉了一块。GPU 利用率正常、Collective 按时完成、Step Time 没有 Regression,都只能说明系统在前进,不能说明计算结果正确。ECC/XID 等计数器覆盖的是硬件已经发现并报告的错误;Silent Data Corruption 的定义恰好是错误绕过了这些显式机制。
Correctness Observability 需要观测数值语义。一个可行方向是算子级 Checksum 与 Numerical Invariant,例如 MatMul 的高精度残差、Attention 中可以验证的代数关系;另一个方向是复用训练已有冗余,例如 Activation Recomputation,让同一计算片段在确定性条件下执行两次,再比较轻量 Fingerprint。AEGIS-SDC 已经验证了这两条路径可以在低于 1% 的生产平均开销下工作,但覆盖面仍集中在主导 Kernel。
检测和确认要分开。跨 DP Rank 的数值 Outlier 可能来自 Warm-up、输入分布和合法的不确定性,直接停训会制造很高的误处置成本。轻量 Sensor 适合持续运行,Verifier 再用 Bitwise Comparison、冗余重算或 Replay 把状态从 suspected 提升到 confirmed。AEGIS-SDC 的 Verification Task 是一个很好的接口雏形。
确认以后还要知道污染传播到哪里。SDCHunter 找到的是触发回放 Iteration 内的第一个 Divergent Tensor,它足以把问题收敛到 Kernel 和设备,却不能单独确定训练历史中第一次污染发生在哪一步。未来系统还需要结合 Sensor 覆盖范围和此前的候选恢复点,从更早的 Checkpoint 前向 Replay,或者在多个候选恢复点之间做分段、二分验证,保守缩小 Exposure Window。first_possible_corruption_step 和后续 Checkpoint 降级属于本文提出的架构,不是 SDCHunter 已经给出的能力。
这一步目前主要是我的架构推演。AEGIS-SDC 告诉平台某个执行上下文确认出现了 SDC,SDCHunter 能在确定性 Replay 中定位设备;Guard 和 SuperBench 分别提供了可供设计参考的隔离与重新准入机制,公开材料没有证明它们已经与前两套系统集成。谁来计算污染窗口、标记 Checkpoint、选择满足当前完整性策略的恢复点,公开论文还没有给出一套统一实现。
3 稳定性决策中枢
把这些系统拼在一起,我预估下一步会出现一个轻量的证据与决策层。这个判断来自前面的公开论文组合,不代表某套系统已经把所有能力做完。我对恢复控制面的实践也不够多,这里只保留几条能由论文支撑的结构判断,不继续展开成字段级接口设计。
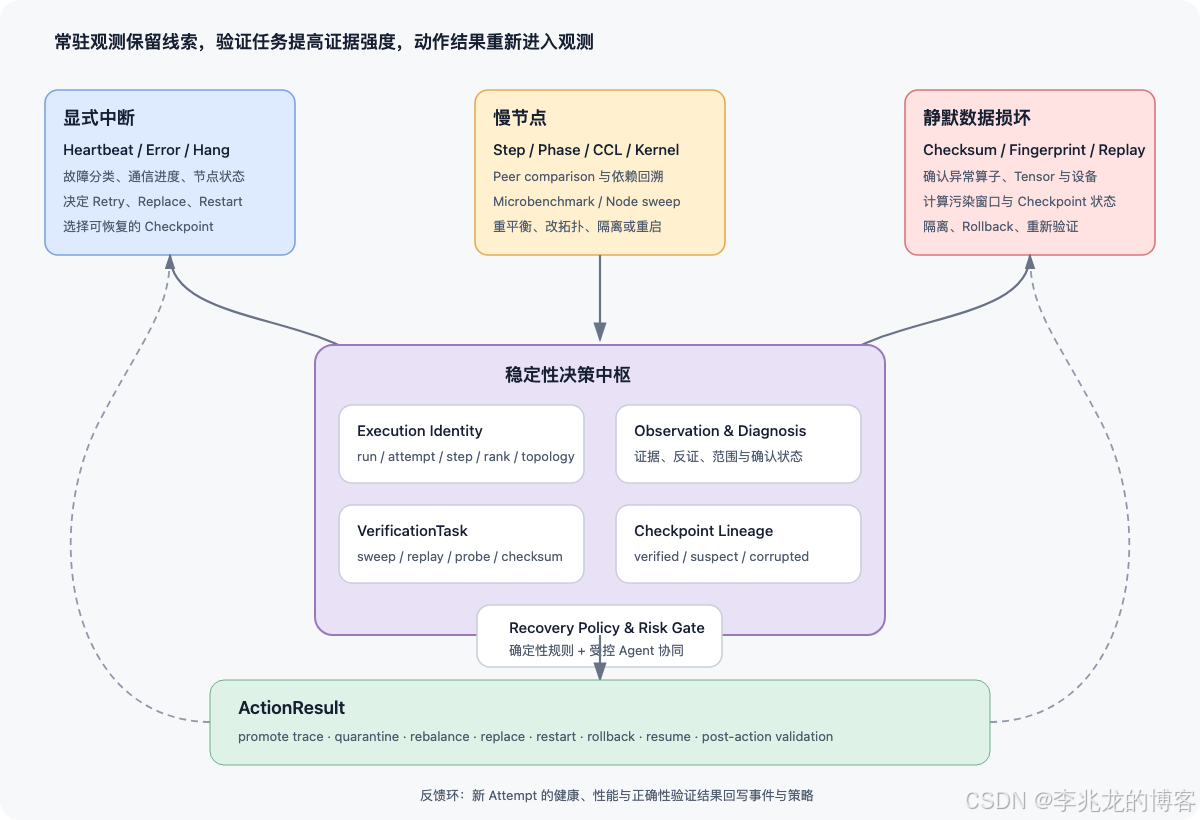
图 3:图中的统一接口与状态机是基于公开论文做的架构推演,不代表某一篇论文已经实现完整系统。
这个中枢先处理三件事:
-
统一执行身份。 Observation 至少要能回到当时的
run/attempt/step/rank、并行坐标、Host、GPU、NIC、代码版本、Topology Snapshot 和 Checkpoint;这些高基数字段不必全部成为 Metric Label,但必须能通过稳定 ID 和快照解析出来。跨重启后 Rank Mapping 会变化,拿当前拓扑解释半小时前的 Incident,很容易找错设备。 -
分开 Observation、Diagnosis 和 Verification。 NCCL Kernel 变慢、Loss Spike 和 GPU 功耗降低都只是现象;网卡故障、Stage 本来就空闲或 GPU 发生 SDC 才是经过证据支持的解释。系统还要保留反证和
suspected / confirmed / inconclusive这类确认状态。AEGIS-SDC 的 vTask、SDCHunter 的 Replay、Guard 的 Node Sweep 和 GREYHOUND 的 Microbenchmark 都是先生成嫌疑,再调度更贵的确认任务;Checksum、Exact Replay、Node Sweep 和 Microbenchmark 验证的是不同命题,不能直接压成一个没有主语的confirmed,更不能自动授权高风险动作。 -
把 Checkpoint 和动作结果纳入同一条证据链。 Checkpoint 除了可加载、分片完整,还要知道父子关系、对应 Step、数据游标以及是否落在可疑污染窗口内;隔离、换机、重启和回滚则要记录使用了哪些证据、生成了哪个新 Attempt、执行以后是否通过 Canary 和正确性验证。这里更适合分级自治:已知、可重复、低风险的故障交给确定性状态机,高风险回滚和 SDC 恢复保留更高的证据门槛与人工审批。Agent 可以帮助组织跨工具证据和解释长尾案例,不应该替代这些边界。
4 时序存储的挑战:统一数据平面已经可行,难点转向关联与成本
ARGUS 的一组数字很适合解释存储侧发生了什么:每个 Rank 每个 Step 约 10.6 MB 原始事件,转换成 Perfetto Trace 后是 443 KB,真正上传 Metric Storage 的结构化数据只有 18.7 KB,完整 Trace 另进 Object Storage。EROICA 在异常触发后每个 Worker 暂时产生约 3 GB Profiling 数据,再压成约 30 KB Behavior Pattern。Holmes 估算过,如果把 10,000 个 RNIC 的 QP/Chunk 状态全部重构出来,每个 Iteration 会超过 10 TB。这些数字的采集范围不同,不能横向排压缩率;它们说明细粒度证据需要分层编码、索引和留存。
4.1 这一代时序架构已经能接住四类数据
十年前的 TSDB 经常把 Series Key 或 Tag 组合映射到常驻索引,高基数会直接推高内存和写放大。今天公开可见的云原生架构已经换了一套做法。InfluxDB 3 的存储引擎将数据写成 Object Storage 里的 Parquet,PostgreSQL-compatible Catalog 保存 Schema、Partition 和物理位置,Querier 基于 Arrow/DataFusion 执行 SQL,官方也直接使用了 Infinite Tag Cardinality 这个表述。OpenObserve采用的结构也很接近:PostgreSQL 管 Stream Schema 与 Parquet File List,对象存储保存列存文件,分布式 Querier 负责 SQL,内存和本地介质承担缓存,同时覆盖 Log、Metric 和 Trace。GreptimeDB也采用存算分离架构,Metasrv 管理 Catalog、Schema、Table、Region 和路由,Frontend 分发 SQL、PromQL、Log 与 Trace 查询,Datanode 将不可变数据文件写入 Object Storage;它的 Mito 存储引擎把 Memtable 刷成 Parquet SST,并在 Region Manifest 中记录文件变化,Write Cache 与 Read Cache再接住近期和历史热点数据。
我理解 Infinite Cardinality 在这里是一种架构语义:系统不再要求每一个 Tag Value 或完整 Series 都对应一条常驻、全量、精确索引。数据按时间、租户和其他排序键组织成列存文件,Catalog 和独立索引文件保存 Partition、Row Group、Min/Max、Bloom Filter、Tag Dictionary 或文件位置,查询时先剪枝,再由分布式计算引擎扫描命中的列和数据块。这与 ClickHouse 的稀疏索引是同一类思路:索引记录 Granule/Block 的边界和统计信息,不为每一行建立 B-tree。基数不再是一堵硬墙,Group By、Catalog 规模、缓存命中和扫描成本仍然要付。
这套系统最好拆成两条路径理解。写入侧是 WAL/MemTable → 列存数据文件与索引文件 → Object Storage → Catalog Commit;查询侧是 SQL → Catalog/Index 剪枝 → 分布式计算任务 → Memory/Cloud Disk/Distributed Filesystem/自研 SSD Cache → Object Storage。缓存位于计算与远端存储之间,命中时直接复用数据块,未命中才回源。Catalog 的实现没有统一答案,PostgreSQL、MongoDB 和自研元数据服务都有人用;缓存层同样取决于延迟、成本和现有基础设施。真正稳定的是存储与计算分离、列式组织、稀疏索引和按需缓存这几个方向。
文件格式目前仍以 Parquet 最普遍,生态和计算引擎支持都最成熟。近几年也出现了 Nimble 与 Lance 这类新格式:Nimble 面向宽表、灵活编码和 AI/ML 数据,Lance 更强调 Object Storage 上的 Random Access、Point Lookup 与 ML/Vector 工作负载,我暂时不会把 Lance 当成追加写与时间范围扫描型 TSDB 的默认格式。格式会继续变化,统一数据平面的前提已经存在。
Metric、Log、Trace 和 Continuous Profiling 都可以规范化成带时间、属性和执行身份的列式记录,由同一套 SQL 引擎完成过滤、聚合和关联。Trace 需要额外保存 Span/Slice/Flow、Parent/Correlation 与 Sequence,Continuous Profiling 保存 Sample、Stack/PC、Weight 和 Build ID。Perfetto 文件本身也可以继续作为 Trace 与 Continuous Profiling 的独立存储格式,通过 Catalog 注册文件级元数据和 evidence_ref,查询时由 Table Function 或专用 Reader 接入;没有必要为了物理统一,先把每一份完整现场全部改写成 Parquet。
4.2 统一 Tag 决定能不能从 Metric 走到现场
我在《从一到无穷大 #73:Gartner 2026 可观测魔力象限》里讨论 UModel 和 Datadog 时,最看重的就是统一 Tag 带来的跨域关联。物理上共用对象存储和 SQL 引擎,只解决了数据可以放在一起;一次 Metric 告警能不能继续定位到对应 Rank 的 Trace 和 Continuous Profiling,取决于这些数据有没有共享同一套执行身份。
对大模型训练,这组 Tag 至少要覆盖 run_id / attempt_id / step_id / rank_id / parallel_coordinate / host_id / gpu_uuid / nic_id / communicator_id / topology_version / checkpoint_id。它们不必全部进入每张表的主索引,也不要求每个 Sample 重复存一遍;Catalog、字典表和 Topology Snapshot 可以负责从稳定 ID 解析当时的映射。这里尤其不能只存 Rank:新 Attempt 会重新分配 Rank,Pod Name 和 CUDA Device ID 也可能重用,只有 attempt + rank + device UUID + topology version 才能还原事故现场。
理想的定位路径很直接:Step Time Metric 先找到异常时间窗和慢 Rank,同一组 Tag 随后剪枝到该 Rank、该 Step 的 Collective/Kernel Trace,再取回相同窗口的 CPU Stack、GPU PC/Stall Reason 或 Perfetto Profile。Incident、VerificationTask、Checkpoint 和 ActionResult 继续沿用这些 ID。统一 SQL 提供查询入口,统一 Tag 和实体关系才让这条链真的连得起来。
4.3 已经具备技术前提之后,挑战还剩什么
这套架构把高基数从硬限制变成了成本问题,也把新的困难暴露出来:
-
Catalog 与索引要同时服务多种访问路径。 Metric 常按时间、Tag 和聚合维度查询,Log 需要字段过滤甚至全文检索,Trace 经常按
trace_id/span_id、Rank、Collective Sequence 和时间窗回放,Continuous Profiling 还要按 Stack、Build ID 和 Label 聚合。一个排序键和一组稀疏索引不可能同时覆盖所有路径。Catalog 要保存文件级与 Row Group 级统计,二级索引则根据工作负载选择 Bloom、倒排、Min/Max、Tag Dictionary 或专用 Trace Index。无限基数没有消除索引设计,只是允许系统不把所有基数都提前展开。 -
SQL 能统一入口,无法自动补齐因果语义。 CPU Wall Clock、GPU Timestamp 和 Monotonic Clock 属于不同 Clock Domain,CUDA Stream Order、Collective Sequence 和 Step 又属于逻辑 Ordering Domain。
JOIN ... ON timestamp很难重建跨 Rank Critical Path,火焰图聚合、Trace Flow、First Divergence 和 Replay 也需要 Table Function、专用算子或预计算关系。统一 SQL 很重要,执行语义仍要为 Trace 与 Profile 单独补齐。 -
事故会把平均写入模型打穿。 平时系统接收秒级 Metric、Step 摘要和采样 Stack,异常后可能让全部 Rank 同时导出 Kernel Trace、CCL 进度和 Python/C++ Stack。Mycroft 用每机 512 MB Shared-memory Buffer 保留近期通信现场;EROICA 触发后每个 Worker 暂时产生约 3 GB Profiling Data。这里需要分段上传、背压、优先级、局部聚合、Partial Dump 和 SSD Cache Admission;只按日均写入带宽规划,事故发生时缓存和 Catalog 会一起抖。
-
不同证据不能使用同一套 Retention。 Metric 可以长期降采样,Log/Event 要保留 Incident 和动作审计所需的状态转换,原始 Trace 与高精度 Profile 可以只保留故障热窗口。SDC Evidence Artifact、Checkpoint Manifest、Replay Package 和 ActionResult 则要 Bit-preserving、不可变、可审计,并与模型和 Checkpoint 生命周期绑定。一次 Profile 如果只剩 Program Counter/
stack_id,没有二进制 Build ID、符号表和 CUDA/NCCL/框架版本,文件还在也无法解释。
4.4 三类事故分别要存什么
下面这张表回答三个场景分别要存什么。四类遥测都可以进入同一个列式数据平面;表里的载体包含规范化列式记录与原始证据两层,Perfetto、Replay Package 和 Checkpoint 作为独立对象时也要注册到同一个 Catalog。
| 场景 | Metric(数据与列式记录) | Log / Event(数据与列式记录) | Trace(规范化记录与原始证据) | Continuous Profiling(规范化记录与原始证据) | 四类之外的状态证据 |
|---|---|---|---|---|---|
| 显式中断与自动续训 | Heartbeat、Step 是否推进、GPU/NIC 健康、错误计数、恢复后吞吐;规范化为 event_time + value/histogram + tags | Exit Code、XID、NCCL Timeout、错误栈、Rank/Host 重映射、节点隔离、调度与 ActionResult;JSON/Protobuf/OTLP 摄入后展开为类型化列 | 故障前后的 Collective、CUDA、Kernel 与通信进度;Event/Slice/Flow 进入列式表,Ring Buffer 导出的原始 Segment 或 Perfetto 文件保留为证据对象 | CPU、Python/C++ Stack Sample;加速器支持时增加 GPU PC/Stall Reason;PerfSample/StackSample 保存在 Perfetto,并抽取 Window、Stack、Weight 与 Build ID 供 SQL 聚合 | Run/Attempt、Topology Snapshot、Checkpoint Manifest、Shard/DCP Blob、Optimizer/RNG/Data Cursor 状态 |
| 慢节点与实时诊断 | Step/Phase/Op/Kernel 延迟和吞吐,GPU/CPU、功耗、温度、PCIe/NVLink/NIC 指标;保留可合并 Histogram/Sketch | Straggler 告警、基线变化、Communicator/Rank 状态和诊断阶段转换;记录保留 sequence_no 与证据引用 | Rank、Collective、CCL Flow/Chunk、CUDA Stream 和 Kernel Timeline;规范化表用于 SQL 剪枝与关联,完整 Perfetto/Chrome Trace/自定义 Segment 用于深查 | 常驻 Stack/PC Sample 与异常后提升采样率的窗口;Perfetto 保留完整 Sample,列式表保留可查询摘要和索引列 | 版本化并行拓扑、Kernel Build ID、符号表、Microbenchmark/Node Sweep 配置与结果 |
| SDC 在线诊断与可信恢复 | 设备错误计数、Verification 延迟、Suspect 数量和命中率;它们描述风险与验证系统状态,正常值不能证明计算正确 | VerificationTask 的 Checksum/Fingerprint、Invariant 结果、suspected / confirmed 转换、Checkpoint Lineage 与处置记录;使用不可变 Event | 受保护算子、Tensor Boundary、通信顺序和 Replay Divergence 路径;Sequence/Correlation 进入列式表,原始 Replay Trace 保留为证据对象 | CPU/GPU Profile 只作触发与旁证,不能单独确认 SDC;Sample 继续使用 Perfetto,SQL 侧保存窗口与关联 Tag | Model、Checkpoint、Input Shard、RNG、算子与 Kernel 版本、并行配置、通信顺序组成 Exact Replay Package |
这套系统真正需要支持的查询是:从一个 Incident 和一组统一 Tag 出发,先在 Metric 中定位异常时间窗,再用同一组执行身份剪枝 Log、Trace 和 Continuous Profiling,最后按 evidence_ref 打开完整 Perfetto、Replay Package 或 Checkpoint。四类数据进入同一引擎的技术条件已经具备,挑战落在统一 Tag 是否可靠、Catalog 能否及时剪枝、跨模态算子是否够用,以及事故发生时整条数据链会不会先被自己的写入量压垮。
5 总结
大模型可观测性还有一个论文里较少展开的落地问题。GPU 环境和司内 IDC 经常处在隔离网络中,链路也未必稳定,私有化部署很容易从一个选项变成前提。私有化又会把依赖一起拖进来:司内 Kubernetes、对象存储、Catalog、消息链路、权限和升级体系都要打包,或者逐项适配已有设施。对小团队来说,这接近再维护一套基础设施,长期的部署、升级和运维投入比实现几个诊断算法更重。
Profiler 已经很擅长保存现场。生产级可观测性要进一步把现场压成带执行身份、拓扑、证据强度和影响范围的判断:显式故障决定是否重试和替换哪些节点,Fail-slow 区分硬件慢点与训练结构问题,SDC 追踪污染窗口和可信 Checkpoint。动作执行以后,系统还要证明新的 Attempt 回到了健康、有效并且可信的训练状态。
否则自动续训只是自动重启。重启得确实挺快,至于从哪里继续、继续算出来的东西还能不能用,系统并不知道。
资料
- Myeongjae Jeon et al., Analysis of Large-Scale Multi-Tenant GPU Clusters for DNN Training Workloads, USENIX ATC 2019.
- Hongyu Zhu et al., Daydream: Accurately Estimating the Efficacy of Optimizations for DNN Training, USENIX ATC 2020.
- Hanpeng Hu et al., dPRO: A Generic Performance Diagnosis and Optimization Toolkit for Expediting Distributed DNN Training, MLSys 2022.
- Ziheng Jiang et al., MegaScale: Scaling Large Language Model Training to More Than 10,000 GPUs, NSDI 2024.
- Yifan Xiong et al., SuperBench: Improving Cloud AI Infrastructure Reliability with Proactive Validation, USENIX ATC 2024.
- Yating Wei et al., Visual Diagnostics of Parallel Performance in Training Large-Scale DNN Models, IEEE TVCG 30(7), 2024.
- Yangtao Deng et al., Minder: Faulty Machine Detection for Large-scale Distributed Model Training, NSDI 2025.
- Zhiyi Yao et al., Holmes: Localizing Irregularities in LLM Training with Mega-scale GPU Clusters, NSDI 2025.
- Jianbo Dong et al., Evolution of Aegis: Fault Diagnosis for AI Model Training Service in Production, NSDI 2025.
- Tianyuan Wu et al., GREYHOUND: Hunting Fail-Slows in Hybrid-Parallel Training at Scale, USENIX ATC 2025.
- Yangtao Deng et al., Mycroft: Tracing Dependencies in Collective Communication Towards Reliable LLM Training, SOSP 2025.
- Songlin Huang and Chenshu Wu, Neutrino: Fine-grained GPU Kernel Profiling via Programmable Probing, OSDI 2025.
- Jinkun Lin et al., Understanding Stragglers in Large Model Training Using What-if Analysis, OSDI 2025.
- Jianbo Dong et al., Enhancing Large-Scale AI Training Efficiency: The C4 Solution for Real-Time Anomaly Detection and Communication Optimization, HPCA 2025.
- Weihao Cui et al., FLARE: Anomaly Diagnostics for Divergent LLM Training in GPU Clusters of Thousand-Plus Scale, NSDI 2026.
- Jiasheng Zhou et al., ARGUS: Production-Scale Tracing and Performance Diagnosis for over 10,000-GPU Clusters, arXiv:2606.20374v2, 2026.
- Yu Guan et al., EROICA: Online Performance Troubleshooting for Large-scale Model Training, NSDI 2026.
- Guanliang Liu et al., Guard: Scalable Straggler Detection and Node Health Management for Large-Scale Training, MLSys 2026 Industry Track.
- Kinman Lei et al., Safeguarding LLM Training at Scale: Online SDC Detection and Insights from 35 Million GPU Hours, OSDI 2026.
- Wenxin Zheng et al., SDCs in the Wild: Characterizing and Diagnosing SDC-Defective GPUs in Production LLM Training, OSDI 2026 Operational Systems.
- Haonan Wu et al., StriaTrace: Efficient Tracing and Diagnosis for Online LLM Inference, OSDI 2026 Operational Systems.
- Meta, Dynolog: Open source system observability.
- Meta, Holistic Trace Analysis.
- AWS, SageMaker HyperPod deep health checks 与 Automatic node recovery and auto-resume.
- Google Cloud, Troubleshoot GPU health check failures 与 Monitor AI Hypercomputer instances and Slurm clusters.
- Microsoft Azure, GPU health monitoring in AKS with Node Problem Detector.
- PyTorch, Flight Recorder: A New Lens for Understanding NCCL Watchdog Timeouts 与 Ray, Handling Failures and Node Preemption.
- NVIDIA, Networking Reliability and Observability at Scale with NCCL 2.24、NCCL Inspector 与 Prometheus Mode.
- Anyscale, Train Dashboard; Mosaic AI Training, Watchdog; Fireworks, Checkpoints and Resume.
- OpenTelemetry, OTLP Specification; Perfetto, TracePacket 与 Callstack Sampling.
- InfluxData, InfluxDB 3 Storage Engine Architecture; OpenObserve, Architecture; GreptimeDB, Architecture、Mito Storage Engine 与 Storage Architecture.
- ClickHouse, Sparse Indexing at Petabyte Scale 与 What Is Columnar Storage?.
- Meta, Nimble: A New Columnar File Format; Lance, File Format.
更多推荐
 7
 0
- 0


 已为社区贡献5条内容

所有评论(0)