
大模型训练工具快速基础认知
一张图看全貌:
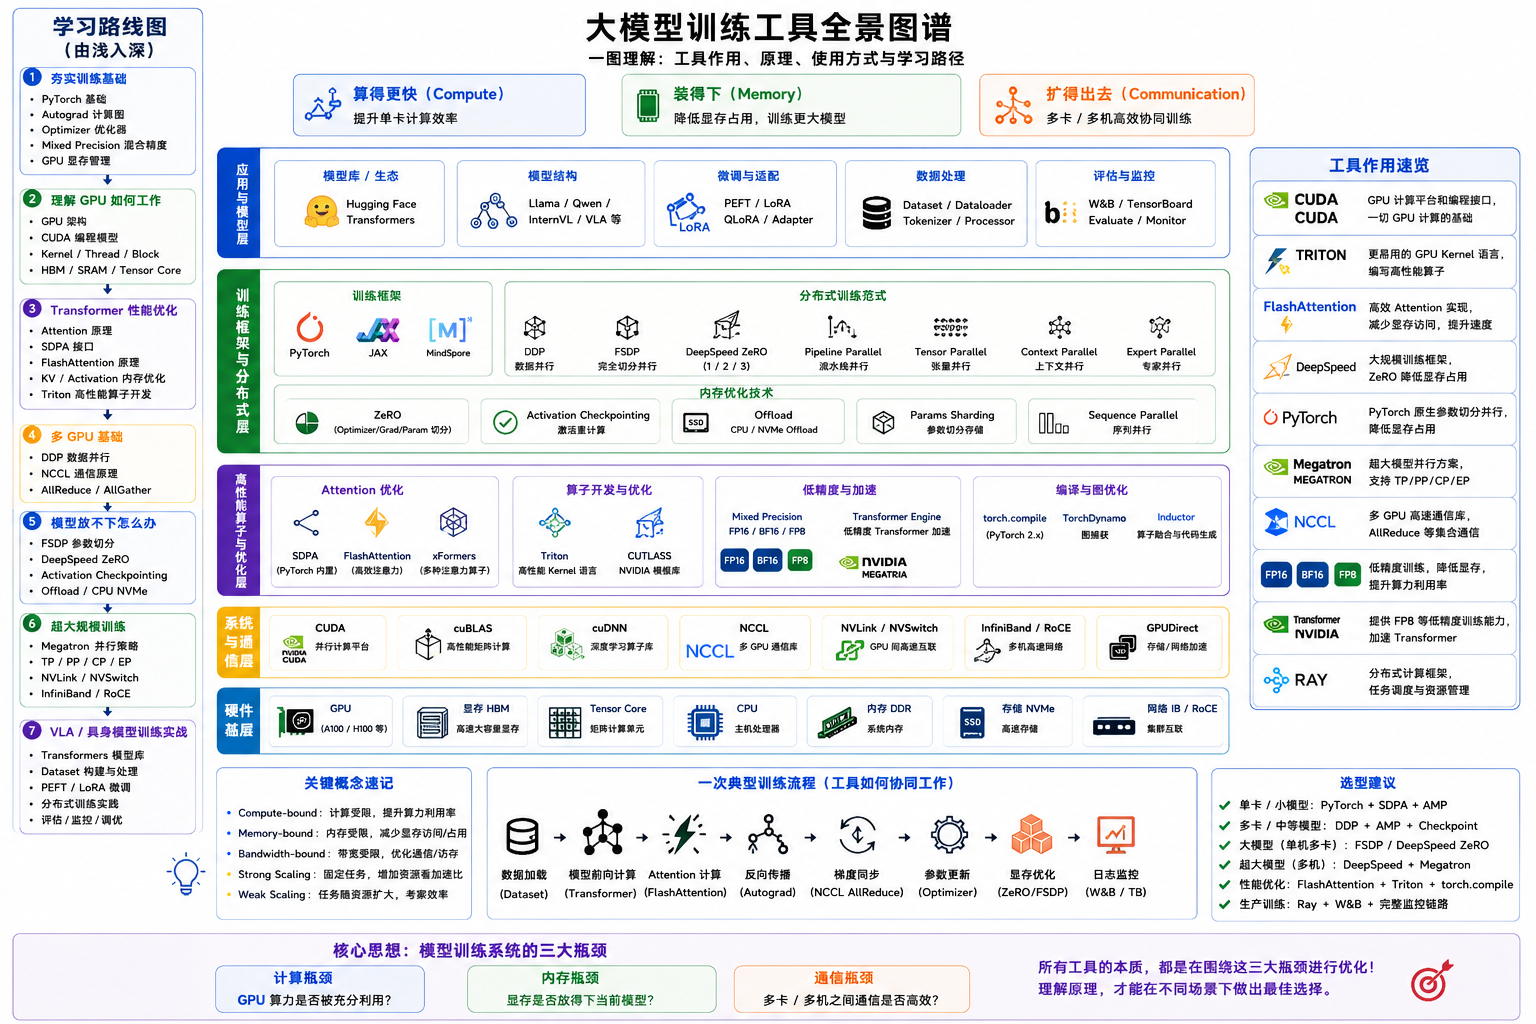
第一层:CUDA——GPU计算的地基
NVIDIA CUDA 是 NVIDIA 的 GPU 并行计算平台和编程体系
第二层:cuDNN / cuBLAS——CUDA上面的“专业工具箱”
CUDA更像操作系统提供的基础能力,而 NVIDIA 又提供大量高度优化库
第三层:PyTorch——你真正每天工作的地方
PyTorch 才是绝大多数模型研发人员真正直接面对的训练框架。
第四层:Triton——更容易写GPU Kernel
OpenAI Triton 的定位特别容易和CUDA搞混,CUDA是GPU编程基础设施;Triton是面向AI计算、更高层的GPU Kernel编程工具。
第五层:FlashAttention——Attention的高性能实现
FlashAttentionFlashAttention的核心思想之一就是:少搬数据,多在片上完成计算。
第六层:SDPA
SDPA偏“统一接口”,FlashAttention偏“高性能实现”。
第七层:DeepSpeed——解决“一个GPU装不下”
ZeRO-1 切 Optimizer State ,ZeRO-2 + 切 Gradient, ZeRO-3 + 切 Parameters
第八层:FSDP——PyTorch自己的“大模型切分方案”
PyTorch FSDP 是 Fully Sharded Data Parallel。
第九层:Megatron——超大Transformer怎么切
Megatron Core 是 NVIDIA 大规模Transformer训练体系的重要组成部分。
DP-Data Parallel ,TP-Tensor Parallel,PP-Pipeline Parallel, CP-Context Parallel, EP-Expert Parallel
第十层:NCCL——GPU之间怎么说话
NVIDIA NCCL 经常被算法工程师忽略,但非常重要。CUDA 解决 GPU“算”, NCCL 解决 GPU之间“通信”
第十一层:NVLink / NVSwitch / InfiniBand
模型规模越大,你越会发现:
训练不只是算力问题,还是通信问题。
GPU ↔ GPU: NVLink
很多GPU互联:NVSwitch
服务器 ↔ 服务器: InfiniBand / RoCE
所以大规模训练的本质逐渐变成:
Compute
+
Memory
+
Communication
三者联合优化。
第十二层:Mixed Precision——FP32 / FP16 / BF16 / FP8
这是训练一定要懂的。
100B参数理论裸参数量:
FP32 → 400 GB
BF16 → 200 GB
FP8  → 100 GB
第十三层:torch.compile
现代PyTorch非常值得了解的一项能力。
torch.compile-->TorchInductor --> Triton --> CUDA --> GPU
更多推荐


 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)