
小威智控 RK3588 主板适配 RK182X 算力卡:端侧大模型推理的务实升级路径
在 RK3588 平台跑端侧大模型的工程师大多遇到过同一个瓶颈:SoC 自带的 6 TOPS NPU 配合 LPDDR 带宽,能胜任 3B 以下模型的量化推理,但面对 7B 级 LLM/VLM 或多模态模型并发时,算力与带宽都会吃紧。瑞芯微给出的解法不是换 SoC,而是给 RK3588 主板"外接一块协处理器"——RK182X 系列 M.2 算力卡。
RK182X 到底是什么
RK182X 是瑞芯微面向 AI 应用推出的高性能协处理器芯片系列,包含 RK1820 与 RK1828 两个型号。它不是独立主控,必须通过 PCIe 2.0 或 USB 3.0 与 AP(如 RK3588)互联,作为其"AI 推理协处理器"存在。
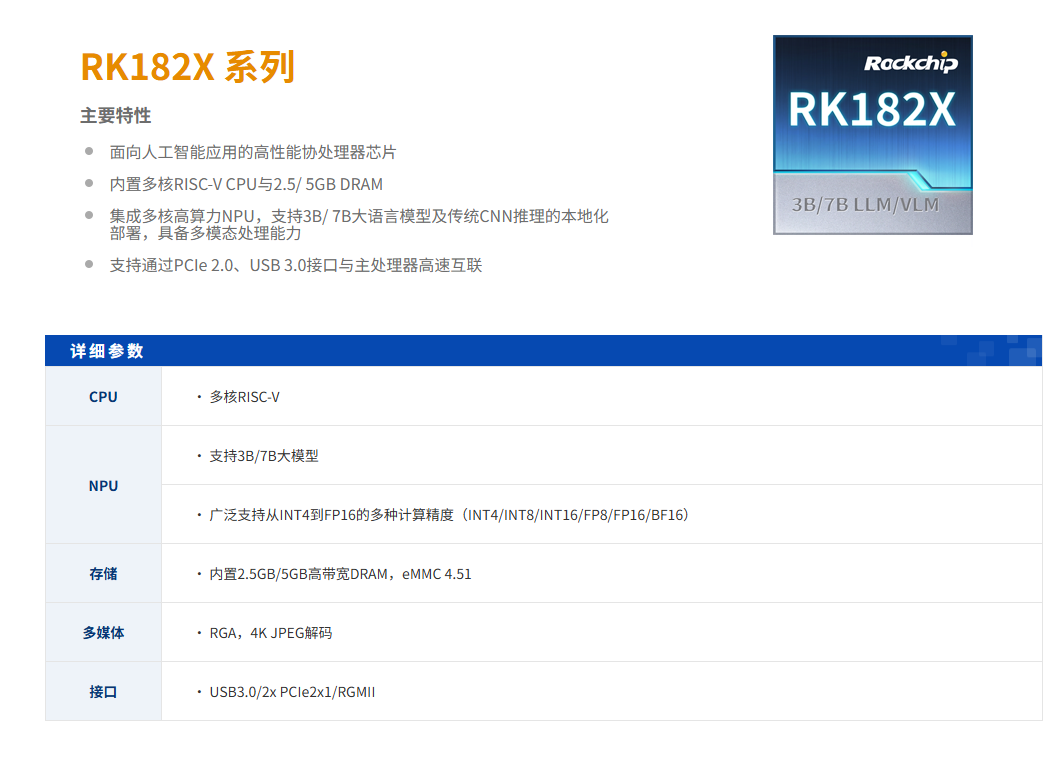
RK182X 的片内 DRAM 采用 3D 堆叠架构,片内带宽可达 1TB/s 量级,相比 RK3588 主存的几十 GB/s 有数量级提升。这正是它能流畅跑大语言模型的关键:大模型推理的瓶颈往往不是算力,而是"内存每秒能喂给 NPU 多少数据",RK182X 通过 3D 堆叠从架构层面解决了这个"内存墙"问题。
RK3588 + RK182X 的分工架构
两者的关系类似于 PC 上"CPU + 独立显卡":
-
RK3588(Host):负责系统调度、运行 Ubuntu/Android 等完整 OS、多媒体编解码(8K@60fps 解码)、外设管理、轻量级实时 AI 任务
-
RK182X(Device):专职承接大模型/VLM/CNN 的推理负载,通过 PCIe 与 Host 通信,推理结果返回 RK3588
这种"主控 + 协处理器"的异构解耦模式,让 RK3588 的 6 TOPS 原生算力与 RK182X 的 20 TOPS 算力形成互补。
适配后能跑哪些模型
根据瑞芯微官方算法支持列表与 RKNN3 SDK 适配情况,RK182X 系列支持的模型涵盖四大类:
-
LLM 大语言模型:Qwen2.5-0.5B/1.5B/3B/7B、Qwen3-0.6B/1.7B/4B/8B、Hunyuan-MT1.5-1.8B、GLM-Edge、Gemma4 等
-
VLM 多模态模型:Qwen2.5-VL-3B/7B、Qwen3-VL-2B/4B、InternVL3-2B、FastVLM-1.6B、UI-TARS 等
-
CNN/视觉模型:MobileNetV1/V2、ResNet-50、YOLOv5/v6/v8、YOLO-World、SigLIP、DINOv2/v3、EVA02 等
-
声音模型:SenseVoice、Qwen3-ASR/TTS、VITS、Whisper、Zipformer
实测数据:RK182X 运行 Qwen2.5-3B 可达 100+ tokens/s,端侧生成速率超 100 tokens/s,端到端延迟低至 0.1s。
RK182X可以通过PCIe等接口与RK3588、RK3576、RK3572等主控平台协同工作,以算力扩展的方式,为不同场景提供灵活的端侧AI升级方案。
目前,小威智控已完成RK3588系列主板与RK182X 的适配验证,并提供软硬件适配、系统优化及开发支持。其中,RK3588负责多任务调度与复杂逻辑处理,RK182X专注AI推理,该组合可广泛应用于智能机器人、工业视觉检测、边缘计算网关、智能安防、多模态分析等高实时性、高算力需求场景。
典型落地场景
RK3588 + RK182X 的组合已在多个方向落地:
-
AI-NVR / 智能安防:RK3588 负责多路 4K 视频流转码,RK182X 跑 YOLO-World / InternVL 做实时目标检测与视觉问答
-
智能机器人:RK3588 负责运动控制与外设,RK182X 承载 VLM 做环境理解与语音交互
-
AI-NAS / 家庭存储:本地大模型助手 + 海量数据存储
-
工业视觉检测:RK3588 做相机接入与预处理,RK182X 跑缺陷检测大模型
-
边缘 AI 网关:多模态大模型本地推理,数据不出设备
更多推荐


 6
 0
- 0


 已为社区贡献3条内容

所有评论(0)