
从零吃透 Kubernetes:网络策略 + 调度机制 + 自动扩缩容完整教程
Kubernetes Network
学习参考:网络策略
单主机网络通信
Docker 单机网络
Docker 内的网络接口均为虚拟接口。虚拟接口最突出的优势是数据包转发效率极高,原理为:Linux 在内核态完成虚拟接口间的数据拷贝转发,发送接口缓冲区中的数据包会直接复制至接收接口缓冲区,全程无需经由外部物理网卡完成交换。
Docker 服务启动时会默认创建名为 docker0 的 Linux 网桥,并配套生成 docker0 内部接口。该组件依托 Linux 虚拟网络技术,会分别在宿主机与容器内部创建一对互通的虚拟接口,该成对接口被称为 veth pair。Docker 会为 docker0 预设固定 IP 地址与子网掩码,以此实现宿主机和容器通过网桥互通。
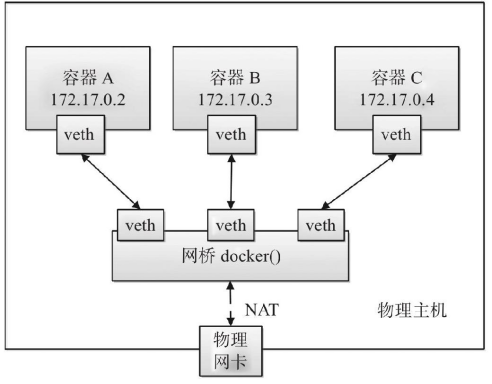
外部宿主机若要访问容器服务,必须通过端口映射机制实现。
Containerd 单机网络
Containerd 的单机网络实现逻辑与 Docker 高度一致,所有网络接口默认均为虚拟接口。
创建容器时,Containerd 会分别在宿主机、容器内部各生成一个虚拟接口,并将二者建立连通关系。
跨主机网络通信
跨主机网络通信架构
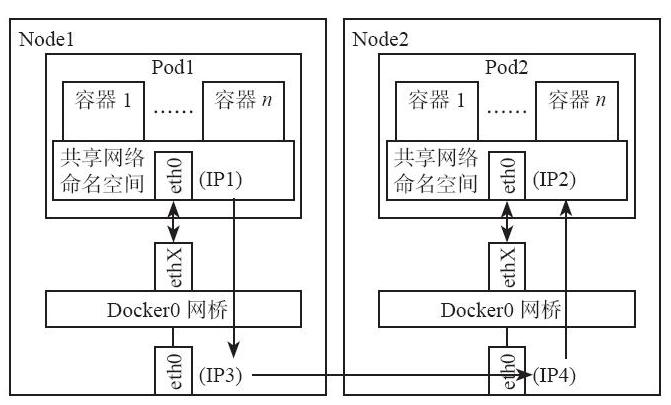
可供选择的跨主机通信方案种类较多,主要分为两类:
- Docker 原生方案:overlay、macvlan。
- 第三方开源方案:flannel、calico、weave 等。
选型时重点评估两大维度:部署配置复杂度、是否原生支持网络策略。
下表参数整理自《kubernetes 权威指南》:
| 方案 特性 | Flannel | Calico | macvlan | OpenVswitch | 直接路由 |
|---|---|---|---|---|---|
| 方案特性 | 通过虚拟设备 flannel0 实现对 docker0 的管理 | 基于 BGP 协议的纯三层的网络方案 | 基于 Linux Kernel 的 macvlan 技术 | 基于隧道的虚拟路由器技术 | 基于 Linux Kernel 的 vRouter 技术 |
| 对底层网络的要求 | 三层互通 | 三层互通 | 二层互通 | 三层互通 | 二层互通 |
| 配置难易程度 | 简单 - 基于 etcd | 简单 - 基于 etcd | 简单 - 直接使用宿主机网络,需要仔细规划 IP 地址 | 复杂 - 需手工配置个节点的 bridge | 简单 - 使用宿主机 vRoute 功能,需要仔细规划每个 Node 的 IP 地址 |
| 网络性能 | host-gw > VxLAN | BGP 模式性能损耗小 | 性能损耗可忽略 | 性能损耗较小 | 性能损耗较小 |
| 网络连通性限制 | 无 | 在不支持 BGP 的网络环境下无法使用 | 基于 macvlan 的容器无法与宿主机网络通信 | 无 | 在无法实现大二层互通的网络环境下无法使用 |
跨主机通信方案
下文将从五大核心维度对比各类方案,可根据业务场景匹配最优方案:
- 网络模型:依托何种网络模型支撑多主机容器互通?
- Distributed Store:是否依赖 etcd、consul 等分布式键值数据库存储网络元数据?
- IPAM:容器 IP 地址的分配与管理机制?
- 连通与隔离:提供何种跨容器连通能力?支持哪些层级、类型的流量隔离?
- 性能:不同方案的网络转发性能对比。
网络模型
跨主机网络的核心目标是将分布在不同节点的容器纳入同一套虚拟网络,这套虚拟网络的拓扑结构与底层实现技术,即为网络模型。
Underlay:直接复用底层物理网络转发 Pod 流量,不存在数据包隧道封装,依靠静态路由或二层交换完成通信。
Overlay:在宿主机物理网络之上构建虚拟隧道,数据包会额外封装一层外层头部;底层物理网络仅转发宿主机 IP 报文,无需感知 Pod 网段信息。
Flannel
Flannel 提供两种主流工作模式
- host-gw(Underlay)
- 实现原理:在各节点配置静态路由,目标 Pod 网段的下一跳指向对应宿主机 IP;全程无报文封装操作。
- 流量转发:Pod 原始 IP 数据包直接在底层物理网络传输。
- 使用约束:底层网络支持跨节点 Pod 网段路由转发;公有云环境大多不满足该条件。
- 性能表现:转发性能优异。
- VXLAN(Overlay)
- 实现原理:跨节点 Pod 报文封装 UDP VXLAN 头部,经由宿主机网络传输,到达目标节点后完成解封装。
- 使用约束:仅要求宿主机之间三层网络互通,公有云场景通用。
- 性能表现:存在封包、解包带来的 CPU 开销,性能低于 host-gw 模式。
Flannel 仅负责容器间网络连通,不支持 NetworkPolicy 网络策略。
Calico
- BGP 模式(Underlay 设计思路)
- 节点间通过 BGP 协议同步 Pod 路由条目,无隧道封装,采用原生 IP 转发。
- 性能最优;前置条件:网络环境允许 BGP 协议发布路由。
- IPIP / VXLAN 模式(Overlay 隧道)
- 底层网络不支持 BGP 时启用 IP-in-IP 隧道封装,数据包外层追加宿主机 IP 头部。
- 适配公有云环境;封装机制会带来一定性能损耗。
Calico 最核心的优势:原生支持 NetworkPolicy(Pod 防火墙访问控制策略)。
Weave(Weave Net)
默认采用 Overlay(UDP 隧道)
-
工作机制:节点间建立 UDP 隧道封装 Pod 流量,内置集群节点自动发现能力。
-
特色能力:
- 内置集群 DNS 解析;
- 支持 NetworkPolicy;
- 可部署加密隧道传输流量;
-
短板缺陷:
隧道封装持续占用服务器 CPU 资源,大规模集群场景下性能弱于 Flannel VXLAN、Calico。
Weave 虽提供 MAC 快速路由优化方案,但主体网络模型仍归类为 Overlay。
Macvlan
Macvlan 属于 Underlay 方案
-
实现原理:在宿主机物理网卡上虚拟出多张独立子网卡,每个 Pod 分配独立 MAC 地址,Pod 直接接入底层物理局域网。
-
流量转发:Pod 原生报文直接在二层物理网络转发,不存在任何隧道封装。
✅ 优势:转发性能极高,Pod 与物理服务器网络地位对等,网络延迟极低。
❌ 使用限制:
- 宿主机父网卡不可开启桥接模式;
- 挂载同一父网卡的 Macvlan 子接口无法直接互通,存在同节点 Pod 通信缺陷;
- IP 网段规划复杂度高,传统虚拟化环境易产生地址冲突。
典型适用场景:需要为 Pod 分配局域网独立 IP、业务对网络延迟敏感。
| CNI 方案 | 可用网络模型 | 是否隧道封装 | 支持 NetworkPolicy | 适用场景 |
|---|---|---|---|---|
| Flannel | host-gw(Underlay)、VXLAN(Overlay) | VXLAN 封装;host-gw 无封装 | ❌ 不支持 | 追求部署简单、无需 Pod 访问控制;中小型集群 |
| Calico | BGP(Underlay)、IPIP/VXLAN(Overlay) | IPIP/VXLAN 封装;BGP 无封装 | ✅ 原生支持 | 需要网络策略管控、自建机房与公有云通用 |
| Weave Net | UDP 隧道 Overlay | UDP 封装 | ✅ 支持 | 测试环境、小规模集群;部署便捷,无需依赖 etcd |
| Macvlan | Underlay(二层直连物理网络) | ❌ 无任何封装 | 取决于配套 CNI | Pod 需要占用局域网独立 IP、低延迟业务 |
Distributed Store
Docker Overlay、Flannel、Calico 均依赖 etcd 或 consul 存储集群网络元数据。Macvlan 属于单机本地网络方案,无需存储、同步网络信息。Weave 内置节点间配置同步机制,同样不需要分布式存储组件。
IPAM
- Docker Overlay 网络内所有主机共享同一子网,容器启动时按顺序分配 IP,可通过
--subnet参数自定义地址池。 - Macvlan 需由运维人员自行规划子网、分配容器 IP,跨子网通信依赖外部网关设备。
- Flannel 为每个节点自动分配独立子网,运维仅需定义全局大地址池,节点间子网路由由 Flannel 自动生成、下发。
- Weave 默认全部容器共用 10.32.0.0/12 子网,若该网段与现有业务 IP 冲突,可通过
--ipalloc-range自定义地址段。 - Calico 从可自定义的 IP Pool 地址池中为各节点分配独立子网。
连通与隔离
- 同一 Docker Overlay 网络内的容器可直接互通,不同网络间默认隔离;若需跨网络访问,需将容器同时加入多张网络。容器访问外网依托 docker_gwbridge 网络实现。
- Macvlan 的流量连通、隔离逻辑完全由二层 VLAN 划分与三层路由规则控制。
- 不同 Flannel 网络下的容器默认互通,未提供原生隔离能力;容器访问外网依托宿主机 bridge 网络。
- Weave 默认所有容器归属同一大子网,可自由互通;如需隔离,需为容器划分独立子网或限定 IP 段。容器访问外网的方案为将宿主机接入 Weave 网络,以宿主机作为流量网关。
- Calico 默认仅允许同一网络内容器互通,依托功能完备的 Policy 组件可实现几乎全场景的精细化访问控制。
性能
完整的网络性能测试属于严谨、复杂的工程工作,此处仅从底层技术原理对比各方案性能差异。
基础判断准则:Underlay 网络整体转发性能优于 Overlay 网络。
- **Overlay 网络依托隧道技术,将原始数据包封装至 UDP 报文传输。**封包、解包操作会带来额外 CPU 算力与网络带宽开销。尽管主流 Overlay 方案均采用 Linux 内核 vxlan 模块降低损耗,但对比 Underlay 方案仍存在明显性能差距。因此 Macvlan、Flannel host-gw、Calico BGP 模式性能优于 Docker overlay、Flannel vxlan、Weave。
- Overlay 方案也具备独有优势:可承载更多二层网段、更好复用现有物理网络架构、避免交换机 MAC 地址表溢出等。选型时需结合业务需求综合权衡。
跨主机网络模型
容器网络的配置流程复杂,行业内衍生出 flannel、calico、kube-ovn、weave 等多种网络解决方案;同时容器运行平台种类繁多,包含 Kubernetes、Openshift、rkt 等。
为解决网络插件与容器平台强耦合的问题,行业定义了一套抽象接口层,实现网络方案与容器调度平台解耦。
CNM
CNM(Container Network Model,容器网络模型),由 Docker 公司提出,在 Docker 配套 libnetwork 项目中落地实现。基于该模型开发的驱动程序,可与 docker daemon 协同完成容器网络配置。
- Docker 原生内置驱动:none、bridge、overlay、macvlan。
- 第三方扩展驱动:flannel、weave、calico 等。
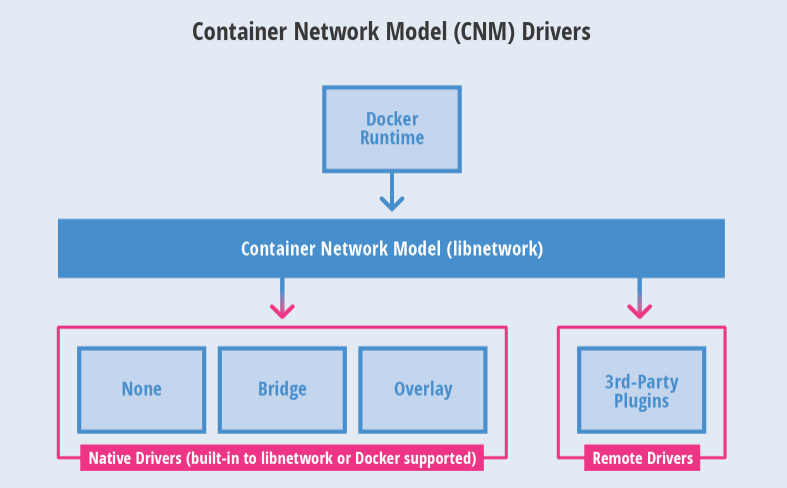
CNM 对容器网络进行标准化抽象,包含三大核心组件:
- Sandbox:代表容器独立网络协议栈,包含容器网卡、路由表、DNS 配置;标准实现为 Linux Network Namespace。单个 Sandbox 可挂载来自多张网络的 Endpoint。
- Endpoint:负责将 Sandbox 接入网络,典型实现为 veth pair。一个 Endpoint 仅能归属一张网络、一个 Sandbox。
- Network:由一组 Endpoint 组成,同一 Network 下所有 Endpoint 可直接互通;底层可基于 Linux Bridge、VLAN 等技术实现。
下图示例包含两个容器,每个容器对应独立 Sandbox;两个 Sandbox 均通过 Endpoint 接入 Network 1,第二个 Sandbox 额外新增 Endpoint 接入 Network 2。
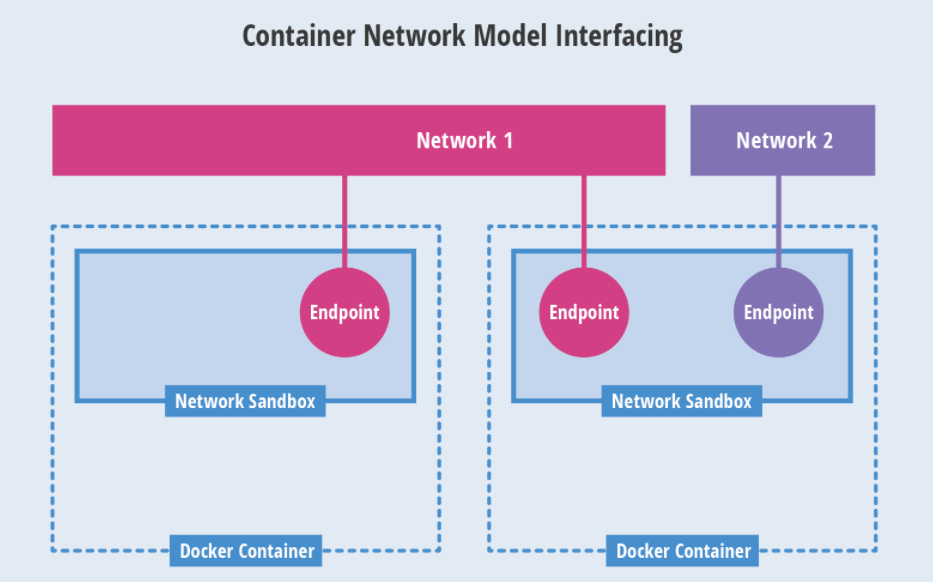
下面以 docker bridge 驱动为例,讲解 libnetwork CNM 的落地实现逻辑:
- 两张网络:默认 bridge 网络、自定义 my_net2 网络,底层分别依托 Linux Bridge docker0、br-5d863e9f78b6 实现。
- 三组 Endpoint,均由 veth pair 实现:一端 vethxxx 挂载至 Linux Bridge,另一端 eth0 留存于容器内部。
- 三套 Sandbox,依托 Network Namespace 隔离,每个容器独占一套 Sandbox。
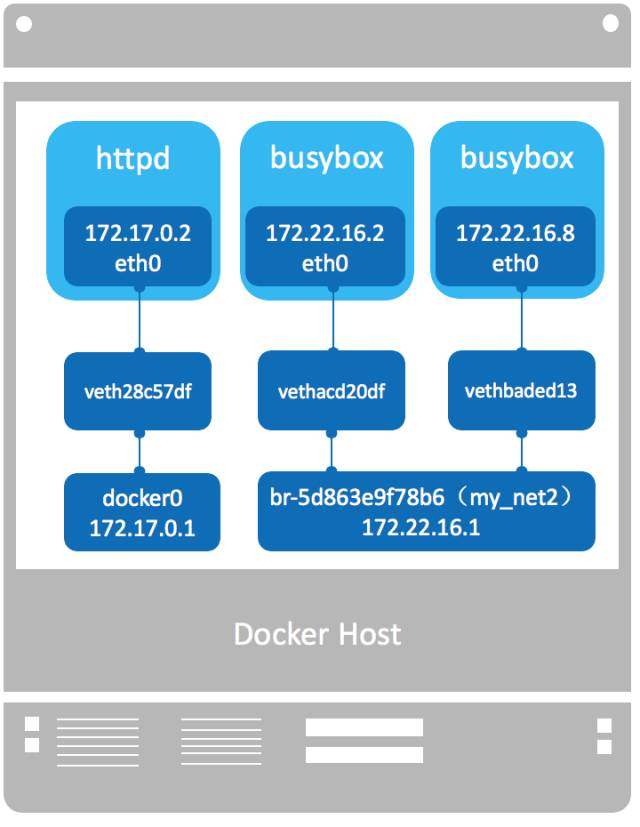
CNI,全称 Container Network Interface,由 Google 与 CoreOS 联合制定的网络标准。CNI 规范定义了容器与网络插件之间的通信接口,实现多类容器运行时统一对接网络插件,各厂商可基于该接口开发兼容插件。
单个容器可同时接入由不同插件驱动的多张独立网络;每张网络绑定专属插件与唯一名称。
CNI 模型包含两大核心概念:
- 容器:拥有独立 Linux 网络命名空间的运行实例。
- 网络:用于互联各类实体,实体包含独立唯一 IP,可为容器、物理服务器或其他网络设备。
网络配置通过两类插件协同完成:CNI Plugin、IPAM(IP address management)Plugin。
- CNI Plugin:负责配置容器网卡、路由等基础网络参数。
- IPAM Plugin:负责为容器分配、回收 IP 地址。
IPAM Plugin 作为 CNI Plugin 的配套组件,与网络插件协同工作。
CNM 和 CNI 比较
| 特点 | CNM | CNI |
|---|---|---|
| 标准规范 | Libnetwork | cni |
| 最小管理单元 | 容器 | POD |
| 守护进程依赖 | 强依赖 dockerd | 不依赖任何常驻守护进程 |
| 跨主机通信存储 | 依赖外部 KV 数据库 | 插件内置 KV 存储能力 |
| 灵活扩展程度 | 与 Docker 深度绑定 | 插件可按需替换 |
网络策略介绍
集群初始化完成后,默认网络连通规则如下:
- 集群外部主机可直接访问集群内部业务 Pod;
- 集群内部 Pod 可主动访问集群外部主机;
- 不同命名空间下的 Pod 无任何流量隔离限制。
若需在 IP、端口粒度精细化管控网络流量,可使用 Kubernetes NetworkPolicy(网络策略)。
- NetworkPolicy 是以应用为核心的资源对象,可定义 Pod 与网络中各类实体之间的访问放行规则。
- NetworkPolicy 仅管控一端或两端为 Pod 的连接,不作用于其余网络流量。
重要提示:网络策略由网络插件实际落地生效。如需使用 NetworkPolicy,集群必须部署支持该特性的网络方案,典型代表为 calico。
网络策略规约
Pod 的流量隔离分为两类:出站隔离、入站隔离。
- 默认状态下,Pod 出站流量无隔离限制,所有对外连接全部放行。若存在任意 NetworkPolicy 匹配该 Pod,且
policyTypes字段包含 “Egress”,则该 Pod 启用出站隔离。启用出站隔离后,仅匹配该 Pod 所有出站策略egress规则的流量允许通行;多条出站规则的放行范围取并集。 - 默认状态下,Pod 入站流量无隔离限制,所有外部连接全部放行。若存在任意 NetworkPolicy 匹配该 Pod,且
policyTypes字段包含 “Ingress”,则该 Pod 启用入站隔离。启用入站隔离后,仅来自节点本地、或匹配该 Pod 入站策略ingress规则的流量允许通行;多条入站规则的放行范围取并集。
多条网络策略为叠加生效,不存在规则冲突问题。 策略匹配顺序不会对最终放行结果产生影响。
源 Pod 的出站策略、目标 Pod 的入站策略需同时放行,两端 Pod 才能建立连接。 任意一方策略拦截流量,连接都会建立失败。
示例:
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: test-network-policy
  namespace: default
spec:
  # 使用标签过滤限制哪些pod
  podSelector:
    matchLabels:
      role: db
  policyTypes:
  # Ingress控制外部访问内部
  - Ingress
  # Egress控制pod访问外部
  - Egress
  ingress:
  # from限制允许哪些主机可以访问pod
  - from:
    # 通过ip限制
    - ipBlock:
        cidr: 172.17.0.0/16
        except:
        - 172.17.1.0/24
    # 限制namespace中pod
    - namespaceSelector:
        matchLabels:
          project: myproject
    # 限制同一namespace中pod
    - podSelector:
        matchLabels:
          role: frontend
    # 限制pod上哪些端口可以访问
    ports:
    - protocol: TCP
      port: 6379
  egress:
  - to:
    - ipBlock:
        cidr: 10.0.0.0/24
    ports:
    - protocol: TCP
      port: 5978
- 必填字段:与所有 Kubernetes 资源配置一致,NetworkPolicy 必须包含
apiVersion、kind、metadata。 - spec:NetworkPolicy 规约,承载单个命名空间内流量管控的全部规则定义。
- spec.podSelector:每条 NetworkPolicy 均包含 podSelector,用于筛选当前策略管控的 Pod 集合;空 podSelector 代表匹配命名空间内全部 Pod。
- spec.policyTypes:每条策略需声明 policyTypes 列表,取值为 Ingress、Egress 或二者同时声明,标识该策略管控入站、出站或双向流量。若策略未配置 policyTypes,默认仅开启 Ingress;若存在出站规则,则自动追加 Egress。
- spec.ingress:入站白名单规则列表,单条规则同时匹配
from来源与ports端口才允许通行。示例中包含一条入站规则,匹配指定端口,来源分为三类:指定 IP 段、带特定标签命名空间内所有 Pod、同命名空间带指定标签 Pod。 - spec.egress:出站白名单规则列表,单条规则同时匹配
to目标地址与ports端口才允许通行。示例规则允许 Pod 访问 10.0.0.0/24 网段的 TCP 5978 端口。
to 和 from 选择器
可在 ingress 的 from 段、egress 的 to 段配置四类流量来源 / 目标筛选器:
-
podSelector:筛选与当前 NetworkPolicy 同命名空间内的 Pod,作为入站流量来源或出站流量目标。
-
namespaceSelector:筛选指定命名空间,该命名空间下所有 Pod 均作为入站流量来源或出站流量目标。
-
namespaceSelector 搭配 podSelector:同时指定命名空间与 Pod 标签,仅匹配该命名空间内带对应标签的 Pod。
示例:
... ingress: - from: - namespaceSelector: matchLabels: user: alice podSelector: matchLabels: role: client ...from数组包含两组条件,放行两类流量:本地命名空间中带role=client标签的 Pod,或 任意命名空间中带user=alice标签的所有 Pod。两类条件为或关系。 -
ipBlock:筛选指定 CIDR IP 网段,作为入站流量来源或出站流量目标。该配置多用于集群外部 IP,因为 Pod IP 生命周期短、动态分配。
集群入站、出站流量处理链路常存在源 / 目标 IP 重写逻辑,重写时机随网络插件、云厂商、Service 实现方案变化,因此 ipBlock 匹配行为存在不确定性:
- 入站流量:部分场景可基于原始访问源 IP 过滤数据包,部分场景下策略识别到的源 IP 为 LoadBalancer 或节点 IP。
- 出站流量:Pod 访问 Service ClusterIP 时,流量经 IP 重写后,是否匹配 ipBlock 规则无统一标准,依赖底层组件实现。
实施网络策略
准备实验环境
环境说明:
- namespace-web 命名空间包含 3 个 Pod:web1、web2、test
- namespace-laoma 命名空间包含 1 个 Pod:test
- 无特殊说明时,默认操作命名空间为 web
root@master30 ~ 09:43:49# kubectl create ns web
namespace/web created
root@master30 ~ 10:21:55# kubectl config set-context --current --namespace web
Context "kubernetes-admin@kubernetes" modified.
# 创建 web1
root@master30 ~ 10:21:59# kubectl run web1 --image=hub.laoma.cloud/library/nginx --image-pull-policy=IfNotPresent
pod/web1 created
root@master30 ~ 10:22:34# kubectl exec -it web1 -- bash -c 'echo Hello web1 > /usr/share/nginx/html/index.html'
# 创建 web2
root@master30 ~ 10:23:24# kubectl run web2 --image=hub.laoma.cloud/library/nginx --image-pull-policy=IfNotPresent
pod/web2 created
root@master30 ~ 10:23:49# kubectl exec -it web2 -- bash -c 'echo Hello web2 > /usr/share/nginx/html/index.html'
# 创建service web1和web2
root@master30 ~ 10:24:00# kubectl expose pod web1 --port=80 --target-port=80 --type=NodePort
service/web1 exposed
root@master30 ~ 10:24:43# kubectl expose pod web2 --port=80 --target-port=80 --type=NodePort
service/web2 exposed
root@master30 ~ 10:24:52# kubectl get service
NAME   TYPE       CLUSTER-IP      EXTERNAL-IP   PORT(S)        AGE
web1   NodePort   10.111.6.137    <none>        80:30197/TCP   15s
web2   NodePort   10.97.189.128   <none>        80:31796/TCP   6s
# 同一namespace中web1和web2互相访问
root@master30 ~ 10:24:58# kubectl run test --image=hub.laoma.cloud/library/nginx
pod/test created
root@master30 ~ 10:25:30# kubectl exec =it test -- curl -s web1
Error from server (NotFound): pods "=it" not found
root@master30 ~ 10:25:50# kubectl exec -it test -- curl -s web1
Hello web1
root@master30 ~ 10:26:00# kubectl exec -it test -- curl -s web2
Hello web2
# 在不同namespace-laoma中创建测试pod-test,访问web1和web2
root@master30 ~ 10:26:03# kubectl create ns liu
namespace/liu created
root@master30 ~ 10:26:28# kubectl run test -n liu --image=hub.laoma.cloud/library/nginx
pod/test created
root@master30 ~ 10:26:52# kubectl exec -n liu test -- curl -s web1.web
Hello web1
root@master30 ~ 10:27:12# kubectl exec -n liu test -- curl -s web2.web
Hello web2
# 集群内访问service web1和web2
root@master30 ~ 10:27:16# curl 10.111.6.137
Hello web1
root@master30 ~ 10:27:35# curl 10.97.189.128
Hello web2
根据 pod 标签限定
基于 Pod 标签实现流量管控,适用场景:
- 限制同命名空间内 Pod 互相访问;
- 拦截其他命名空间 Pod、集群外部主机访问当前命名空间业务 Pod。
示例 1:仅允许同命名空间内携带标签run: test的 Pod,访问携带run: web1标签 Pod 的 TCP 80 端口。
root@master30 ~ 10:33:34# vim netpol.yaml
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: my-network-policy
spec:
  podSelector:
    matchLabels:
      run: web1
  policyTypes:
  - Ingress
  ingress:
  - from:
    - podSelector:
        matchLabels:
          run: test
    ports:
    - protocol: TCP
      port: 80
# 创建network policy
root@master30 ~ 10:34:19# kubectl apply -f netpol.yaml
networkpolicy.networking.k8s.io/my-network-policy created
root@master30 ~ 10:34:32# kubectl get netpol
NAME                POD-SELECTOR   AGE
my-network-policy   run=web1       13s
# 同一namespace中test可以访问web1,web2不可以访问web1
root@master30 ~ 10:34:45# kubectl exec test -- curl -s web1
Hello web1
# 不同 namespace 中pod,标签满足不可以访问
root@master30 ~ 10:35:04# kubectl exec test -n liu -- curl -s --connect-timeout 3 web1.web
command terminated with exit code 28
# 修改现有标签,同一命名空间的test pod也无法访问了。
root@master30 ~ 10:45:23# kubectl label pod test run=web2 --overwrite
pod/test labeled
root@master30 ~ 10:45:44# kubectl get pods --show-labels
NAME   READY   STATUS    RESTARTS   AGE   LABELS
test   1/1     Running   0          20m   run=web2
web1   1/1     Running   0          23m   run=web1
web2   1/1     Running   0          22m   run=web2
# 超时退出
root@master30 ~ 10:46:02# kubectl exec test -- curl -s --connect-timeout 3 web1
command terminated with exit code 28
示例 2:允许当前命名空间内全部 Pod,访问携带run: web1标签 Pod 的 TCP 80 端口。
将 podSelector: {} 置空,代表匹配当前命名空间下所有 Pod。
root@master30 ~ 10:46:42# vim netpol.yaml
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: my-network-policy
spec:
  podSelector:
    matchLabels:
      run: web1
  policyTypes:
  - Ingress
  ingress:
  - from:
    - podSelector: {}
    ports:
    - protocol: TCP
      port: 80
# 应用策略
root@master30 ~ 10:47:04# kubectl apply -f netpol.yaml
networkpolicy.networking.k8s.io/my-network-policy configured
# 同一namespace中所有pod都可以访问web1
root@master30 ~ 10:47:15# kubectl exec test -- curl -s web1
Hello web1
root@master30 ~ 10:47:44# kubectl exec web2 -- curl -s web1
Hello web1
# 不同namespace中pod不可以访问web1
root@master30 ~ 10:48:37# kubectl exec test -n liu -- curl -s --connect-timeout 3 web1.web
command terminated with exit code 28
示例 3:仅允许同命名空间内携带run: test标签的 Pod,访问当前命名空间内所有 Pod 的 TCP 80 端口。
podSelector: {} 置空,代表管控当前命名空间全部 Pod。
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: my-network-policy
spec:
  podSelector: {}
  policyTypes:
  - Ingress
  ingress:
  - from:
    - podSelector:
        matchLabels:
          run: test
    ports:
    - protocol: TCP
      port: 80
根据 pod 所属 ns 限定
用于管控来自其他命名空间 Pod 的访问流量。
示例 1:允许携带project: myproject标签的命名空间内全部 Pod,访问当前 web 命名空间下带run: web1标签 Pod 的 TCP 80 端口。
root@master30 ~ 10:48:53# vim netpol.yaml
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: my-network-policy
  namespace: web
spec:
  podSelector:
    matchLabels:
      run: web1
  policyTypes:
  - Ingress
  ingress:
  - from:
    - namespaceSelector:
        matchLabels:
          project: myproject
    ports:
    - protocol: TCP
      port: 80
# 应用策略
root@master30 ~ 10:49:28# kubectl apply -f netpol.yaml
networkpolicy.networking.k8s.io/my-network-policy configured
# 此时namespace-web中pod和namespace-laoma中pod都无法访问web1
root@master30 ~ 10:50:07# kubectl exec test -- curl -s --connect-timeout 3 web1
command terminated with exit code 28
root@master30 ~ 10:50:30# kubectl exec -n liu test -- curl -s --connect-timeout 3 web1.web
command terminated with exit code 28
# 给namespace-laoma添加标签project=myproject,此时namespace-laoma中pod可以访问web1.web
root@master30 ~ 10:51:03# kubectl label namespaces liu project=myproject
namespace/liu labeled
root@master30 ~ 10:51:29# kubectl exec -n liu test -- curl -s web1.web
Hello web1
示例 2:允许集群内所有命名空间下全部 Pod,访问当前 web 命名空间带run: web1标签 Pod 的 TCP 80 端口。
root@master30 ~ 10:51:50# vim netpol.yaml
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: my-network-policy
  namespace: web
spec:
  podSelector:
    matchLabels:
      run: web1
  policyTypes:
  - Ingress
  ingress:
  - from:
    - namespaceSelector: {}
    ports:
    - protocol: TCP
      port: 80
# 创建network policy
root@master30 ~ 10:52:28# kubectl apply -f netpol.yaml
networkpolicy.networking.k8s.io/my-network-policy configured
# 所有namespace中所有pod都可以访问web1
root@master30 ~ 10:52:36# kubectl exec test -- curl -s web1
Hello web1
root@master30 ~ 11:05:15# kubectl exec -n liu test -- curl -s web1.web
Hello web1
根据 pod IP 限定
示例 1:放行 10.1.8.0/24 网段流量,但拦截其中 10.1.8.128/26 子网,允许匹配网段内主机访问带run: web1标签 Pod 的 TCP 80 端口。
root@master30 ~ 11:05:29# vim netpol.yaml
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: my-network-policy
  namespace: web
spec:
  podSelector:
    matchLabels:
      run: web1
  policyTypes:
  - Ingress
  ingress:
  - from:
    - ipBlock:
        # 放行 网段10.1.8.0/24
        cidr: 10.1.8.0/24
        # 不放行网段
        except:
        - 10.1.8.128/26
    ports:
    - protocol: TCP
      port: 80
# 应用策略
root@master30 ~ 11:09:09# kubectl apply -f netpol.yaml
networkpolicy.networking.k8s.io/my-network-policy configured
# 访问失败
root@master30 ~ 11:09:18# kubectl exec test -- curl -s web1
root@master30 ~ 11:09:38# kubectl exec -n liu test -- curl -s web1.web
root@master30 ~ 11:10:50# kubectl get svc
NAME   TYPE       CLUSTER-IP      EXTERNAL-IP   PORT(S)        AGE
web1   NodePort   10.111.6.137    <none>        80:30197/TCP   46m
web2   NodePort   10.97.189.128   <none>        80:31796/TCP   46m
root@master30 ~ 11:11:01# curl http://10.1.8.30:30197
root@master30 ~ 11:11:21# curl http://10.1.8.31:30197
# 访问成功失败
root@master30 ~ 11:11:30# curl http://10.1.8.32:30197
Hello web1
# 理论上:10.1.8.0/24网段中主机都可以通过集群任意节点访问web1
# 实际测试:只可以通过pod所在主机的IP访问web1 (10.1.8.32:30790),不可以访问10.1.8.30:30790或10.1.8.31:30790
# 在worker31上也可以通过10.103.36.143访问pod-web1
root@master30 ~ 11:11:33# kubectl describe pod web1|grep Node:
Node:             worker32.liu.cloud/10.1.8.32
从实验测试结果可见,基于 IP 网段管控访问来源的能力仍存在不完善之处。
如需放行全网流量、仅拦截指定网段,规则写法如下:
    - ipBlock:
        cidr: 0.0.0.0/0
        except:
        - 10.1.8.0/26
默认策略
默认允许所有入站流量
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-all-ingress
spec:
  podSelector: {}
  policyTypes:
  - Ingress
  ingress:
  - {}
默认拒绝所有入站流量
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-ingress
spec:
  podSelector: {}
  policyTypes:
  - Ingress
该策略会确保命名空间内所有 Pod 启用入站隔离,即便没有其他匹配策略也会拦截全部入站流量;不会修改默认出站放行规则。
默认允许所有出站流量
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-all-egress
spec:
  podSelector: {}
  policyTypes:
  - Egress
  egress:
  - {}
默认拒绝所有出站流量
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-egress
spec:
  podSelector: {}
  policyTypes:
  - Egress
该策略会拦截命名空间所有 Pod 的全部出站流量;不会修改默认入站放行规则。
默认拒绝所有入口和所有出站流量
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-all
spec:
  podSelector: {}
  policyTypes:
  - Ingress
  - Egress
该策略会对命名空间内全部 Pod 同时启用入站、出站双向流量隔离,无匹配放行规则时所有网络连接都会被拦截。
无法完成的工作
NetworkPolicy 存在功能边界,以下需求无法通过该资源实现:
- 基于节点维度定义管控策略。
- 基于资源名称匹配流量。
- 配置全局生效、覆盖全部命名空间与 Pod 的默认隔离规则。
- 定义显式拦截规则。NetworkPolicy 仅支持白名单放行逻辑,不存在黑名单拒绝语法。
- 拦截本地回环流量、Pod 访问宿主机的流量。Pod 无法阻断 localhost 内部访问,也不能拦截来自所在节点的访问请求。
环境清理
root@master30 ~ 11:24:35# kubectl delete ns network  liu
namespace "network" deleted
namespace "liu" deleted
root@master30 ~ 11:32:53# kubectl delete ns web
namespace "web" deleted
Kubernetes Pod Scheduler
学习参考:调度、抢占和驱逐
环境准备
root@master30 ~ 11:33:33# kubectl create ns scheduler
namespace/scheduler created
root@master30 ~ 11:40:36# kubectl config set-context --current --namespace scheduler
Context "kubernetes-admin@kubernetes" modified.
调度介绍
Kubernetes 调度指将 Pod 分配至适配节点运行的完整流程。
kube-scheduler 是 Kubernetes 集群内置的默认调度组件,它通过监听(Watch)机制捕获集群内尚未完成节点绑定的 Pod,并为这类未调度 Pod 匹配最合适的节点执行部署。
调度过程
kube-scheduler 的核心工作是为新建或未绑定节点的 Pod 筛选最优运行节点。由于 Pod 及容器存在多样化资源、部署约束要求,调度器会先过滤所有无法满足 Pod 调度条件的节点。
调度专业术语:
- 能够满足 Pod 全部调度约束的节点集合,统称为 可调度节点。
- 调度器将 Pod 与选定节点建立关联绑定的操作,称为 绑定。
Kubernetes 完整调度流程分为两大阶段:
- 节点过滤:筛选出所有满足 Pod 调度需求的节点。典型过滤逻辑如
PodFitsResources,会校验候选节点剩余 CPU、内存等资源是否能覆盖 Pod 资源申请。过滤完成后会生成可调度节点列表,通常包含多个节点;若列表为空,则代表当前集群无节点可承载该 Pod,Pod 将处于未调度状态。 - 节点打分:基于集群启用的各项打分规则,为每一个可调度节点计算综合得分,调度器最终将 Pod 绑定至得分最高的节点。若存在多个节点同分,kube-scheduler 会在高分节点中随机选取其一。
调度器做节点决策时,会综合考量以下维度:
- Pod 单独资源申请、集群整体资源占用情况
- 硬件规格、软件依赖、集群管控策略限制
- Pod 节点亲和、反亲和部署约束
- 数据本地存储就近访问需求
- 多业务负载之间的资源干扰隔离
- 其他自定义调度约束
Kubernetes 提供两套配置方案,用于自定义调度器的过滤、打分逻辑:
- 调度策略:通过配置 断言(Predicates) 定义过滤规则,通过 优先级(Priorities) 定义打分规则。
- 调度配置:支持分阶段配置调度插件,覆盖
QueueSort、Filter、Score、Bind、Reserve、Permit等全调度生命周期环节。
过滤
下述 断言(Predicates) 为内置节点过滤校验规则:
PodFitsHostPorts:校验节点是否存在空闲端口,匹配 Pod 声明的端口协议与占用需求。PodFitsHost:校验 Pod 是否通过主机名指定了固定运行节点。PodFitsResources:校验节点剩余 CPU、内存等硬件资源,能否满足 Pod 的资源申请规格。MatchNodeSelector:校验 Pod 的节点选择器标签是否与节点自身标签完全匹配。NoVolumeZoneConflict:结合存储故障域限制,校验 Pod 请求的存储卷能否在当前节点挂载使用。NoDiskConflict:校验 Pod 请求挂载的存储卷,是否与节点上已挂载卷存在挂载冲突。MaxCSIVolumeCount:统计节点已挂载 CSI 存储卷数量,判断新增挂载是否超出集群配置上限。PodToleratesNodeTaints:校验 Pod 的容忍度配置能否兼容节点上设置的污点规则。CheckVolumeBinding:校验 Pod 关联的持久卷声明(PVC)能否在该节点完成挂载,同时支持已绑定、未绑定状态的 PVC 校验。
计分
下述 优先级(Priorities) 为内置节点打分策略:
SelectorSpreadPriority:实现 Pod 跨节点分散部署,针对同一服务、有状态集、副本集归属的 Pod 做均衡打散。InterPodAffinityPriority:实现 Pod 间亲和、反亲和的偏好型调度权重计算。LeastRequestedPriority:优先选择资源占用率更低的节点;节点上运行 Pod 越多、资源消耗越高,该策略给出的分值越低。MostRequestedPriority:优先选择资源占用率更高的节点,通过集中负载,减少集群整体所需运行节点数量。RequestedToCapacityRatioPriority:基于资源申请量与节点总容量的比值,生成标准化资源打分函数。BalancedResourceAllocation:优先选择 CPU、内存资源使用占比更均衡的节点。NodePreferAvoidPodsPriority:读取节点注释scheduler.alpha.kubernetes.io/preferAvoidPods,对节点做优先级排序,用于规避两类 Pod 同节点部署。NodeAffinityPriority:依据PreferredDuringSchedulingIgnoredDuringExecution配置的节点亲和偏好,计算节点权重得分。详细用法可查阅将 Pod 分配给节点官方文档。TaintTolerationPriority:统计节点上 Pod 无法兼容的污点数量,以此调整节点调度优先级。ImageLocalityPriority:优先选择本地已缓存 Pod 所需容器镜像的节点,避免镜像拉取耗时。ServiceSpreadingPriority:保障同一 Service 下的 Pod 尽量分布在不同节点,降低单节点故障对业务的影响,提升服务容灾能力。EqualPriority:为所有候选节点分配相同权重分值。EvenPodsSpreadPriority:实现 Pod 拓扑分布约束的偏好型调度打分。
控制 pod 运行位置
参考学习:将 Pod 指派给节点
我们可以添加约束,限定 Pod 仅能在指定 节点 运行。常规场景下无需手动配置约束,调度器会自动完成合理的节点分配,例如打散 Pod、规避资源不足节点等。但部分业务场景需要强制指定 Pod 运行节点,例如:大量磁盘 IO 负载的业务部署至 SSD 磁盘节点、GPU 计算业务部署至搭载显卡的节点等。
Kubernetes 提供四种方式自定义 Pod 的节点调度逻辑,分别为:
- 与节点名称精准匹配的 nodeName
- 匹配节点标签的 nodeSelector
- 亲和性与反亲和性
- Pod 拓扑分布约束
nodeName
nodeName 属于 PodSpec 顶层字段,填入目标节点名称后,调度器会强制将 Pod 绑定至该节点运行。
nodeName 是最简单的节点指定方式,同时具备最高调度优先级,生产环境一般不推荐使用。
使用 nodeName 存在以下限制:
- 若填写的节点名称不存在,Pod 无法正常启动,甚至会被集群自动回收。
- 若目标节点剩余资源无法满足 Pod 申请规格,调度会直接失败,Pod 事件会标注具体资源不足类型,如内存耗尽
OutOfmemory、CPU 资源耗尽OutOfcpu。 - 云厂商集群中,节点名称通常不固定、不可提前预判,适配性较差。
示例:
root@master30 ~ 11:40:53# kubectl create deployment webapp --image nginx --replicas 2 -o yaml --dry-run=client > deploy-with-nodeName.yaml
root@master30 ~ 11:41:39# vim deploy-with-nodeName.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: webapp
  name: webapp
spec:
  replicas: 2
  selector:
    matchLabels:
      app: webapp
  strategy: {}
  template:
    metadata:
      labels:
        app: webapp
    spec:
      # 添加nodeName配置
      nodeName: worker32.liu.cloud
      containers:
      - image: nginx
        name: nginx
root@master30 ~ 11:42:24# kubectl apply -f deploy-with-nodeName.yaml
deployment.apps/webapp created
root@master30 ~ 11:42:37# kubectl get pods -o wide | awk '{print $1,$3,$7}'
NAME STATUS NODE
webapp-6574f9b7f5-bhbrd ContainerCreating worker32.liu.cloud
webapp-6574f9b7f5-hfm24 ContainerCreating worker32.liu.cloud
# 清理资源
root@master30 ~ 11:42:50# kubectl delete deployments.apps webapp
deployment.apps "webapp" deleted
nodeSelector
nodeSelector 定义在 PodSpec 内,由一组键值对标签组成。Pod 仅能调度至同时包含全部键值标签的节点,节点可额外携带其他无关标签。
该配置基于标签(label)实现,也是生产环境最常用的节点约束方案。label 为通用键值标记,集群内各类资源均可绑定标签,灵活扩展资源属性。
提示:nodeSelector 是官方推荐的基础节点筛选方案。
# 查看node标签
root@master30 ~ 13:40:50# kubectl get nodes --show-labels
NAME                 STATUS   ROLES           AGE     VERSION   LABELS
master30.liu.cloud   Ready    control-plane   6d23h   v1.30.2   beta.kubernetes.io/arch=amd64,beta.kubernetes.io/os=linux,kubernetes.io/arch=amd64,kubernetes.io/hostname=master30.liu.cloud,kubernetes.io/os=linux,node-role.kubernetes.io/control-plane=,node.kubernetes.io/exclude-from-external-load-balancers=
worker31.liu.cloud   Ready    <none>          6d22h   v1.30.2   beta.kubernetes.io/arch=amd64,beta.kubernetes.io/os=linux,kubernetes.io/arch=amd64,kubernetes.io/hostname=worker31.liu.cloud,kubernetes.io/os=linux
worker32.liu.cloud   Ready    <none>          6d22h   v1.30.2   beta.kubernetes.io/arch=amd64,beta.kubernetes.io/os=linux,kubernetes.io/arch=amd64,kubernetes.io/hostname=worker32.liu.cloud,kubernetes.io/os=linux
# 为worker31节点添加disktype=ssd标签,标识该节点搭载SSD磁盘
root@master30 ~ 13:40:58# kubectl label node worker31.liu.cloud disktype=ssd
node/worker31.liu.cloud labeled
root@master30 ~ 13:41:26# kubectl get node -L disktype
NAME                 STATUS   ROLES           AGE     VERSION   DISKTYPE
master30.liu.cloud   Ready    control-plane   6d23h   v1.30.2
worker31.liu.cloud   Ready    <none>          6d22h   v1.30.2   ssd
worker32.liu.cloud   Ready    <none>          6d22h   v1.30.2
在 Pod 模板 spec 字段中配置 nodeSelector,限定 Pod 仅部署至携带 disktype=ssd 标签的节点。
root@master30 ~ 13:41:44# vim deploy-with-nodeSelector.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: webapp
  name: webapp
spec:
  replicas: 2
  selector:
    matchLabels:
      app: webapp
  template:
    metadata:
      labels:
        app: webapp
    spec:
      # 添加 nodeSelector
      nodeSelector:
        disktype: ssd
      containers:
      - image: nginx
        name: nginx
root@master30 ~ 13:43:18# kubectl apply -f deploy-with-nodeSelector.yaml
deployment.apps/webapp created
root@master30 ~ 13:43:36# kubectl get pods -o wide | awk '{print $1,$3,$7}'
NAME STATUS NODE
webapp-6d6d67484b-ftp9l Running worker31.liu.cloud
webapp-6d6d67484b-l5m52 Running worker31.liu.cloud
# 删除worker31节点上的disktype标签
root@master30 ~ 13:43:51# kubectl label node worker31.liu.cloud disktype-
node/worker31.liu.cloud unlabeled
root@master30 ~ 13:44:22# kubectl get nodes -L disktype
NAME                 STATUS   ROLES           AGE     VERSION   DISKTYPE
master30.liu.cloud   Ready    control-plane   6d23h   v1.30.2
worker31.liu.cloud   Ready    <none>          6d22h   v1.30.2
worker32.liu.cloud   Ready    <none>          6d22h   v1.30.2
# 节点标签变更不会自动触发Deployment滚动重建
# 通过patch移除Deployment中的nodeSelector配置
root@master30 ~ 13:44:40# kubectl patch deployment webapp --type json \
-p '[{"op":"remove","path":"/spec/template/spec/nodeSelector"}]'
deployment.apps/webapp patched
# 配置变更后自动触发滚动更新
root@master30 ~ 13:44:59# kubectl get pods -o wide | awk '{print $1,$3,$7}'
NAME STATUS NODE
webapp-686868b8c6-2zgv2 Running worker31.liu.cloud
webapp-686868b8c6-rxcqt Running worker32.liu.cloud
# 清理资源
root@master30 ~ 13:45:35# kubectl delete deployments.apps webapp
deployment.apps "webapp" deleted
Affinity and AntiAffinity
亲和性功能分为两大类别:节点亲和性、Pod 间亲和 / 反亲和性。
nodeAffinity
节点亲和性逻辑与 nodeSelector 相似,均可基于节点标签约束 Pod 调度范围,细分两种策略:
requiredDuringSchedulingIgnoredDuringExecution:强制约束,Pod 必须调度至满足规则的节点,等效于nodeSelector的强匹配逻辑。preferredDuringSchedulingIgnoredDuringExecution:偏好约束,调度器优先将 Pod 分配至匹配规则的节点,不做强制限制。
注意:节点运行过程中标签发生修改、删除,已调度至该节点的 Pod 不会被驱逐重建;亲和性规则仅在 Pod 新建调度阶段生效。节点亲和性配置位于 Pod 规约的 .spec.affinity.nodeAffinity 字段。
示例:
root@master30 ~ 13:51:22# vim deploy-with-nodeAffinity.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: web
  name: web
spec:
  replicas: 2
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              - key: CPU
                operator: In
                values:
                - L1
                - L2
          preferredDuringSchedulingIgnoredDuringExecution:
          - weight: 1
            preference:
              matchExpressions:
              - key: MEM
                operator: In
                values:
                - L1
                - L2
      containers:
      - image: hub.laoma.cloud/library/nginx
        name: nginx
示例说明:
- 该规则强制 Pod 仅能部署至带有
CPU=L1或CPU=L2标签的节点;在所有符合强制规则的节点中,调度器会优先选择携带MEM=L1、MEM=L2标签的节点。 preferredDuringSchedulingIgnoredDuringExecution内的weight权重取值范围为 1~100。调度器遍历所有满足资源、强制亲和约束的节点,若节点匹配偏好表达式,则累加对应权重至节点总分,最终与其他打分策略合并计算,总分最高的节点优先分配。operator操作符支持In、NotIn、Exists、DoesNotExist、Gt、Lt六种逻辑,可灵活组合筛选条件。- 借助
NotIn、DoesNotExist可实现节点反亲和效果;也可搭配节点污点,实现 Pod 规避特定节点。 - 若 Pod 同时配置
nodeSelector与nodeAffinity,节点必须同时满足两套规则才可被选中。 - 单个
nodeAffinity下可配置多条nodeSelectorTerms,节点匹配任意一条即可满足强制约束。 - 单条
nodeSelectorTerms内可配置多条matchExpressions,节点必须全部匹配所有表达式才可满足该条筛选规则。
若修改已运行 Pod 所在节点的标签,Pod 不会被驱逐重建;简言之,亲和性校验仅在 Pod 调度阶段执行。
验证 1:节点未添加匹配标签
root@master30 ~ 13:59:45# kubectl apply -f deploy-with-nodeAffinity.yaml
deployment.apps/web created
root@master30 ~ 14:00:01# kubectl get pods -o wide
NAME                  READY   STATUS    RESTARTS   AGE   IP       NODE     NOMINATED NODE   READINESS GATES
web-c74fd5fbd-kjklg   0/1     Pending   0          9s    <none>   <none>   <none>           <none>
web-c74fd5fbd-x57mb   0/1     Pending   0          9s    <none>   <none>   <none>           <none>
验证 2:为节点添加 CPU 标签
root@master30 ~ 14:00:10# kubectl label nodes worker31.liu.cloud CPU=L1
node/worker31.liu.cloud labeled
root@master30 ~ 14:00:31# kubectl label nodes worker32.liu.cloud CPU=L2
node/worker32.liu.cloud labeled
root@master30 ~ 14:00:37# kubectl rollout restart deployment web
deployment.apps/web restarted
# 查看Pod调度分布
root@master30 ~ 14:00:56# kubectl get pods -o wide
NAME                   READY   STATUS    RESTARTS   AGE   IP               NODE                 NOMINATED NODE   READINESS GATES
web-687f74f5b7-pt27f   1/1     Running   0          7s    10.224.218.186   worker32.liu.cloud   <none>           <none>
web-687f74f5b7-q6qkh   1/1     Running   0          6s    10.224.133.102   worker31.liu.cloud   <none>           <none>
验证 3:为 worker32 节点补充 MEM 标签
root@master30 ~ 14:01:37# kubectl rollout restart deployment web
deployment.apps/web restarted
# 重新执行滚动更新
root@master30 ~ 14:01:37# kubectl rollout restart deployment web
deployment.apps/web restarted
# 两个Pod均调度至worker32节点
root@master30 ~ 14:01:42# kubectl get pods -o wide
NAME                  READY   STATUS    RESTARTS   AGE   IP               NODE                 NOMINATED NODE   READINESS GATES
web-b85646f67-7657d   1/1     Running   0          6s    10.224.218.141   worker32.liu.cloud   <none>           <none>
web-b85646f67-84wsx   1/1     Running   0          5s    10.224.218.149   worker32.liu.cloud   <none>           <none>
清理环境
root@master30 ~ 14:01:48# kubectl delete deployments.apps web
deployment.apps "web" deleted
root@master30 ~ 14:01:59# kubectl label nodes worker31.liu.cloud CPU-
node/worker31.liu.cloud unlabeled
root@master30 ~ 14:02:22# kubectl label nodes worker32.liu.cloud CPU-
node/worker32.liu.cloud unlabeled
root@master30 ~ 14:02:27# kubectl label nodes worker32.liu.cloud MEM-
node/worker32.liu.cloud unlabeled
节点亲和性权重说明
用户可为 preferredDuringSchedulingIgnoredDuringExecution 下每条偏好规则配置 weight,取值区间 1~100。调度器筛选出满足所有硬性调度条件的节点后,累加节点匹配到的全部偏好权重,该总分会叠加至节点其他打分项,最终总分最高的节点拥有最优调度优先级。
示例 Pod 规约:
apiVersion: v1
kind: Pod
metadata:
  name: with-affinity-anti-affinity
spec:
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: kubernetes.io/os
            operator: In
            values:
            - linux
      preferredDuringSchedulingIgnoredDuringExecution:
      - weight: 1
        preference:
          matchExpressions:
          - key: label-1
            operator: In
            values:
            - key-1
      - weight: 50
        preference:
          matchExpressions:
          - key: label-2
            operator: In
            values:
            - key-2
  containers:
  - name: with-node-affinity
    image: hub.laoma.cloud/library/nginx
假设存在两个候选节点,均满足强制亲和约束:一个节点带有 label-1: key-1,另一个带有 label-2: key-2。调度器会分别叠加对应权重至节点总分,携带高权重标签的节点会获得更高调度优先级。
Inter-pod affinity and anti-affinity
Pod 间亲和、反亲和规则,依据节点上已运行 Pod 的标签约束新 Pod 的调度范围,而非依赖节点自身标签。
Pod 间亲和 / 反亲和通用逻辑:若拓扑域 X 内已运行至少一个匹配规则 Y 的 Pod:
- 亲和性场景:新 Pod 优先调度至拓扑域 X 内。
- 反亲和性场景:新 Pod 尽量不调度至拓扑域 X 内。
补充说明:
- X 代表拓扑域,可指代节点、物理机架、云可用区、地理分区等层级;通过
topologyKey指定对应节点标签键,以此划分拓扑范围。 - Y 为标签选择器规则,用于筛选拓扑域内已存在的 Pod。
重要注意事项
- Pod 间亲和、反亲和会大幅增加调度计算开销,节点规模数百台以上的大型集群不建议使用,会明显拖慢调度速度。
- 使用 Pod 反亲和要求集群所有节点统一配置
topologyKey对应标签;若部分节点缺失该标签,会产生不可预期的调度异常。
Pod 间亲和 / 反亲和同样分为两类策略:
requiredDuringSchedulingIgnoredDuringExecution:强制约束,典型场景:将高频通信的多个 Pod 调度至同一可用区。preferredDuringSchedulingIgnoredDuringExecution:偏好约束,典型场景:同一服务的多副本 Pod 分散部署至不同可用区。
配置位置:
- Pod 规约
.affinity.podAffinity:配置 Pod 间亲和规则。 - Pod 规约
.affinity.podAntiAffinity:配置 Pod 间反亲和规则。
适用场景
Pod 间亲和与反亲和适合管控一组业务 Pod 的拓扑分布,搭配 Deployment、StatefulSet、ReplicaSet 等控制器使用效果更佳。
语法说明
下方示例同时配置一条 Pod 亲和、一条 Pod 反亲和规则:
root@master30 ~ 14:10:56# vim pod-with-podaffinity.yaml
apiVersion: v1
kind: Pod
metadata:
  name: pod-with-podaffinity
spec:
  affinity:
    podAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
      - labelSelector:
          matchExpressions:
          - key: security
            operator: In
            values:
            - S1
        topologyKey: topology.kubernetes.io/zone
    podAntiAffinity:
      preferredDuringSchedulingIgnoredDuringExecution:
      - weight: 100
        podAffinityTerm:
          labelSelector:
            matchExpressions:
            - key: security
              operator: In
              values:
              - S2
          topologyKey: topology.kubernetes.io/zone
  containers:
  - name: pod-with-podaffinity
    image: hub.laoma.cloud/library/nginx
- 亲和规则解读:仅当某可用区(
topology.kubernetes.io/zone)内已存在带security=S1标签的 Pod,新 Pod 才可调度至该可用区内任意节点。例如标记为 Zone V 的可用区,区内至少有一个security=S1Pod 时,目标 Pod 才能分配至 Zone V;若无匹配 Pod,则该可用区内所有节点均不可选。 - 反亲和规则解读:若某可用区内已存在带
security=S2标签的 Pod,调度器会尽量规避将新 Pod 分配至该可用区。例如 Zone R 存在security=S2Pod,则调度器优先不选择 Zone R;若无匹配 Pod,则该规则不生效。
补充说明
- Pod 亲和、反亲和支持操作符:
In、NotIn、Exists、DoesNotExist。 topologyKey可为任意合法标签键,但存在使用限制,兼顾调度性能与集群安全:- Pod 亲和无论强制、偏好策略,
topologyKey不能为空。 - Pod 反亲和无论强制、偏好策略,
topologyKey不能为空。 - 除上述两类场景外,
topologyKey无额外限制。
- Pod 亲和无论强制、偏好策略,
示例 1:基于节点可用区拓扑的亲和调度
# 为节点添加可用区拓扑标签
root@master30 ~ 14:25:10# kubectl label node worker31.liu.cloud \
topology.kubernetes.io/zone=v
node/worker31.liu.cloud labeled
root@master30 ~ 14:25:42# kubectl label node worker32.liu.cloud \
topology.kubernetes.io/zone=v
node/worker32.liu.cloud labeled
# 创建两组Deployment
root@master30 ~ 14:26:01# vim deploy-with-podaffinity.yaml
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web1
spec:
  selector:
    matchLabels:
      app: web1
  replicas: 1
  template:
    metadata:
      labels:
        app: web1
    spec:
      nodeName: worker31.liu.cloud
      containers:
      - name: web-server
        image: hub.laoma.cloud/library/nginx
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web2
spec:
  selector:
    matchLabels:
      app: web2
  replicas: 1
  template:
    metadata:
      labels:
        app: web2
    spec:
      affinity:
        podAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - web1
            topologyKey: topology.kubernetes.io/zone
      containers:
      - name: web-server
        image: hub.laoma.cloud/library/nginx
root@master30 ~ 14:26:49# kubectl apply -f deploy-with-podaffinity.yaml
deployment.apps/web1 created
deployment.apps/web2 created
root@master30 ~ 14:27:06# kubectl get pod -o wide
NAME                    READY   STATUS    RESTARTS   AGE   IP               NODE                 NOMINATED NODE   READINESS GATES
web1-6fc98fb99c-48cvp   1/1     Running   0          12s   10.224.133.110   worker31.liu.cloud   <none>           <none>
web2-767459494f-jvfl7   1/1     Running   0          12s   10.224.218.172   worker32.liu.cloud   <none>           <none>
实验现象:配置 Pod 亲和的 web2 Pod 调度至 worker32 节点,二者同属 zone=v 可用区,满足拓扑约束。
若移除 worker32 的 topology.kubernetes.io/zone 标签,重启 web2 Deployment,观察 Pod 调度目标节点:
root@master30 ~ 14:27:18# kubectl label nodes worker32.liu.cloud \
topology.kubernetes.io/zone-
node/worker32.liu.cloud unlabeled
root@master30 ~ 14:27:40# kubectl rollout restart deployment web2
deployment.apps/web2 restarted
# Pod 调度至worker31节点
root@master30 ~ 14:27:52# kubectl get pod -o wide
NAME                    READY   STATUS    RESTARTS   AGE   IP               NODE                 NOMINATED NODE   READINESS GATES
web1-6fc98fb99c-48cvp   1/1     Running   0          60s   10.224.133.110   worker31.liu.cloud   <none>           <none>
web2-695854bd6c-sndtb   1/1     Running   0          14s   10.224.133.116   worker31.liu.cloud   <none>           <none>
# 清理环境资源
root@master30 ~ 14:28:06# kubectl delete -f  deploy-with-podaffinity.yaml
deployment.apps "web1" deleted
deployment.apps "web2" deleted
root@master30 ~ 14:28:20# kubectl label node worker31.liu.cloud \ topology.kubernetes.io/zone-
node/worker31.liu.cloud unlabeled
结论:Pod 亲和调度生效需同时满足两项条件
- 节点必须配置
topologyKey对应的拓扑标签,用于划分同一拓扑域(机架、可用区、机房等)。 - 该拓扑域内至少运行一个匹配标签选择器的 Pod。
示例 2:基于主机名拓扑的反亲和调度
下方 Redis Deployment 示例配置 3 个副本,Pod 标签为 app=store;通过 PodAntiAffinity 强制约束,保证单个节点仅运行一个副本。
# 编写Deployment配置文件
root@master30 ~ 14:28:53# vim deploy-with-podAntiAffinity.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: store
spec:
  selector:
    matchLabels:
      app: store
  replicas: 3
  template:
    metadata:
      labels:
        app: store
    spec:
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - store
            topologyKey: "kubernetes.io/hostname"
      containers:
      - name: web-server
        image: hub.laoma.cloud/library/nginx
# 查看Pod调度分布
root@master30 ~ 14:43:50# kubectl apply -f deploy-with-podAntiAffinity.yaml
deployment.apps/store created
root@master30 ~ 14:44:37# kubectl get pods -o wide
NAME                    READY   STATUS    RESTARTS   AGE   IP               NODE                 NOMINATED NODE   READINESS GATES
store-bff9b9ffd-ghqb6   0/1     Pending   0          8s    <none>           <none>               <none>           <none>
store-bff9b9ffd-hp9rz   1/1     Running   0          8s    10.224.218.138   worker32.liu.cloud   <none>           <none>
store-bff9b9ffd-llww4   1/1     Running   0          8s    10.224.133.70    worker31.liu.cloud   <none>           <none>
运行结果:topologyKey: "kubernetes.io/hostname" 以节点主机名作为拓扑标识,每台节点仅能部署一个 store Pod;集群仅有两台工作节点,第三个副本无可用节点,持续处于 Pending 未调度状态。
示例 3:组合亲和与反亲和调度
下述 webstore Deployment 同时配置 Pod 反亲和、Pod 亲和规则:保证自身副本不共存于同一节点,且所有副本必须与带有 app=store 标签的 Pod 部署在同一节点。
# 将store缩容至单副本
root@master30 ~ 14:47:20# kubectl scale deployment store --replicas 1
deployment.apps/store scaled
root@master30 ~ 14:47:27# kubectl get pod -o wide --no-headers |awk '{print $1,$3,$7}'
store-bff9b9ffd-sk4l7 Running worker32.liu.cloud
# 新建web-store Deployment配置文件
root@master30 ~ 14:48:11# vim deploy-with-multi-Affinity.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web-store
spec:
  selector:
    matchLabels:
      app: web-store
  replicas: 1
  template:
    metadata:
      labels:
        app: web-store
    spec:
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - web-store
            topologyKey: "kubernetes.io/hostname"
        podAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - store
            topologyKey: "kubernetes.io/hostname"
      containers:
      - name: web-app
        image: hub.laoma.cloud/library/nginx
root@master30 ~ 14:48:54# kubectl apply -f deploy-with-multi-Affinity.yaml
deployment.apps/web-store created
root@master30 ~ 14:49:09# kubectl get pods -o wide
NAME                         READY   STATUS    RESTARTS   AGE   IP               NODE                 NOMINATED NODE   READINESS GATES
store-bff9b9ffd-sk4l7        1/1     Running   0          2m    10.224.218.165   worker32.liu.cloud   <none>           <none>
web-store-58757df49b-kjzx2   1/1     Running   0          11s   10.224.218.143   worker32.liu.cloud   <none>           <none>
# 扩容web-store至两个副本,验证调度效果
root@master30 ~ 14:49:42# kubectl scale deployment web-store --replicas 2
deployment.apps/web-store scaled
root@master30 ~ 15:02:20# kubectl get pod -o wide --no-headers |awk '{print $1,$3,$7}'
store-bff9b9ffd-sk4l7 Running worker32.liu.cloud
web-store-58757df49b-7bfxt Pending <none>
web-store-58757df49b-kjzx2 Running worker32.liu.cloud
# 调度逻辑说明
# 亲和约束:仅worker32节点存在匹配app=store的Pod,其他节点无调度资格
# 反亲和约束:worker32已运行一个web-store副本,不允许新增同节点副本
# 最终现象:第二个副本无可用节点,持续Pending
Taint 和 Toleration
学习参考:污点和容忍度
- 节点配置 Taint(污点),用于限制 Pod 部署范围:仅配置对应容忍度的 Pod 可调度至该节点,不匹配的 Pod 会被拦截。
- Pod 配置 Toleration(容忍度),允许自身调度至带有匹配污点的节点。
污点与容忍度配套使用,实现节点筛选 Pod 的管控逻辑。单个节点可添加多条污点规则,凡是无法兼容全部污点的 Pod,均无法分配至该节点。
思考:nodeAffinity 与 Taint 核心区别?
- nodeAffinity:Pod 主动筛选节点,是 Pod 选择节点的硬性条件。
- Taint:节点主动筛选 Pod,是节点接纳 Pod 的硬性条件。
类比相亲场景便于理解:
- nodeAffinity 相当于求职者筛选企业,污点相当于企业筛选求职者,二者双向约束。
设置 Node Taints
通过 kubectl taint 命令为节点添加污点规则。
示例:为节点 worker31.liu.cloud 添加污点 CPU=L1:NoSchedule。
root@master30 ~ 15:06:16# kubectl taint nodes worker31.liu.cloud \
> CPU=L1:NoSchedule
node/worker31.liu.cloud tainted
该规则含义:仅带有匹配 CPU=L1:NoSchedule 容忍度的 Pod,才可调度至 worker31.liu.cloud 节点。
移除节点污点命令:
root@master30 ~ 15:49:26# kubectl taint nodes worker31.liu.cloud CPU:NoSchedule-
node/worker31.liu.cloud untainted
设置 Pod tolerations
容忍度配置定义在 Pod.Spec 字段内。
示例配置:
tolerations:
- key: "CPU"
  operator: "Equal"
  value: "L1"
  effect: "NoSchedule"
operator 可选参数说明:
-
Equal:默认操作符,容忍度与污点键、值完全一致才算匹配。 -
Exists:无需填写 value,只要节点污点存在对应 key,即可匹配。tolerations: - key: "CPU" operator: "Exists" effect: "NoSchedule"
effect 污点生效策略可选值:
NoSchedule:未配置匹配容忍度的新 Pod 禁止调度至该节点;已在节点运行的 Pod 不受影响,不会被驱逐。PreferNoSchedule:软性约束,调度器会尽量规避无匹配容忍度的 Pod,但无法完全杜绝。NoExecute:同时影响新建、已运行 Pod:- 无匹配容忍度的 Pod:直接拒绝调度,已运行的 Pod 立即驱逐。
- 有匹配容忍度、未配置
tolerationSeconds:Pod 可永久保留在节点运行。 - 有匹配容忍度、配置
tolerationSeconds:Pod 可在节点继续运行指定时长,超时后被驱逐。
- effect 留空:可匹配同一 key 下所有 effect 类型的污点。
特殊规则:若容忍度 key 为空、operator 为 Exists,代表该容忍度兼容集群所有污点,无任何调度限制。
单个容忍度匹配单个污点实操
前置操作:为节点添加污点
root@master30 ~ 15:50:04# kubectl taint nodes worker31.liu.cloud CPU=L1:NoSchedule
node/worker31.liu.cloud tainted
root@master30 ~ 15:50:39# kubectl taint nodes worker32.liu.cloud CPU=L2:NoSchedule
node/worker32.liu.cloud tainted
创建 Deployment,容忍度匹配 CPU=L3,与节点污点不兼容:
root@master30 ~ 15:50:49# vim deploy-with-tolerations.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: web
  name: web
spec:
  replicas: 2
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      tolerations:
      - key: "CPU"
        operator: "Equal"
        value: "L3"
        effect: "NoSchedule"
      containers:
      - name: nginx
        image: hub.laoma.cloud/library/nginx
        imagePullPolicy: IfNotPresent
# 部署资源
root@master30 ~ 15:51:11# kubectl apply -f deploy-with-tolerations.yaml
deployment.apps/web created
root@master30 ~ 15:51:24# kubectl get pods
NAME                   READY   STATUS    RESTARTS   AGE
web-7d9d5f896c-qj4tb   0/1     Pending   0          7s
web-7d9d5f896c-zwtv8   0/1     Pending   0          7s
# Pod持续未调度,查看事件可看到所有节点污点均无法被Pod容忍
root@master30 ~ 15:51:31# kubectl describe pod web-7d9d5f896c-qj4tb
......
Events:
  Type     Reason            Age   From               Message
  ----     ------            ----  ----               -------
  Warning  FailedScheduling  24s   default-scheduler  0/3 nodes are available: 1 node(s) had untolerated taint {CPU: L1}, 1 node(s) had untolerated taint {CPU: L2}, 1 node(s) had untolerated taint {node-role.kubernetes.io/control-plane: }. preemption: 0/3 nodes are available: 3 Preemption is not helpful for scheduling.
# 删除Deployment,修改容忍度匹配CPU=L1
root@master30 ~ 15:51:48# kubectl delete deployments.apps web
deployment.apps "web" deleted
root@master30 ~ 15:51:58# vim deploy-with-tolerations.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: web
  name: web
spec:
  replicas: 2
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      tolerations:
      - key: "CPU"
        operator: "Equal"
        value: "L1"
        effect: "NoSchedule"
      containers:
      - name: nginx
        image: hub.laoma.cloud/library/nginx
        imagePullPolicy: IfNotPresent
root@master30 ~ 15:52:34# kubectl apply -f deploy-with-tolerations.yaml
deployment.apps/web created
root@master30 ~ 15:52:44# kubectl get pods -o wide
NAME                  READY   STATUS    RESTARTS   AGE   IP              NODE                 NOMINATED NODE   READINESS GATES
web-78945b5cc-qfqr6   1/1     Running   0          9s    10.224.133.98   worker31.liu.cloud   <none>           <none>
web-78945b5cc-sdrpx   1/1     Running   0          9s    10.224.133.73   worker31.liu.cloud   <none>           <none>
# Pod调度成功,全部分配至带有CPU=L1污点的worker31节点
# 清理实验环境
root@master30 ~ 15:52:53# kubectl taint nodes worker31.liu.cloud CPU=L1:NoSchedule-
node/worker31.liu.cloud untainted
root@master30 ~ 15:53:12# kubectl taint nodes worker32.liu.cloud CPU=L1:NoSchedule-
node/worker32.liu.cloud untainted
root@master30 ~ 15:53:22# kubectl delete deployments.apps web
deployment.apps "web" deleted
多污点与多容忍度匹配逻辑
单个节点可配置多条污点,单个 Pod 也可配置多条容忍度。集群匹配规则类似过滤器:遍历节点全部污点,过滤掉 Pod 存在对应容忍度的污点;剩余未被兼容的污点,根据其 effect 类型决定 Pod 能否调度至该节点:
- 剩余污点包含任意
NoSchedule:禁止 Pod 调度至该节点。 - 无
NoSchedule污点,但存在PreferNoSchedule:调度器尽量规避该节点,不强制拦截。 - 剩余污点包含任意
NoExecute:未运行 Pod 禁止调度,已运行 Pod 直接驱逐。
举例说明:节点添加三条污点
root@master30 ~ 15:53:30# kubectl taint nodes worker31.liu.cloud CPU=L1:NoSchedule
node/worker31.liu.cloud tainted
root@master30 ~ 15:54:04# kubectl taint nodes worker31.liu.cloud CPU=L1:NoExecute
node/worker31.liu.cloud tainted
root@master30 ~ 15:54:32# kubectl taint nodes worker31.liu.cloud MEM=L2:NoSchedule
node/worker31.liu.cloud tainted
Pod 仅配置两条 CPU 相关容忍度:
tolerations:
- key: "CPU"
  operator: "Equal"
  value: "L1"
  effect: "NoSchedule"
- key: "CPU"
  operator: "Equal"
  value: "L1"
  effect: "NoExecute"
匹配结果:节点第三条污点 MEM=L2:NoSchedule 无对应容忍度,存在未兼容的 NoSchedule 污点,Pod 无法调度至该节点。若 Pod 已提前运行在该节点,新增污点不会驱逐 Pod,仅拦截后续新建 Pod。
完整实操示例:
为节点配置多条污点
root@master30 ~ 15:53:30# kubectl taint nodes worker31.liu.cloud CPU=L1:NoSchedule
node/worker31.liu.cloud tainted
root@master30 ~ 15:54:04# kubectl taint nodes worker31.liu.cloud CPU=L1:NoExecute
node/worker31.liu.cloud tainted
root@master30 ~ 15:54:32# kubectl taint nodes worker31.liu.cloud MEM=L2:NoSchedule
node/worker31.liu.cloud tainted
root@master30 ~ 15:54:44# kubectl taint nodes worker32.liu.cloud MEM=L1:NoSchedule
node/worker32.liu.cloud tainted
Deployment 初始仅配置 CPU 相关容忍度:
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: web
  name: web
spec:
  replicas: 2
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      tolerations:
      - key: "CPU"
        operator: "Equal"
        value: "L1"
        effect: "NoSchedule"
      - key: "CPU"
        operator: "Equal"
        value: "L1"
        effect: "NoExecute"
      containers:
      - name: nginx
        image: hub.laoma.cloud/library/nginx
        imagePullPolicy: IfNotPresent
# 部署资源
root@master30 ~ 15:55:40# kubectl apply -f deploy-with-tolerations.yaml
deployment.apps/web created
root@master30 ~ 15:55:52# kubectl get pods
NAME                   READY   STATUS    RESTARTS   AGE
web-745f6fc44d-shfsx   0/1     Pending   0          5s
web-745f6fc44d-zcjnb   0/1     Pending   0          5s
# 查看事件,所有节点均存在无法兼容的污点
root@master30 ~ 15:55:57# kubectl describe pod web-745f6fc44d-shfsx
......
Events:
  Type     Reason            Age   From               Message
  ----     ------            ----  ----               -------
  Warning  FailedScheduling  27s   default-scheduler  0/3 nodes are available: 1 node(s) had untolerated taint {MEM: L1}, 1 node(s) had untolerated taint {MEM: L2}, 1 node(s) had untolerated taint {node-role.kubernetes.io/control-plane: }. preemption: 0/3 nodes are available: 3 Preemption is not helpful for scheduling.
# 删除Deployment,新增MEM=L2容忍度
root@master30 ~ 15:56:19# kubectl delete deployments.apps web
deployment.apps "web" deleted
root@master30 ~ 15:56:32# vim deploy-with-tolerations.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: web
  name: web
spec:
  replicas: 2
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      tolerations:
      - key: "CPU"
        operator: "Equal"
        value: "L1"
        effect: "NoSchedule"
      - key: "CPU"
        operator: "Equal"
        value: "L1"
        effect: "NoExecute"
      - key: "MEM"
        operator: "Equal"
        value: "L2"
        effect: "NoSchedule"
      containers:
      - name: nginx
        image: hub.laoma.cloud/library/nginx
        imagePullPolicy: IfNotPresent
root@master30 ~ 15:56:57# kubectl apply -f deploy-with-tolerations.yaml
deployment.apps/web created
root@master30 ~ 15:57:14# kubectl get pod -o wide
NAME                  READY   STATUS    RESTARTS   AGE   IP              NODE                 NOMINATED NODE   READINESS GATES
web-65bfcb4fc-rqb4c   1/1     Running   0          9s    10.224.133.91   worker31.liu.cloud   <none>           <none>
web-65bfcb4fc-wct97   1/1     Running   0          9s    10.224.133.68   worker31.liu.cloud   <none>           <none>
# Pod调度至worker31节点,所有污点均被容忍度匹配
# 清理实验污点与资源
root@master30 ~ 15:57:23# kubectl taint nodes worker31.liu.cloud CPU=L1:NoSchedule-
node/worker31.liu.cloud untainted
root@master30 ~ 15:57:52# kubectl taint nodes worker31.liu.cloud CPU=L1:NoExecute-
node/worker31.liu.cloud untainted
root@master30 ~ 15:58:03# kubectl taint nodes worker31.liu.cloud MEM=L2:NoSchedule-
node/worker31.liu.cloud untainted
root@master30 ~ 15:58:23# kubectl taint nodes worker32.liu.cloud CPU=L2:NoSchedule-
node/worker32.liu.cloud untainted
root@master30 ~ 15:59:17# kubectl delete deployments.apps web
deployment.apps "web" deleted
Taint 和 Toleration 典型业务场景
借助污点与容忍度,可灵活实现 Pod 规避指定节点、节点故障驱逐 Pod 等管控需求,典型使用场景如下:
- 专属业务节点:为专用节点添加污点
dedicated=groupName:NoSchedule,对应业务 Pod 配置匹配容忍度,保证业务可调度至专属节点;若要求业务仅能运行在专属节点,需同步为节点添加dedicated=groupName标签,并为 Pod 配置节点亲和强制约束。 - 特殊硬件节点隔离:集群内部分节点搭载 GPU、高速 SSD 等专用硬件,添加污点
special=true:NoSchedule;仅运行依赖硬件的业务 Pod 配置对应容忍度,普通业务无法占用硬件节点资源。
基于污点的 Pod 驱逐机制
前文提及 NoExecute 类型污点会影响已运行 Pod,细分三种处理逻辑:
- Pod 无匹配容忍度:节点添加污点后,Pod 立即被驱逐。
- Pod 有匹配容忍度、未设置
tolerationSeconds:Pod 永久保留在节点,不会被驱逐。 - Pod 有匹配容忍度、设置
tolerationSeconds:Pod 可在节点运行指定时长,超时后自动驱逐。
节点控制器会在节点出现异常时,自动为节点添加内置污点,内置污点清单:
node.kubernetes.io/not-ready:节点就绪状态为 False,节点未正常就绪。node.kubernetes.io/unreachable:控制平面无法与节点通信,节点状态标记为 Unknown。node.kubernetes.io/memory-pressure:节点内存资源不足,存在内存压力。node.kubernetes.io/disk-pressure:节点磁盘存储资源耗尽,磁盘压力告警。node.kubernetes.io/pid-pressure:节点进程 PID 资源耗尽,PID 压力告警。node.kubernetes.io/network-unavailable:节点网络组件异常,网络不可用。node.kubernetes.io/unschedulable:节点标记为不可调度。node.cloudprovider.kubernetes.io/uninitialized:节点云厂商控制器未完成初始化,kubelet 启动云驱动时自动添加,初始化完成后自动移除。
节点出现故障时,节点控制器、kubelet 会自动添加带 NoExecute 效果的污点;节点恢复正常后,对应污点会自动清除。
补充说明:为避免节点失联、资源耗尽等场景下大批量 Pod 同时驱逐引发集群雪崩,内置污点会做驱逐速率限流控制,分批驱逐 Pod。
结合 tolerationSeconds,Pod 可自定义节点故障后的滞留时长。例如本地缓存业务,节点网络中断后希望短时保留 Pod 等待网络恢复,容忍度配置如下:
tolerations:
- key: "node.kubernetes.io/unreachable"
  operator: "Exists"
  effect: "NoExecute"
  tolerationSeconds: 6000
内置自动容忍度规则:
集群默认给所有 Pod 自动添加
node.kubernetes.io/not-ready容忍度,tolerationSeconds=300;若用户手动配置该 key 容忍度,则不自动追加。集群默认给所有 Pod 自动添加
node.kubernetes.io/unreachable容忍度,tolerationSeconds=300;若用户手动配置该 key 容忍度,则不自动追加。自动容忍度意味着节点故障后,Pod 默认可滞留 5 分钟再执行驱逐。
DaemonSet 管理的 Pod 存在特殊规则:针对 node.kubernetes.io/unreachable、node.kubernetes.io/not-ready 两类污点,自动添加的 NoExecute 容忍度不会配置 tolerationSeconds,保证节点故障时 DaemonSet 组件(网络代理、日志采集等)不会被驱逐。
Kubernetes Metric Server
学习参考:Metric Server
环境准备
root@master30 ~ 16:14:13# kubectl create ns metric
namespace/metric created
root@master30 ~ 17:04:16# kubectl config set-context --current --namespace metric
Context "kubernetes-admin@kubernetes" modified.
Metrics-Server 概述
在使用 Kubernetes 集群的过程中,我们常会遇到以下问题:
- 如何监控节点的计算资源占用情况?
- 如何监控 Pod 的计算资源占用情况?
- 如何依据 Pod 的资源负载实现应用自动扩缩容?
Metrics-Server 可以解决上述需求,其核心能力如下:
- 采集并展示集群节点与 Pod 的计算资源使用指标。
- 作为 Kubernetes 内置自动伸缩链路轻量化、高性能的容器资源指标数据源。
- Metrics Server 通过 Kubelet 采集各类资源指标,并将指标经由 Metrics API 暴露至 Kubernetes API Server,供 HPA(Horizontal Pod Autoscaler)、VPA(Vertical Pod Autoscaler)调用。
- Metrics API 支持通过
kubectl top命令直接查询,方便运维人员排查自动伸缩链路相关问题。
Metrics Server 仅服务于集群自动伸缩场景,不适合作为通用监控数据源。若需将指标推送至第三方监控平台,建议直接从 Kubelet 的 /metrics/resource 接口采集指标。
指标服务器具备以下优势:
- 单套部署即可适配绝大多数集群(部署要求详见官方文档)。
- 指标采集频率为每 15 秒一次,保障自动伸缩响应速度。
- 资源占用极低:集群内每个节点仅消耗 1 毫核 CPU、2MB 内存。
- 具备高扩展性,最大可支撑 5000 节点规模的集群。
Metrics-Server 部署
# 下载 Metrics-Server
root@master30 ~ 17:04:47# wget -O components.yaml http://192.168.46.200/class/course-materials/softwares/stage03/metrics-server-components-v0.7.1.yaml
--2026-08-12 17:04:58--  http://192.168.46.200/class/course-materials/softwares/stage03/metrics-server-components-v0.7.1.yaml
Connecting to 192.168.46.200:80... connected.
HTTP request sent, awaiting response... 200 OK
Length: 4340 (4.2K) [text/plain]
Saving to: ‘components.yaml’
components.yaml              100%[============================================>]   4.24K  --.-KB/s    in 0s
2026-08-12 17:04:58 (656 MB/s) - ‘components.yaml’ saved [4340/4340]
# 修改 Metrics-Server,不校验tls
# 上面的yaml文件已经修改完成了
# root@master30:~# sed -i '/metric-resolution/a\        - --kubelet-insecure-tls' components.yaml
# 修改镜像
root@master30 ~ 17:06:16# grep image: components.yaml
        image: hub.laoma.cloud/metrics-server/metrics-server:v0.7.1
root@master30 ~ 17:06:36# sed -i 's/registry.k8s.io/hub.laoma.cloud/g' components.yaml
# 部署 Metrics-Server
root@master30 ~ 17:06:54# kubectl apply -f components.yaml
serviceaccount/metrics-server created
clusterrole.rbac.authorization.k8s.io/system:aggregated-metrics-reader created
clusterrole.rbac.authorization.k8s.io/system:metrics-server created
rolebinding.rbac.authorization.k8s.io/metrics-server-auth-reader created
clusterrolebinding.rbac.authorization.k8s.io/metrics-server:system:auth-delegator created
clusterrolebinding.rbac.authorization.k8s.io/system:metrics-server created
service/metrics-server created
deployment.apps/metrics-server created
apiservice.apiregistration.k8s.io/v1beta1.metrics.k8s.io created
# 查看 Metrics-Server 运行状态
root@master30 ~ 17:07:30# kubectl get pods -n kube-system |grep metrics
metrics-server-5b98f887f4-xq98s              1/1     Running   0               33s
Metrics-Server 使用
查看节点资源状态
root@master30 ~ 17:07:37# kubectl top node
NAME                 CPU(cores)   CPU%   MEMORY(bytes)   MEMORY%
master30.liu.cloud   191m         9%     1827Mi          48%
worker31.liu.cloud   60m          3%     1065Mi          28%
worker32.liu.cloud   66m          3%     1283Mi          34%
查看 Pod 资源状态
root@master30 ~ 17:07:48# kubectl top pod -n kube-system
NAME                                         CPU(cores)   MEMORY(bytes)
calico-kube-controllers-5b778fd8ff-cn6g2     6m           79Mi
calico-node-pdfgq                            27m          175Mi
calico-node-tlcpd                            25m          179Mi
calico-node-w8xd6                            23m          178Mi
coredns-5485cd7479-df85k                     2m           33Mi
coredns-5485cd7479-vcm2h                     2m           38Mi
etcd-master30.liu.cloud                      24m          114Mi
kube-apiserver-master30.liu.cloud            59m          374Mi
kube-controller-manager-master30.liu.cloud   10m          57Mi
kube-proxy-6zffc                             1m           72Mi
kube-proxy-gnssn                             1m           71Mi
kube-proxy-wqp7w                             4m           71Mi
kube-scheduler-master30.liu.cloud            4m           18Mi
metrics-server-5b98f887f4-xq98s              4m           16Mi
单位换算标准:1CPU = 1000 毫核 (m)
扩容和减容控制
扩容和缩容时间参数
指标采样周期
- 启动参数:
--horizontal-pod-autoscaler-sync-period duration - 默认值:15 秒,代表 HPA 每 15 秒从 metrics-server 拉取一次资源指标。
启动就绪窗口期
- 启动参数:
--horizontal-pod-autoscaler-initial-readiness-delay duration - 默认值:30 秒,Pod 启动后的前 30 秒会被判定为启动阶段,不参与 HPA 负载计算。
缩容稳定窗口期
- 启动参数:
--horizontal-pod-autoscaler-downscale-stabilization duration - 默认值:5 分钟,即缩容冷却等待时长。
持续高负载 → 自动扩容
- 指标采集周期固定为 15 秒一次;
- Pod 启动后的前 30 秒属于就绪窗口期,不计入负载判定;
- 完成一次扩容操作后,需等待冷却周期结束才能执行下一次扩容。
👉 结论:在 K8s 1.30 版本中,两次扩容操作的最小间隔为 30 秒。
持续低负载 → 自动缩容
- 指标采集周期同样为 15 秒;
- 需指标长期低于设定阈值才会触发缩容逻辑;
- 负载指标需持续 5 分钟处于低位区间,才会执行缩容;
- 完成一次缩容后,会锁定 5 分钟冷却时间,期间不再触发缩容。
设置扩容和减容时间参数
Pod 扩缩容逻辑由 kube-controller-manager 组件管控,若需调整扩缩容速度,直接修改 controller-manager 的启动参数即可。
扩缩容配置冷却时间的核心目的:避免流量瞬时抖动、突发峰值引发应用频繁扩缩容,保障集群稳定性。
本次演示将扩容冷却周期调整为 30 秒、缩容冷却周期调整为 60 秒,操作如下:
root@master30 ~ 17:08:18# vim /etc/kubernetes/manifests/kube-controller-manager.yaml
spec:
  containers:
  - command:
    - kube-controller-manager
    - --allocate-node-cidrs=true
......
    # 增加下面三行参数
    - --horizontal-pod-autoscaler-sync-period=10s
    - --horizontal-pod-autoscaler-initial-readiness-delay=20s
    - --horizontal-pod-autoscaler-downscale-stabilization=60s
保存文件退出后,静态 Pod 会自动重启,参数配置立即生效。
Horizontal Pod Autoscaler
学习参考:hpa
HPA 作用
该控制器会从三类 API 接口拉取指标数据:metrics.k8s.io、custom.metrics.k8s.io、external.metrics.k8s.io,其中 metrics.k8s.io 接口由 Metrics Server 提供。HPA 将根据配置的指标阈值,动态调整 Deployment、ReplicaSet、RC 资源的 Pod 副本数量。
适用场景
- 流量波动幅度较大的无状态服务(Nginx、后端 API、网关、微服务等)
- 需要提升并发承载能力、削峰填谷的业务
- Deployment、StatefulSet 类型工作负载均支持
核心特点
- 仅调整 Pod 副本数量,不会修改 Pod 内部配置;
- 指标实时采集,扩缩容响应速度为秒级;
- 集群内使用最广泛、稳定性最优的自动伸缩方案。
支持指标类型
- CPU 资源使用率
- 内存资源使用率
- 对接 Prometheus 后可使用自定义业务指标
- 业务 QPS、接口延迟等业务维度指标
基于 CPU 使用率伸缩
准备测试资源
root@master30 ~ 17:10:25# kubectl create deployment web --image=hub.laoma.cloud/library/nginx
deployment.apps/web created
root@master30 ~ 17:10:27# kubectl get pods
NAME                   READY   STATUS    RESTARTS   AGE
web-759dfd9847-ltk6g   1/1     Running   0          8s
创建 HPA 规则
Usage:  kubectl autoscale (-f FILENAME | TYPE NAME | TYPE/NAME) [--min=MINPODS]--max=MAXPODS [--cpu-percent=CPU] [options]
root@master30 ~ 17:10:35# kubectl autoscale deployment web --max=5 --min=2 --cpu-percent=80
horizontalpodautoscaler.autoscaling/web autoscaled
root@master30 ~ 17:11:13# kubectl get hpa web -o yaml
# 省略部分不重要配置
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: web
spec:
  maxReplicas: 5
  metrics:
  - resource:
      name: cpu
      target:
        averageUtilization: 80
        type: Utilization
    type: Resource
  minReplicas: 2
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: web
# 稍等片刻,控制器自动创建新Pod至最小副本数
root@master30 ~ 17:11:26# kubectl get pods
NAME                   READY   STATUS    RESTARTS   AGE
web-759dfd9847-ltk6g   1/1     Running   0          71s
web-759dfd9847-q2vx2   1/1     Running   0          15s
root@master30 ~ 17:11:56# kubectl get hpa
NAME   REFERENCE        TARGETS              MINPODS   MAXPODS   REPLICAS   AGE
web    Deployment/web   cpu: <unknown>/80%   2         5         2          51s
# CPU目标值显示<unknown>
想要 HPA 正常展示指标阈值对比数值,必须同时满足两个前置条件:
- 集群已部署 metric server;
- 为 Pod 配置资源限制参数。
root@master30 ~ 17:12:04# kubectl edit deployments.apps web
deployment.apps/web edited
# 修改spec.template.spec.containers.[N].resources属性,添加limit属性,如下:
        resources:
          limits:
            cpu: 100m
            memory: 200Mi
# 再次查看hpa状态
root@master30 ~ 17:15:07# kubectl get hpa
NAME   REFERENCE        TARGETS              MINPODS   MAXPODS   REPLICAS   AGE
web    Deployment/web   cpu: <unknown>/80%   2         5         2          3m56s
root@master30 ~ 17:15:44# kubectl expose deployment web --port=80 --target-port=80
service/web exposed
root@master30 ~ 17:16:25# kubectl get svc
NAME   TYPE        CLUSTER-IP      EXTERNAL-IP   PORT(S)   AGE
web    ClusterIP   10.99.119.183   <none>        80/TCP    7s
压力测试操作
# 开启监控窗口实时观察状态
root@master30 ~ 17:56:42# \
while true
do
  clear;
  kubectl get hpa;echo
  kubectl get pod;echo
  kubectl top pods
  sleep 1
done
# 安装压测工具,模拟CPU高负载
root@master30 ~ 17:56:42# apt install -y apache2-utils
root@master30 ~ 17:56:42# while true ;do ab -n 300000 -c 100 http://10.99.119.183/;sleep 1;done
# 参数说明
#  -n 300000:总请求发送量
#  -c 100:并发连接数
CPU 负载上升后状态
NAME   REFERENCE        TARGETS        MINPODS   MAXPODS   REPLICAS   AGE
web    Deployment/web   cpu: 85%/80%   2         5         2          38m
NAME                   READY   STATUS    RESTARTS   AGE
web-7cf9fd6bcb-fctd6   1/1     Running   0          34m
web-7cf9fd6bcb-fkwjp   1/1     Running   0          35m
NAME                   CPU(cores)   MEMORY(bytes)
web-7cf9fd6bcb-fctd6   81m          3Mi
web-7cf9fd6bcb-fkwjp   89m          3Mi
NAME   REFERENCE        TARGETS        MINPODS   MAXPODS   REPLICAS   AGE
web    Deployment/web   cpu: 88%/80%   2         5         5          42m
NAME                   READY   STATUS    RESTARTS   AGE
web-7cf9fd6bcb-ch7lx   1/1     Running   0          4m
web-7cf9fd6bcb-dgjth   1/1     Running   0          49s
web-7cf9fd6bcb-fctd6   1/1     Running   0          39m
web-7cf9fd6bcb-fkwjp   1/1     Running   0          39m
web-7cf9fd6bcb-pf2jj   1/1     Running   0          3m30s
NAME                   CPU(cores)   MEMORY(bytes)
web-7cf9fd6bcb-ch7lx   43m          3Mi
web-7cf9fd6bcb-dgjth   33m          3Mi
web-7cf9fd6bcb-fctd6   73m          3Mi
web-7cf9fd6bcb-fkwjp   43m          3Mi
web-7cf9fd6bcb-pf2jj   31m          3Mi
web-6dcdc45c94-tsjkr   101m         3Mi
现象观察总结
- 随着 Pod CPU 使用率持续超过阈值,控制器自动新增 Pod 副本;
- 正常情况下,单次扩容间隔约 30 秒;
- 即便 CPU 负载持续超标,副本总数不会超过配置的最大副本数 5;
- 停止压力测试、负载回落至阈值以下后,副本数量会逐步缩减至最小副本数 2。
清理测试资源
# 删除内存伸缩HPA规则
root@master30 ~ 18:32:26# kubectl delete hpa web
horizontalpodautoscaler.autoscaling "web" deleted
# 删除应用Deployment
root@master30 ~ 18:32:41# kubectl delete deployment web
deployment.apps "web" deleted
# 删除测试Service
root@master30 ~ 18:32:55# kubectl delete svc web
service "web" deleted
更多推荐



 9
 0
- 0


 已为社区贡献15条内容

所有评论(0)