
K8s部署华为NPU并分配训练
华为昇腾 NPU 介绍
华为昇腾(Ascend)系列是华为发布的 AI 专用计算平台,由昇腾 NPU 芯片、CANN 软件栈、昇腾硬件生态和工具链共同组成。其目标是为大模型训练、推理、图像处理、高性能计算提供高效的 AI 加速能力。
一、昇腾 NPU 是什么?
昇腾 NPU(Neural Processing Unit)是一类专为 AI 计算优化的处理器,与 GPU 类似,但在矩阵乘法、向量计算、深度学习算子上进行了深入优化,具备更高能效比。
核心特点:
面向 AI 算法设计的专用处理器
强矩阵计算能力(Cube Unit)
高带宽 HBM 显存
自主可控 AI 软硬件生态
二、昇腾 NPU 产品系列
- Ascend 910 / 910B(训练型)
面向 AI 大模型训练
强大算力(单卡可达百 TFlops 级)
大显存 HBM
主流用于数据中心、云计算场景
- Ascend 310(推理型)
面向边缘推理
低功耗、低成本
适用于摄像头、工业设备、边缘服务器
- Ascend 710 / 910B3 / 310B 等系列
根据功率、算力、应用场景细分
广泛应用于训练、推理、推断、图像识别等场景
三、昇腾 NPU 的软件生态
-
昇腾平台使用 CANN(Compute Architecture for Neural Networks) 软件栈,包括:
-
ACL(Ascend Compute Library):底层算子调用
-
PyTorch NPU 适配(torch-npu)
-
TensorFlow / MindSpore 适配
-
模型转换工具 ATC(从 ONNX、TF 转换到 OM 模型)
-
Profiling / 调优工具
-
开发者可以使用 PyTorch、MindSpore、TensorFlow 等主流框架,几乎与 GPU 使用方式一致。
四、昇腾 NPU 的优势
- 高能效比
专为矩阵运算设计,AI 算力更高、功耗更低。
- 软硬件协同优化
CANN + NPU 深度融合,使得训练速度、推理性能更高。
- 强大的国产 AI 生态
从芯片、驱动到框架完全国产化,适用于政企、金融、电信等需要自主可控的行业。
- 支持大模型训练
910/910B 系列已经在业界大规模训练场景落地。
五、技术文档
六、部署 背景
-
通过 K8s 集群把 npu 节点加入到当前集群,官方目前本还是建议 docker 部署 npu
-
kuberentes 1.31
-
contained v1.7.13
-
华为鲲鹏 910B 芯片
一、安装昇腾 驱动和固件
-
注释:客户买入的 NPU 华为基本上都会部署驱动和固件
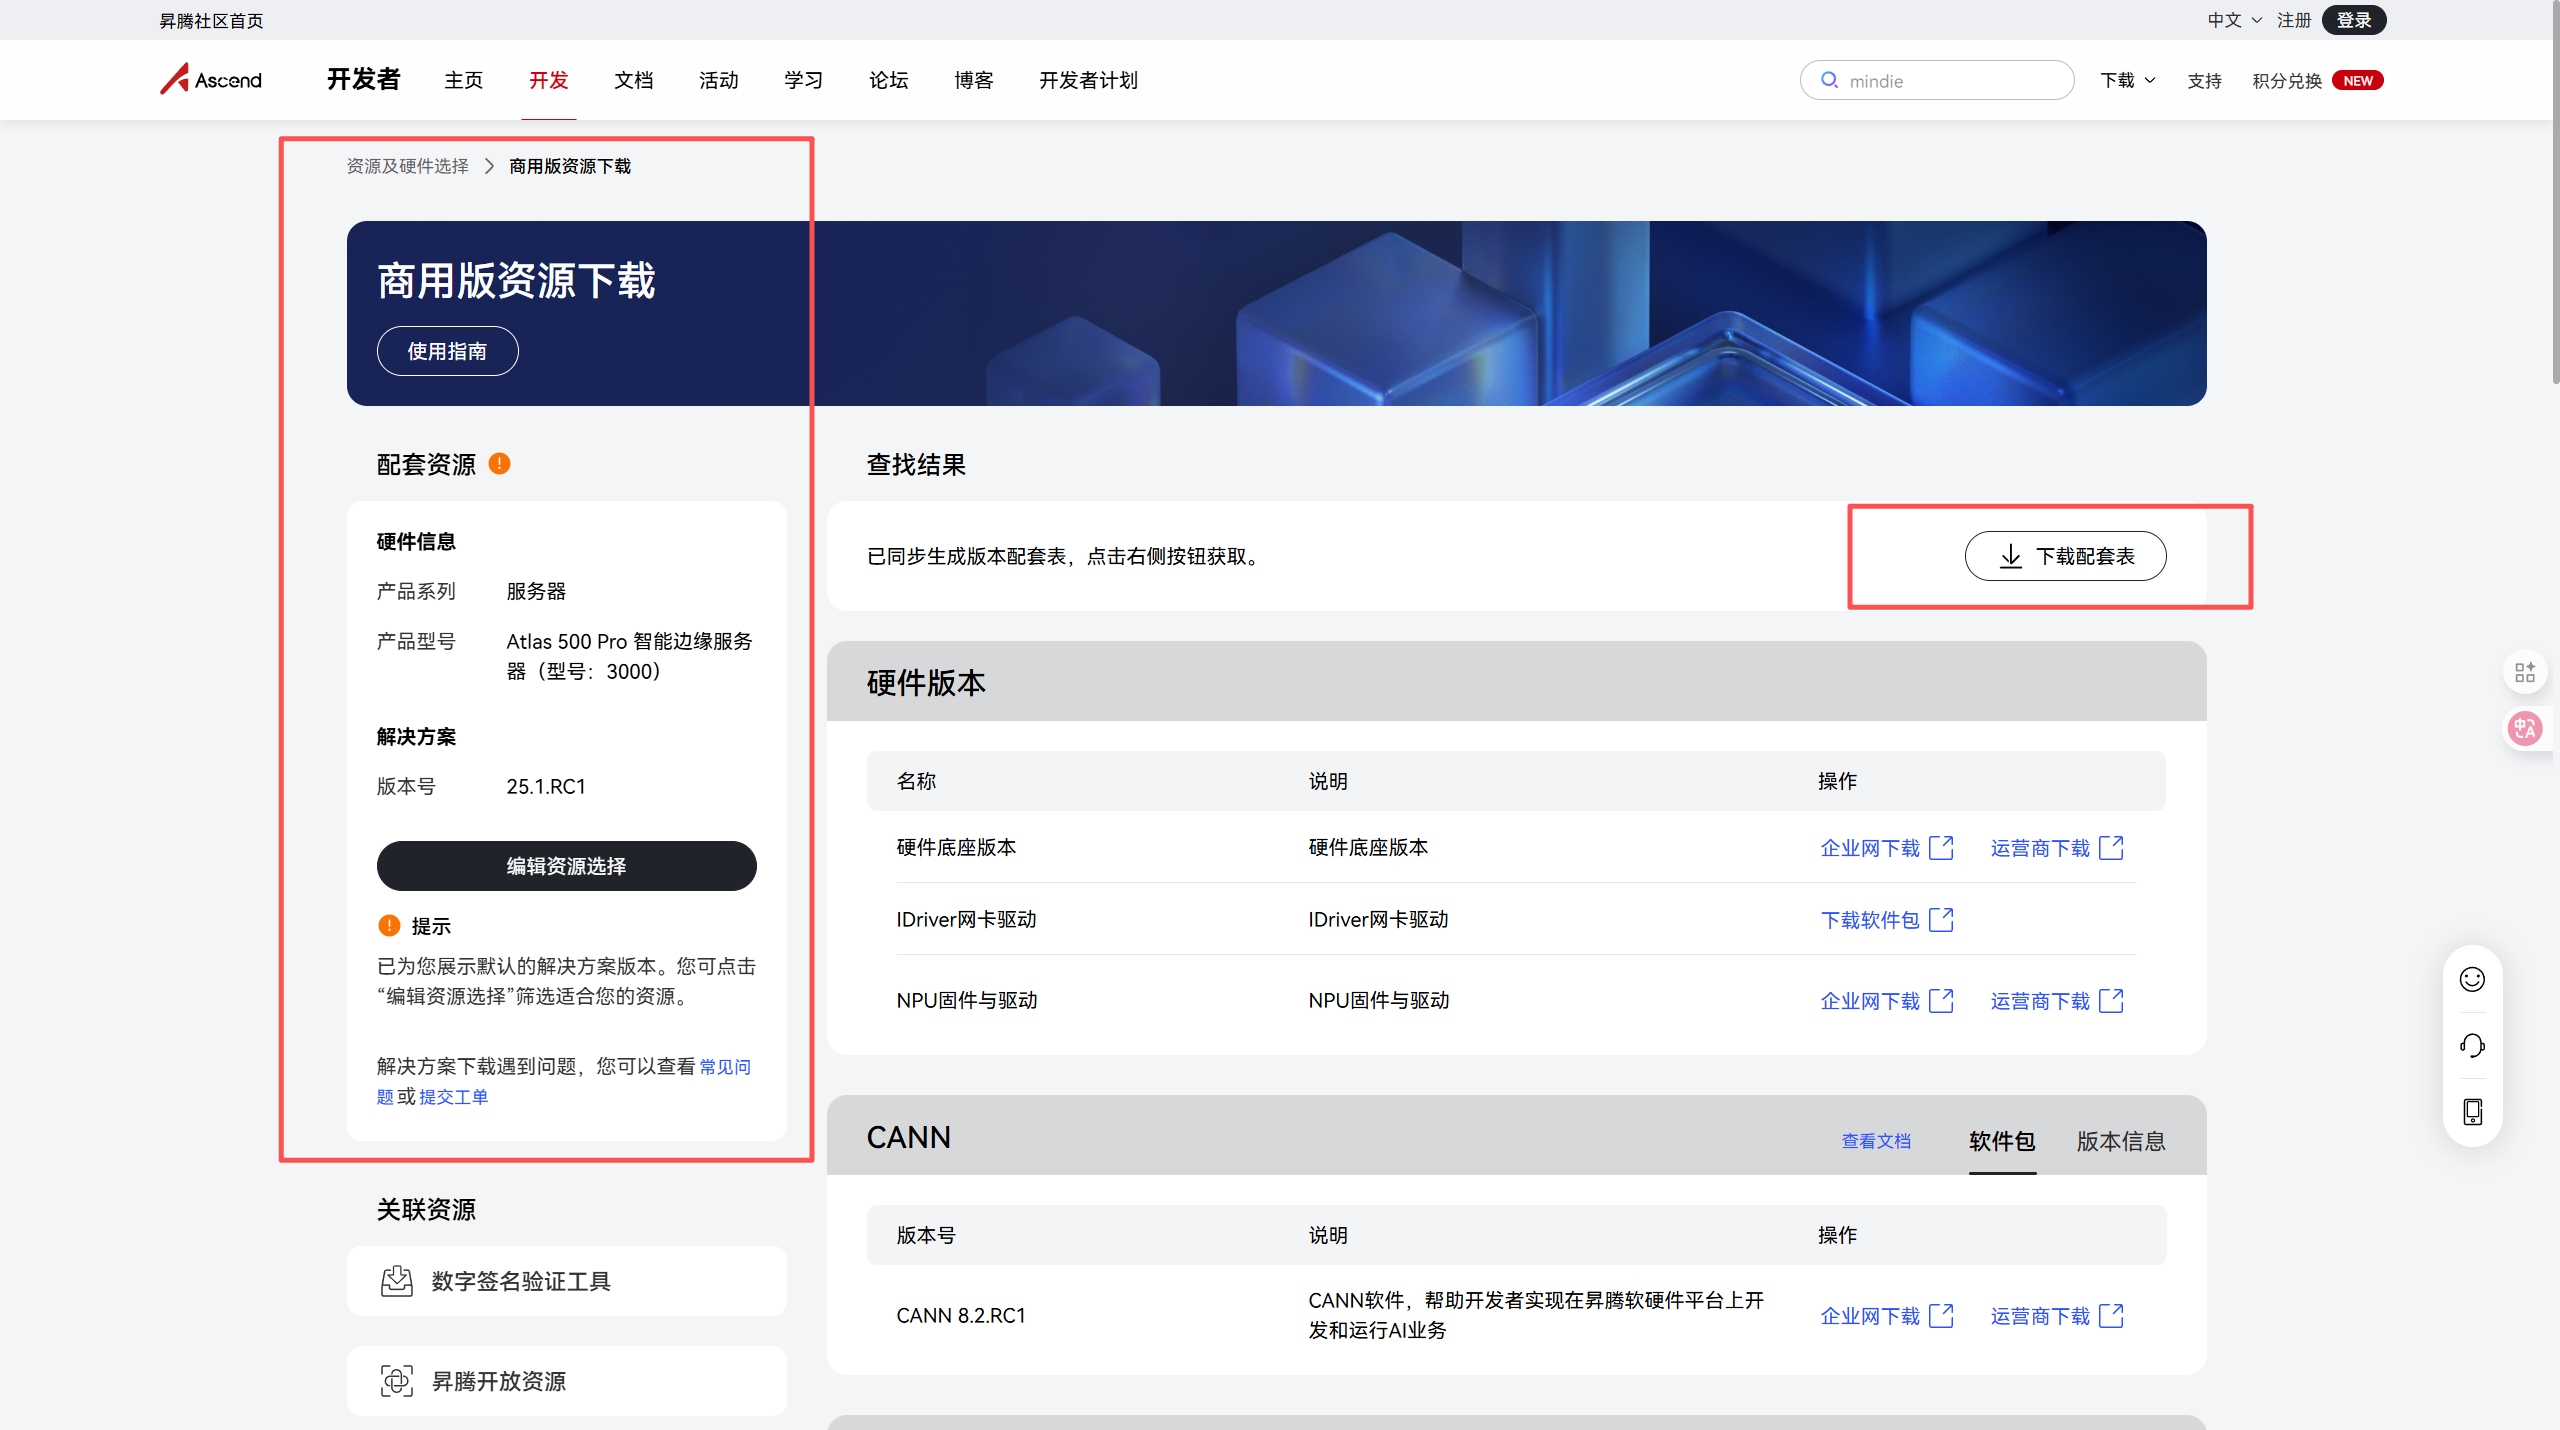
1.下载对应系统的安装包,可根据资源型号编辑完成下载
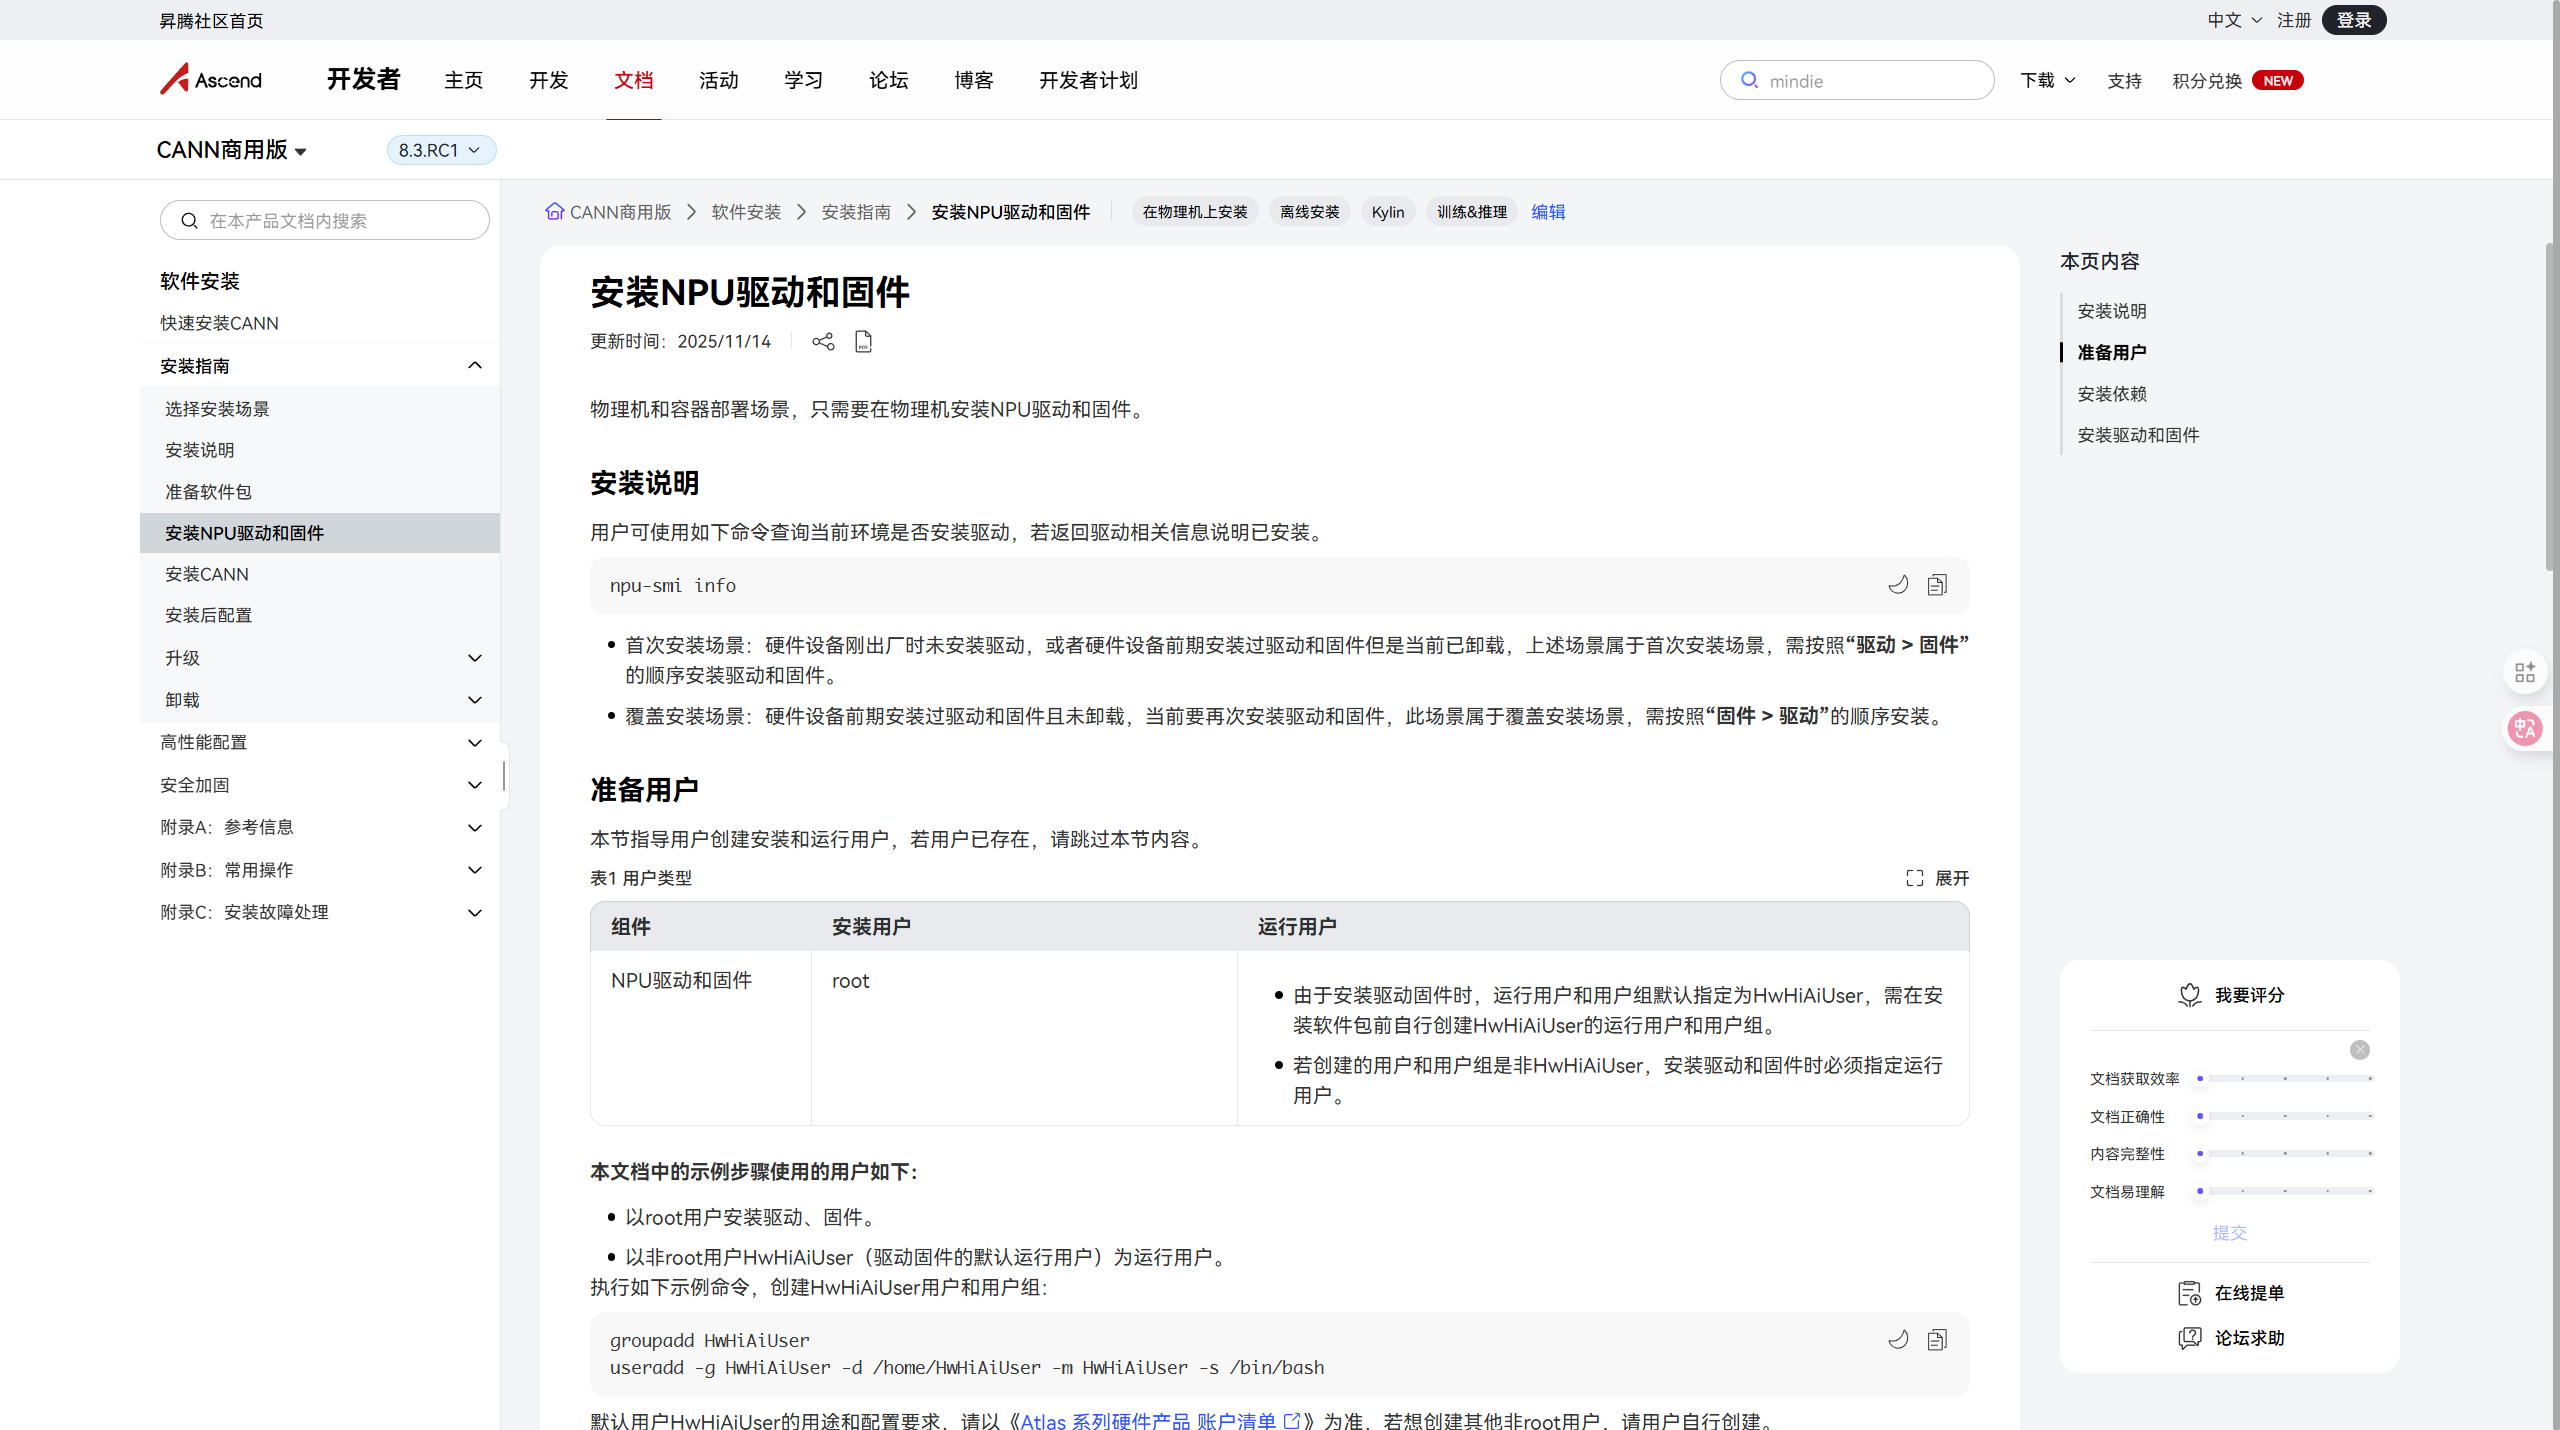
2.安装 NPU 驱动和固件
3.安装 CANN(可选)
二、安装容器化插件支持(Ascend Docker Runtime)
1.软件下载
-
docker 和 contained 软件包 都属于 Ascend Docker Runtime
-
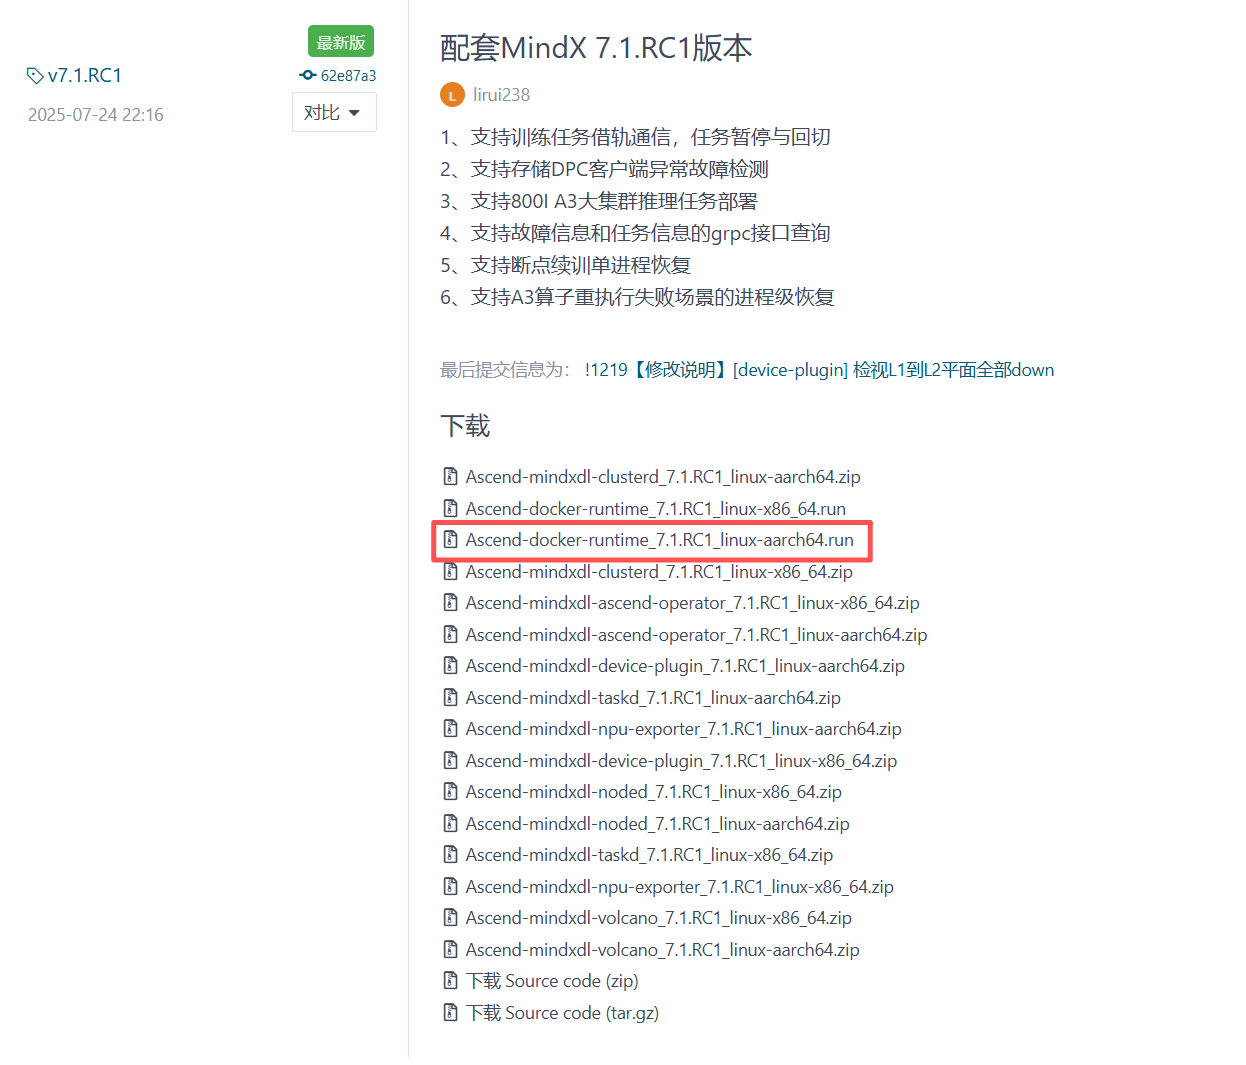
根据 CPU 架构选择要下载的的包 amd64/arm64
2.这边是 arm64 所以下载对应的容器化插件,如果 k8s 版本低可以按照官网对应的版本去下载
3.软件安装
- 特地找官方问了下 contained 也是下载 docker 包
# 鲲鹏910B arm 芯片
# 将下载的包放到服务器上 在服务器上同目录下运行

#添加权限
chmod u+x Ascend-docker-runtime_7.1.RC1_linux-aarch64.run

#执下命令,校验软件包安装文件的一致性和完整性。
 Ascend-docker-runtime_7.1.RC1_linux-aarch64.run --check

# 回显如下信息代码检验成功
[WARNING]: --check is meaningless for Ascend-docker-runtime and will be discarded in the future
Verifying archive integrity... ./Ascend-docker-runtime_7.1.RC1_linux-x86_64.run does not contain an embedded SHA256 checksum.
...
 All good.

#安装
./Ascend-docker-runtime_7.1.RC1_linux-aarch64.run --install

# 回显示例如下,表示安装成功。
Uncompressing ascend-docker-runtime  100%
[INFO]: installing ascend docker runtime
...
[INFO] Ascend Docker Runtime install success
三、安装容器化插件 Ascend Device Plugin
-
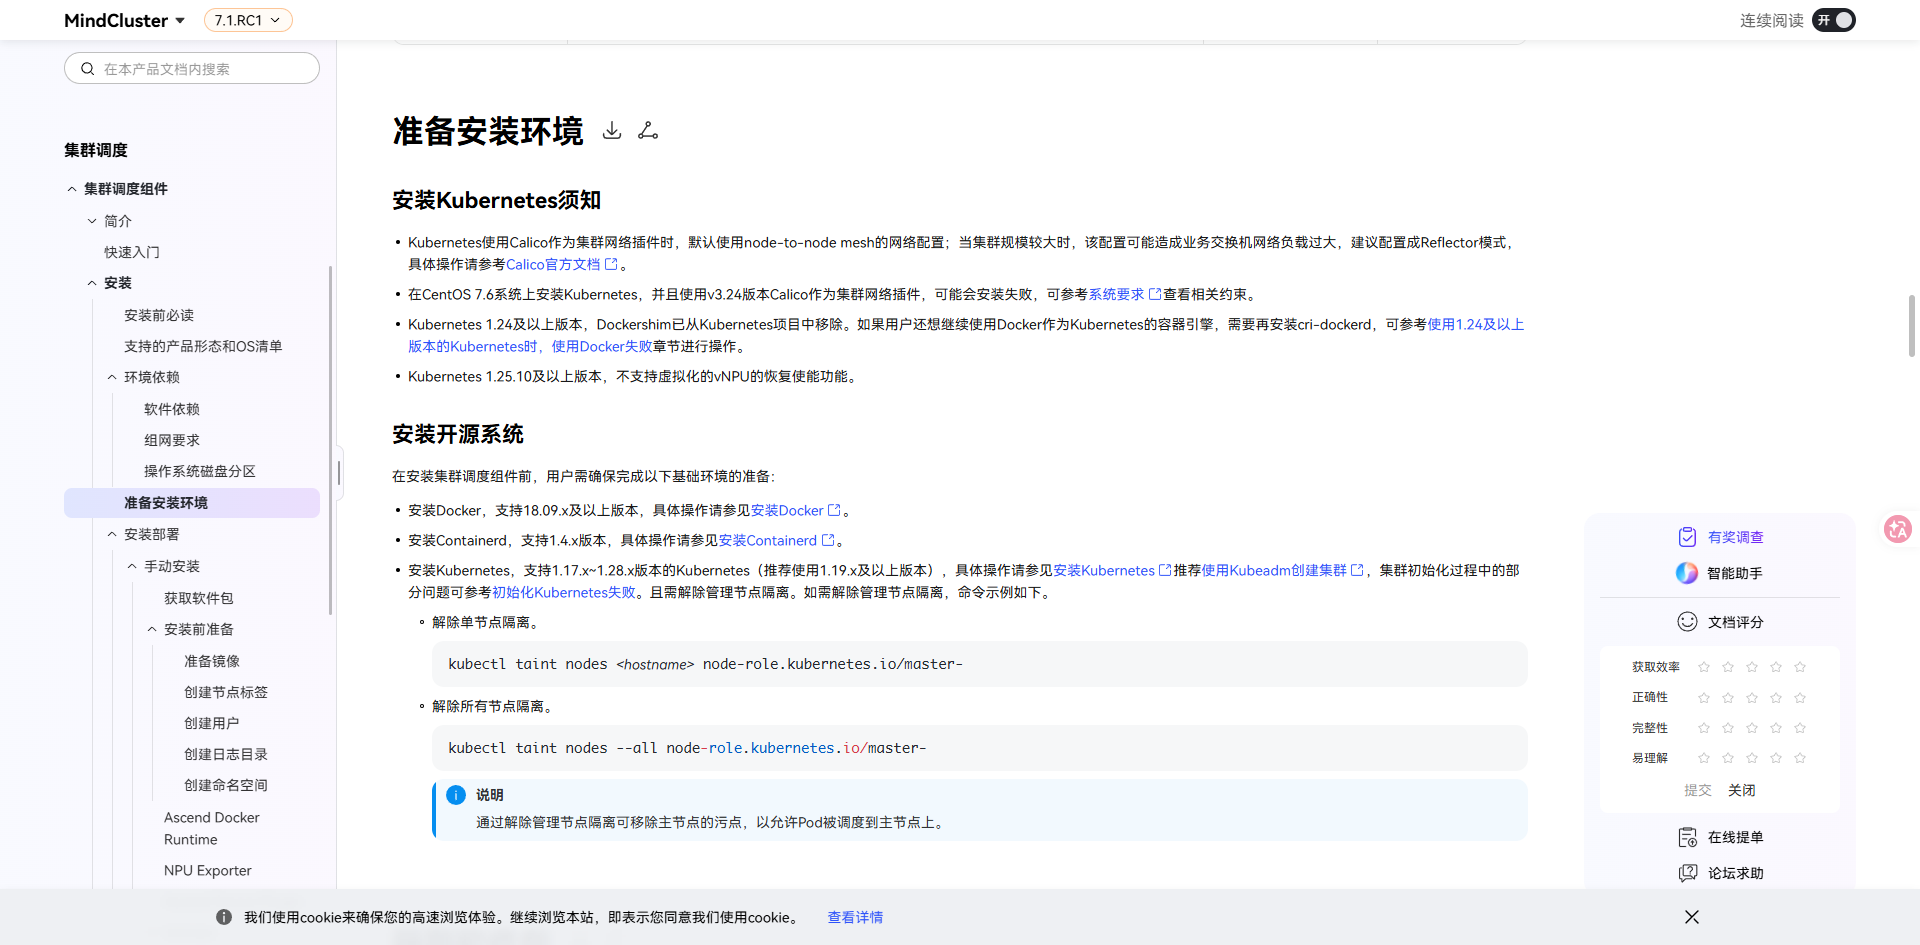
昇腾社区文档安装说明 如下组件如果需要配套安装也可以看需求
1.华为官方镜像仓库下载
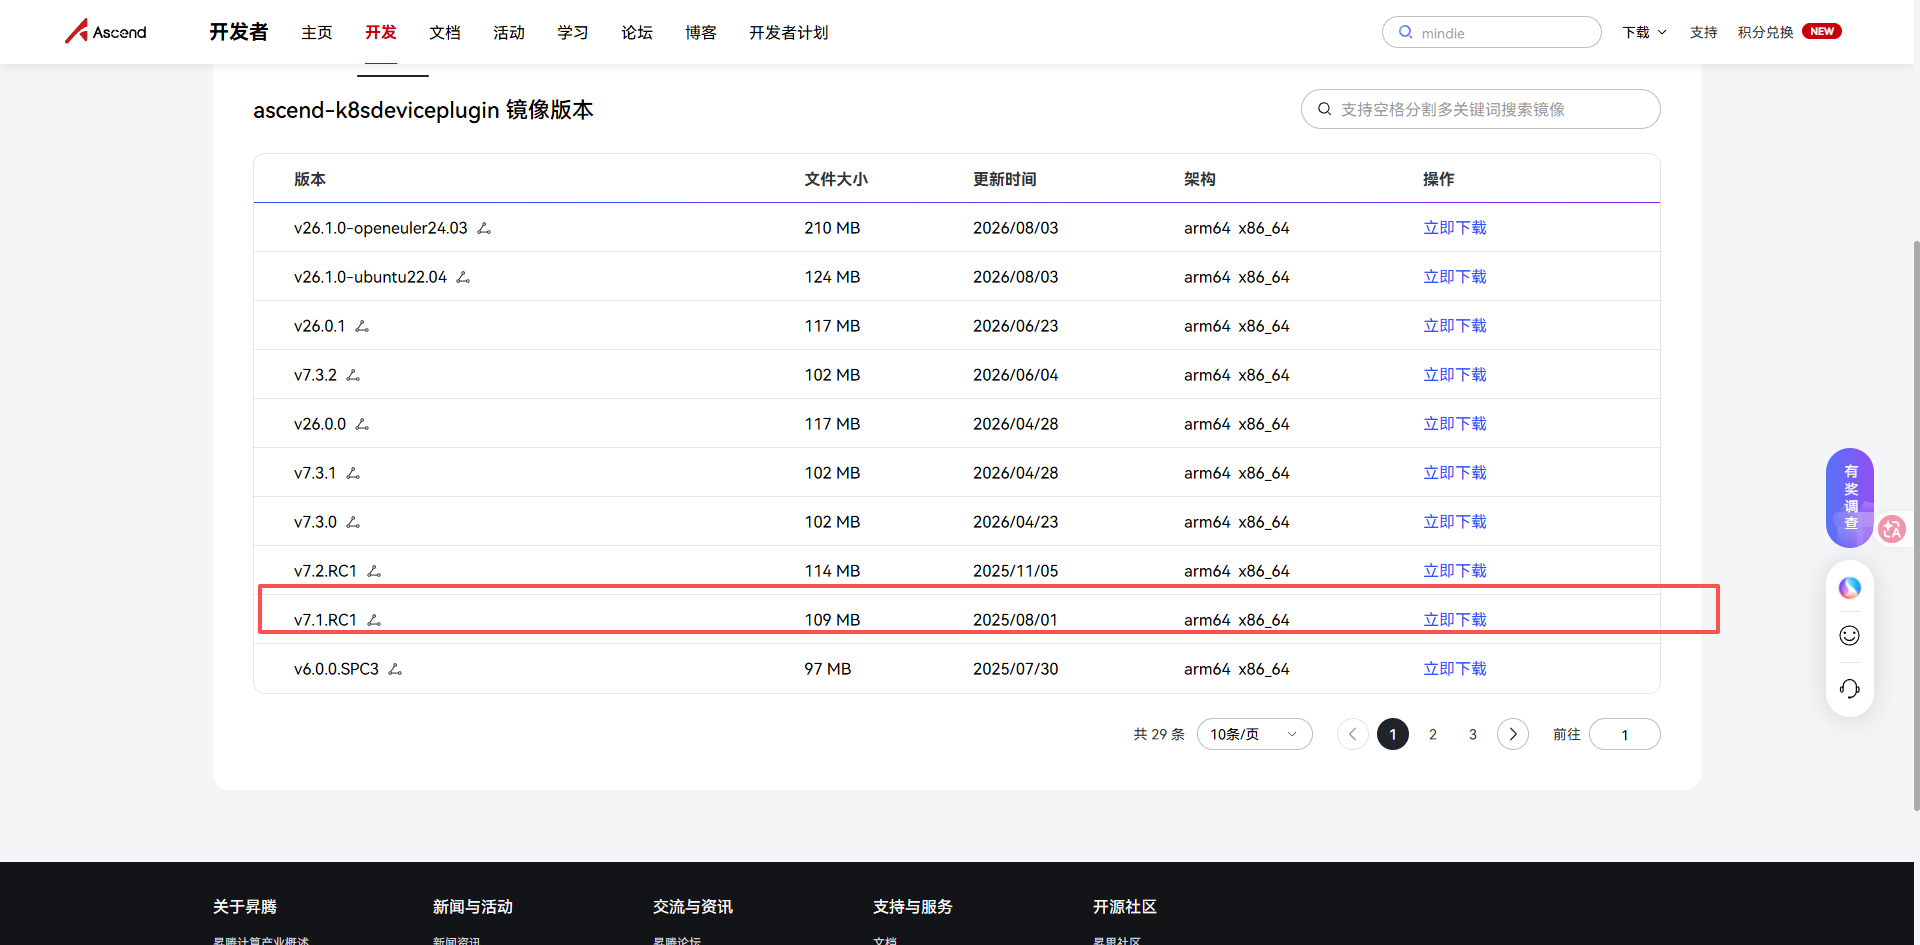
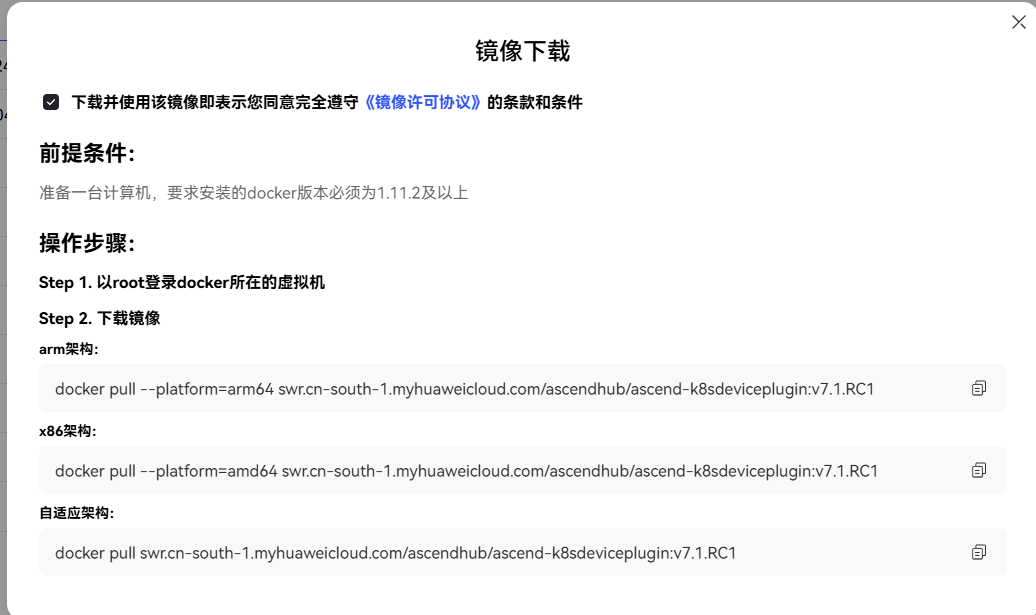
按照架构下载对应的镜像
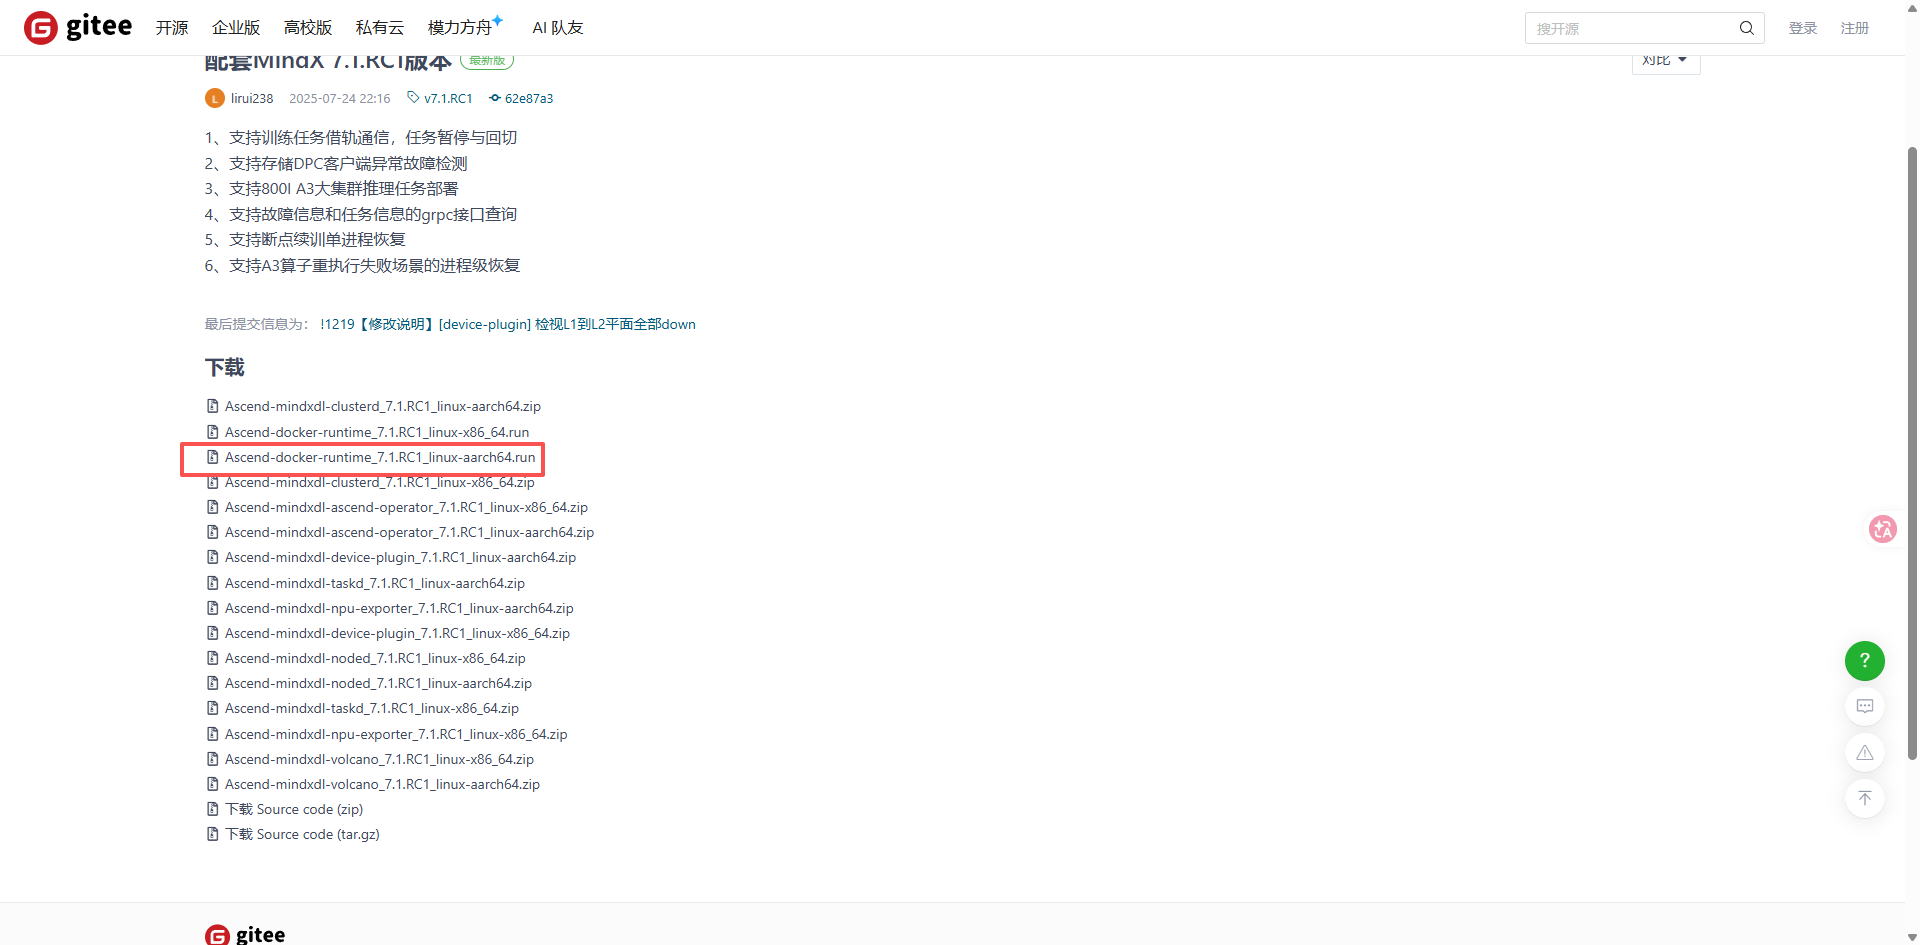
2.下载华为官方 yaml 进行部署
3. 部署容器和插件 Ascend Device Plugin
# 修改镜像标签名
ctr -n k8s.io image tag swr.cn-south-1.myhuaweicloud.com/ascendhub/ascend-k8sdeviceplugin:v7.1.0RC1 ascend-k8sdeviceplugin:v7.1.0RC1

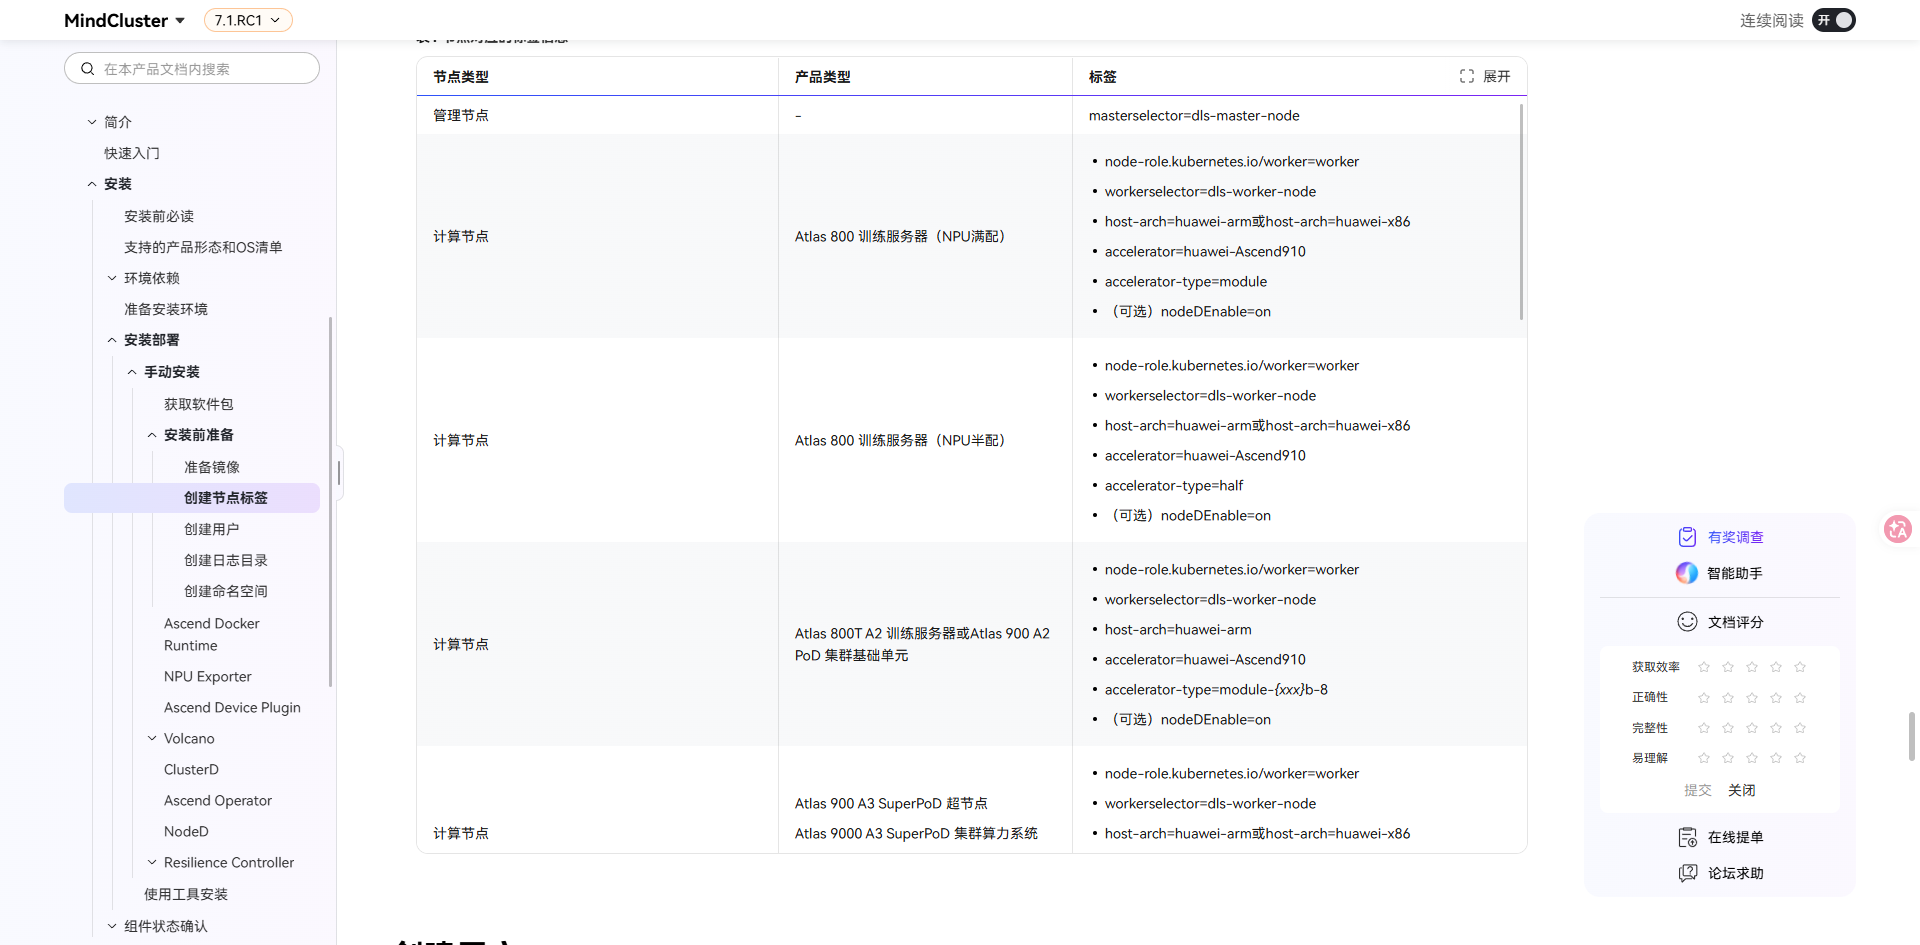
# 必须给主节点打标签需要注意 根据型号查询 这里特殊说明下我不是用的华为机器 但按照芯片型号打标签好像没问题
kubectl label nodes 192.168.1.1 masterselector=dls-master-node  # 管理节点

kubectl label nodes 192.168.1.2 accelerator=huawei-Ascend910  # 计算节点
kubectl label nodes 192.168.1.2 node-role.kubernetes.io/worker=worker  # 计算节点
kubectl label nodes 192.168.1.2 workerselector=dls-worker-node  # 计算节点
kubectl label nodes 192.168.1.2 host-arch=huawei-arm  # 计算节点
kubectl label nodes 192.168.1.2 accelerator-type=module  # 计算节点

# 修改下载的yaml配置 宿主机没有地址挂载路径可以改成 DirectoryOrCreate
      volumes:
		...
        - name: log-path
          hostPath:
            path: /var/log/mindx-dl/devicePlugin
            type: DirectoryOrCreate
        ...

# 解压包后查看 当前npu型号
npu-smi info

# 查看出现的型号是 910
kubectl apply -f {device-plugin-name}-910-{version}.yaml

# 会以daemonset方式启动在npu节点上,完成后可以通过查看npu节点显示npu

910 这两个命令分别是:
device-plugin-910-v{version}.yaml 对应:Atlas 训练系列产品或Atlas A2 训练系列产品上不使用MindCluster Volcano的配置文件。
device-plugin-volcano-v{version}.yaml对应:Atlas 训练系列产品或Atlas A2 训练系列产品上使用MindCluster Volcano的配置文件。
{device-plugin-name}:表示对应 软件版本yaml文件的前缀名,如上所述,v2.0.3.6版本之前为“ascendplugin”,后续版本为“device-plugin”。
{version}:表示镜像版本,需要和启动的yaml文件版本保持一致。
-
给节点打标签需要注意 根据型号查询
-
创建节点标签-安装前准备-手动安装-安装部署-安装-集群调度组件-集群调度-MindCluster7.1.RC1开发文档-昇腾社区
- 服务成功后会显示当前有 GPU 信息
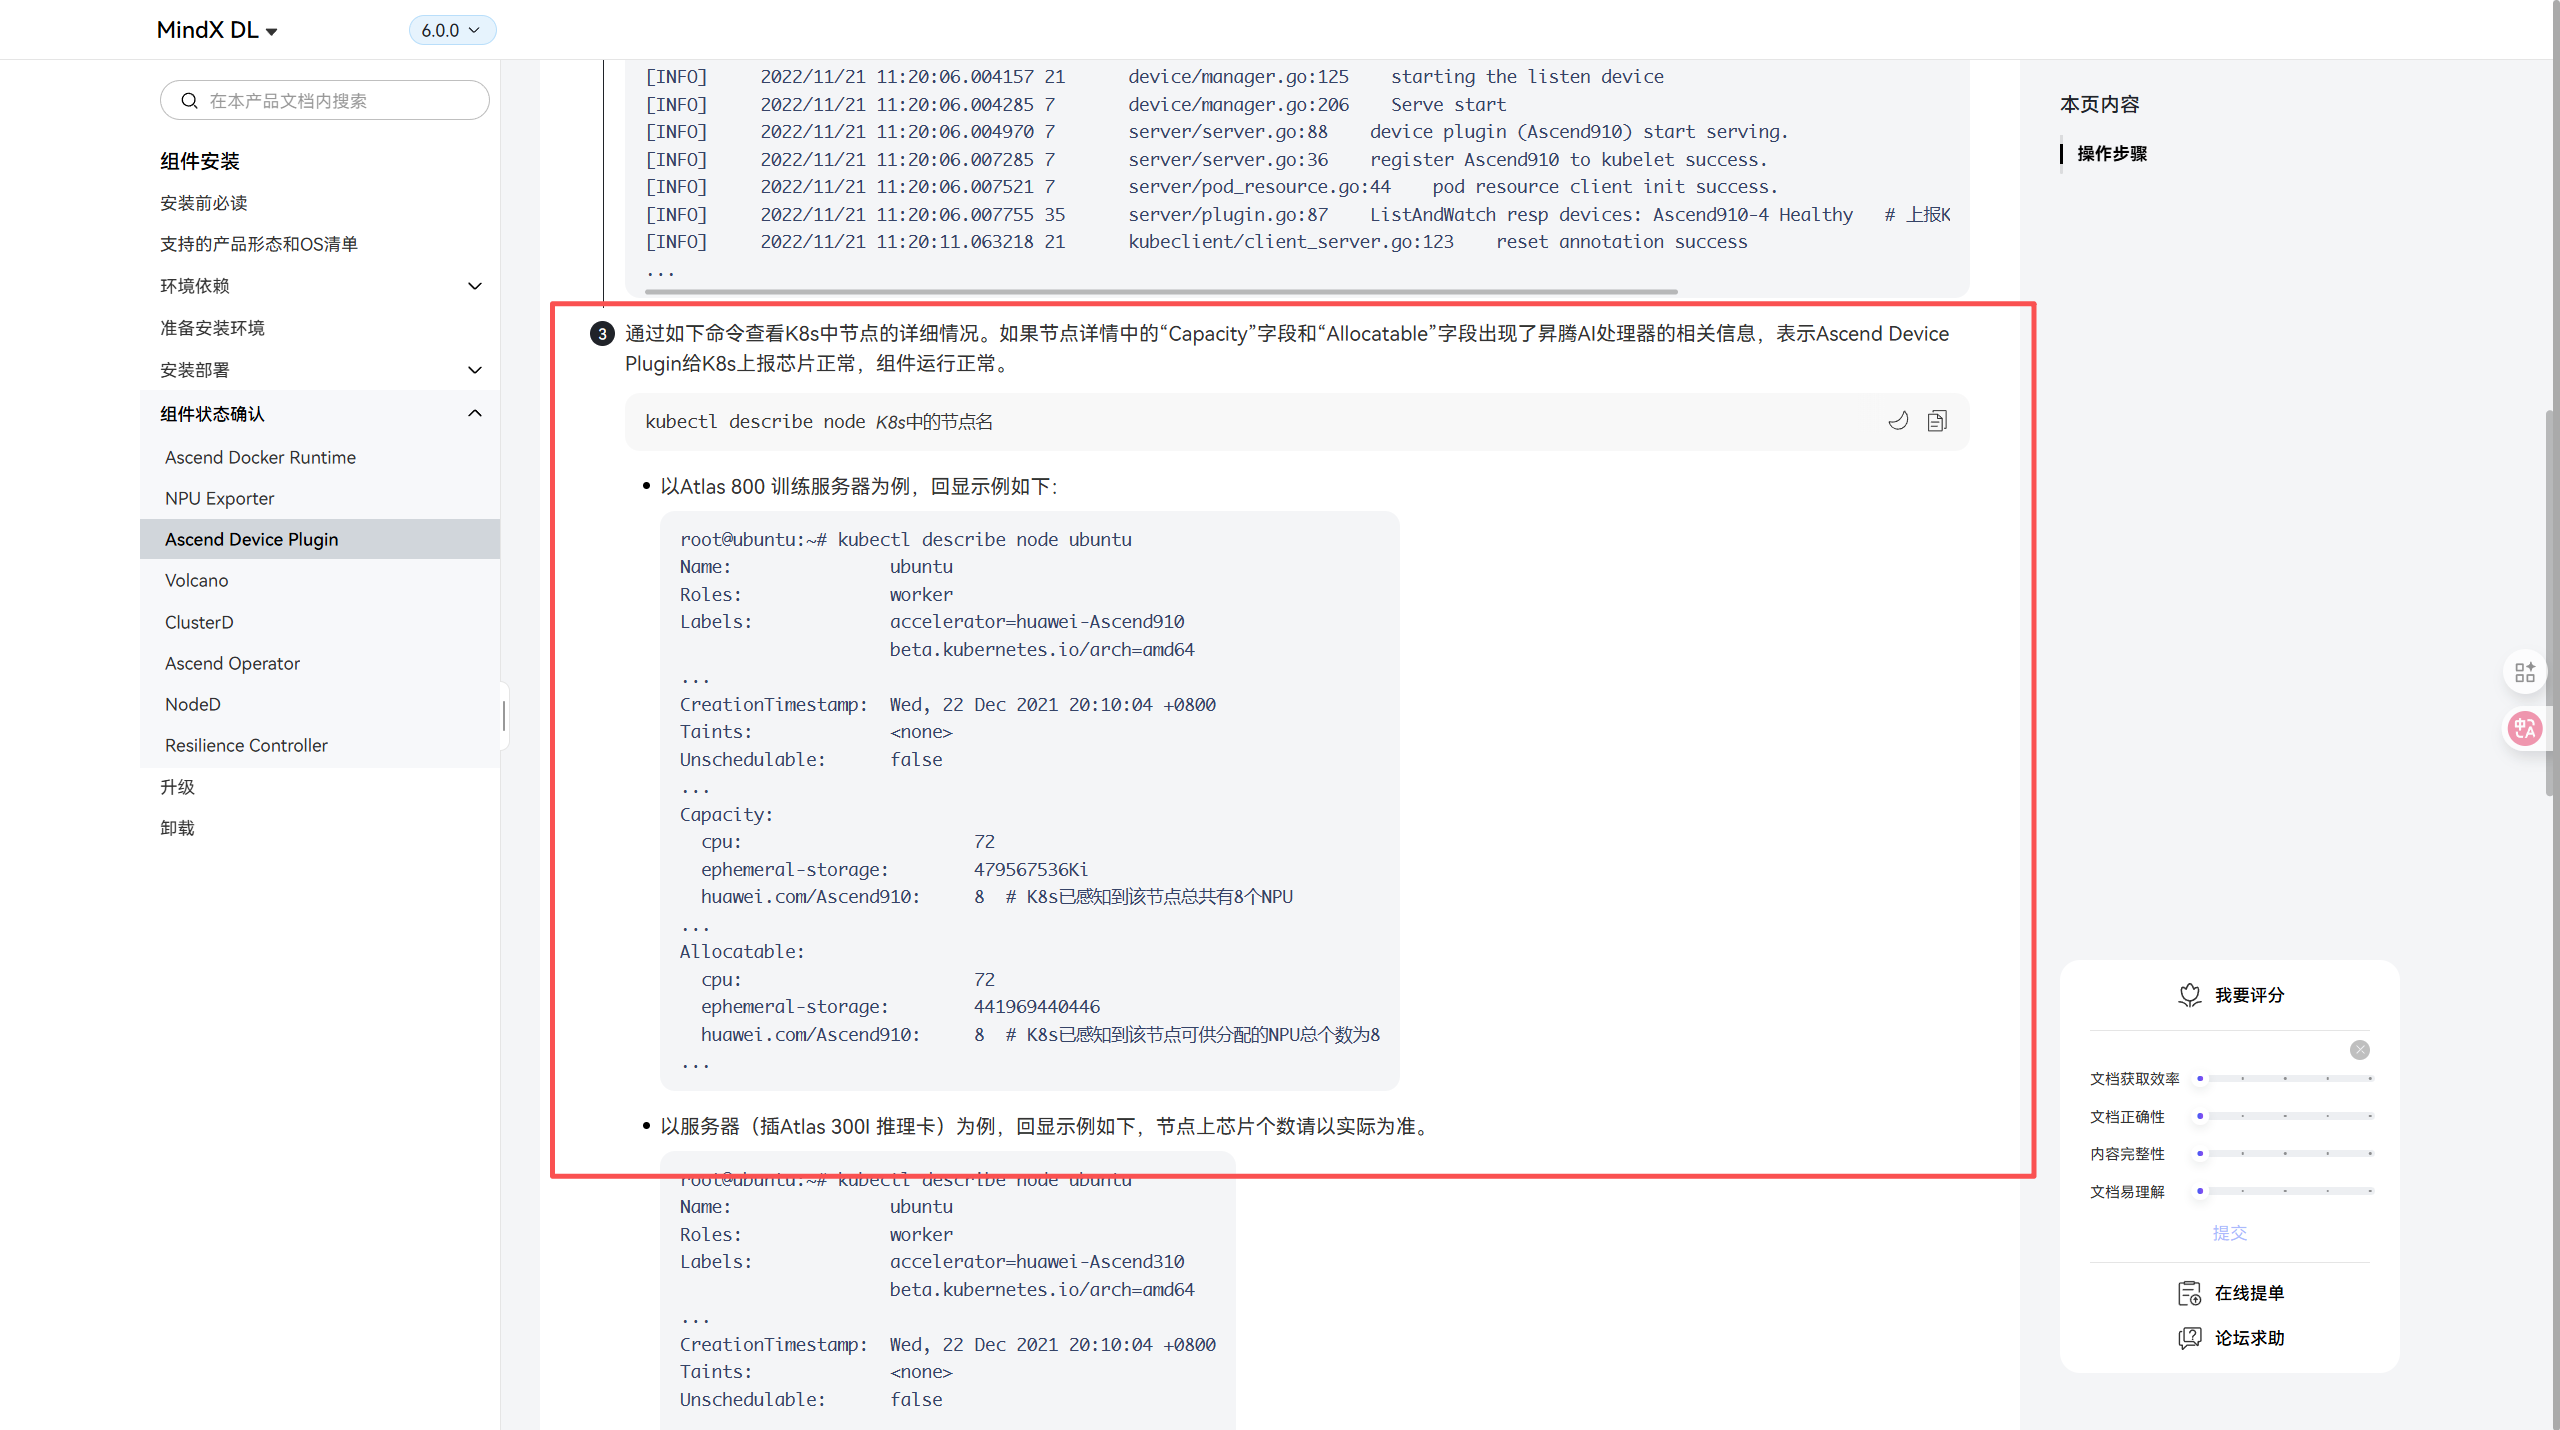
4.训练服务分配算力
# 使服务可以挂载卡,挂载成功后可以在容器内跑命令查看
npu-smi info

requests:
  huawei.com/Ascend910: 1        # 修改为910,这里模型使用1卡
limits:
  huawei.com/Ascend910: 1        # 修改为910,这里模型使用1卡

volumeMounts:  # 容器内路径
- name: slog
  mountPath: /usr/slog/
- name: driver                   # nerdctl手动挂载的驱动目录,docker可以依赖于docker runtime
  mountPath: /usr/local/Ascend/driver/
- name: npu                      # nerdctl手动挂载的驱动目录,docker可以依赖于docker runtime
  mountPath: /usr/local/bin/npu-smi
- name: sbin
  mountPath: /usr/local/sbin/npu-smi
- name: dcmi
  mountPath: /usr/local/dcmi
- name: shm                      # 设置shm
  mountPath: /dev/shm

volumes:  # 宿主机路径
- name: slog
  hostPath:
四、部署过程中问题说明
1. 遇到了无法网关获取IP的问题 找了很久都没解决 社区也没 k8s 相关案例,如果有 GO 代码基础建议拉源代码分析问题
# 查看服务日志
k logs -nkube-system ascend-device-plugin-daemonset-6vhtz

[INFO]  2026/08/08 15:41:28.622135 230     common/common.go:695    update signal send, pod update
[INFO]  2026/08/08 15:41:29.080056 246     server/manager.go:536   Received update trigger, processing device info update
[WARN]  2026/08/08 15:41:36.083369 253     server/manager.go:521   get Ascend910-0 device ip failed, err: get device IP address failed, cardID(0), deviceID(0), error code: -8823
[WARN]  2026/08/08 15:41:36.085283 253     server/manager.go:521   get Ascend910-1 device ip failed, err: get device IP address failed, cardID(1), deviceID(0), error code: -8823
[WARN]  2026/08/08 15:41:36.087060 253     server/manager.go:521   get Ascend910-2 device ip failed, err: get device IP address failed, cardID(2), deviceID(0), error code: -8823
[WARN]  2026/08/08 15:41:36.090230 253     server/manager.go:521   get Ascend910-3 device ip failed, err: get device IP address failed, cardID(3), deviceID(0), error code: -8823
[WARN]  2026/08/08 15:41:36.093428 253     server/manager.go:521   get Ascend910-4 device ip failed, err: get device IP address failed, cardID(4), deviceID(0), error code: -8823
[WARN]  2026/08/08 15:41:36.095381 253     server/manager.go:521   get Ascend910-5 device ip failed, err: get device IP address failed, cardID(5), deviceID(0), error code: -8823
[WARN]  2026/08/08 15:41:36.098475 253     server/manager.go:521   get Ascend910-6 device ip failed, err: get device IP address failed, cardID(6), deviceID(0), error code: -8823
[WARN]  2026/08/08 15:41:36.101407 253     server/manager.go:521   get Ascend910-7 device ip failed, err: get device IP address failed, cardID(7), deviceID(0), error code: -8823
[INFO]  2026/08/08 15:41:42.650827 230     kubeclient/kube_cache.go:118    pod(monitoring/node-exporter-8rrkr) is update to cache
[INFO]  2026/08/08 15:41:42.650148 230     common/common.go:695    update signal send, pod update
[INFO]  2026/08/08 15:41:43.080078 246     server/manager.go:536   Received update trigger, processing device info update

# 设置该 RoCE 网卡的默认网关为 172.22.10.254 即解决问题
for i in {0..7}; do hccn_tool -i $i -gateway -s gateway 172.22.10.254; done
2.在目前的集群我还发下一个问题在同一个集群内 无法支持两个服务同时训练,这样会导致两个服务同时很慢但也查不出来原因是什么 也没有说明
- docker 或 contained 版本下可以两个服务同时训练加上服务
3.NPU 分配的卡号是随机的每次服务重启都会变,服务要也是一样是设备的 ID 号
参考部分原文说明
原文链接:https://blog.csdn.net/qq_34518674/article/details/145637041
更多推荐



 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)