
吃透 K8s 资源限制、健康检测与权限体系,集群运维不再踩坑
Quota and Limits
学习参考:
环境准备
-
创建一个独立的名字空间 quota,并切换到该 ns
root@master30 ~ 10:41:34# kubectl create ns quota namespace/quota created root@master30 ~ 10:43:01# kubectl config set-context --current --namespace quota Context "kubernetes-admin@kubernetes" modified. -
提前部署好 Metric Server
ResourceQuota
**问题:**当多个用户或业务团队共用一套 Kubernetes 集群时,部分使用者可能会占用超出公平分配额度的集群资源。
**解决:**可通过资源配额机制对命名空间的资源使用总量做约束管控。
资源配额由 ResourceQuota 对象定义,用于为单个命名空间设置资源消耗总量上限。
资源配额的运行逻辑如下:
-
不同业务团队分配独立命名空间开展业务,该隔离策略可通过 RBAC 权限体系强制落地。
-
集群管理员可针对每个命名空间创建一个或多个 ResourceQuota 资源对象。
-
用户在命名空间内创建 Pod、Service 等资源时,Kubernetes 配额控制器会实时统计资源占用量,确保实际消耗不超过 ResourceQuota 中定义的硬性限额。
-
若资源创建 / 更新操作触发配额限制,API 服务会返回 HTTP 403 FORBIDDEN 拒绝请求,并在返回信息中标注违规的配额约束项。
-
若命名空间已开启 CPU、内存等计算资源配额,用户创建 Pod 时必须同时声明资源请求值(request)与资源上限值(limit),否则配额控制器会拦截 Pod 创建请求。
提示:可借助
LimitRanger准入控制器,为未显式配置计算资源参数的 Pod 自动填充默认值。
启用资源配额
Kubernetes 集群默认开启资源配额能力。只要 API 服务启动参数 --enable-admission-plugins= 配置项中包含 ResourceQuota,配额功能即全局生效。
若某个命名空间下存在至少一个 ResourceQuota 对象,则该命名空间的配额校验逻辑会自动启用。
配额类型
Kubernetes 支持两类资源配额管控:
-
资源对象数量配额:管控集群各类资源实例的总数量,例如 Pod、Service 等。
配置对象数量配额能够提升集群稳定性:避免 Etcd 存储无限制膨胀,同时防止 Service 占用节点 IP 地址等专属集群资源。
-
计算资源配额:管控物理 / 虚拟算力容量,包含 CPU、内存、持久化存储容量。
配置计算资源配额可避免单个命名空间抢占节点全部算力资源,防止该命名空间业务耗尽集群资源后,其他命名空间应用无法正常调度运行。
kubernetes 通过
ResourceQuota类型资源实施配额。单个命名空间可配置多个
ResourceQuota对象,所有对象的限制规则会叠加生效;常规最佳实践中,不会用多个配额对象管控同一种资源。 -
支持管控的资源对象:
persistentvolumeclaimsservicessecretsconfigmapsreplicationcontrollersdeployments.appsreplicasets.appsstatefulsets.appsjobs.batchcronjobs.batch
-
计算资源
资源名称 描述 limits.cpu命名空间内所有未终止 Pod 的 CPU 上限总和,不可超过该数值。 limits.memory命名空间内所有未终止 Pod 的内存上限总和,不可超过该数值。 requests.cpu命名空间内所有未终止 Pod 的 CPU 请求总和,不可超过该数值。 requests.memory命名空间内所有未终止 Pod 的内存请求总和,不可超过该数值。 requests.storage命名空间内所有持久卷声明的存储请求总和,不可超过该数值。 cpu等效于 requests.cpumemory等效于 requests.memory
单位说明:
-
CPU:1 cpu 等同于 1000 m,无单位标识时默认单位为 CPU 核心数。
-
memory
:支持两种计量进制格式。
- Ki | Mi | Gi | Ti | Pi | Ei:基于 1024 进制换算,例如 1024Ki = 1Mi
- k | M | G | T | P | E:基于 1000 进制换算,例如 1000k = 1M
- 纯数字无单位时默认单位为 G,例如填写 1.5,代表 1500M。
配额管理
**重要说明:**若命名空间配额已约束 request 与 limit 总量,则创建 Pod 时必须同时声明 request 和 limit 参数。
创建 ResourceQuota 对象
root@master30 ~ 10:49:46# kubectl create quota myquota --hard=pods=2,services=3,secrets=5,persistentvolumeclaims=10
resourcequota/myquota created
root@master30 ~ 11:24:35# kubectl get resourcequotas
NAME      AGE   REQUEST                                                                LIMIT
myquota   10s   persistentvolumeclaims: 0/10, pods: 0/2, secrets: 0/5, services: 0/3
root@master30 ~ 11:24:45# kubectl describe quota myquota
Name:                   myquota
Namespace:              quota
Resource                Used  Hard
--------                ----  ----
persistentvolumeclaims  0     10
pods                    0     2
secrets                 0     5
services                0     3
通过 yaml 文件创建
apiVersion: v1
kind: ResourceQuota
metadata:
  name: myquota
spec:
  hard:
    persistentvolumeclaims: "10"
    pods: "2"
    secrets: "5"
    services: "3"
测试配额
root@master30 ~ 11:25:10# kubectl create deployment web --image=hub.laoma.cloud/library/nginx --replicas=3
deployment.apps/web created
root@master30 ~ 11:25:27# kubectl get all
NAME                       READY   STATUS    RESTARTS   AGE
pod/web-759dfd9847-ddcjt   1/1     Running   0          4s
pod/web-759dfd9847-hgc8f   1/1     Running   0          4s
NAME                  READY   UP-TO-DATE   AVAILABLE   AGE
deployment.apps/web   2/3     2            2           4s
NAME                             DESIRED   CURRENT   READY   AGE
replicaset.apps/web-759dfd9847   3         2         2       4s
root@master30 ~ 11:25:31# kubectl describe rs web-759dfd9847
LAST SEEN   TYPE      REASON              OBJECT                     MESSAGE
......
Normal   SuccessfulCreate  22s                replicaset-controller  Created pod: web-759dfd9847-ddcjt
  Warning  FailedCreate      22s                replicaset-controller  Error creating: pods "web-759dfd9847-r9bdx" is forbidden: exceeded quota: myquota, requested: pods=1, used: pods=2, limited: pods=2
# 超过配额,创建失败
# 修改配额 pod数量为10
root@master30 ~ 11:25:49# kubectl patch resourcequotas myquota -p '{"spec":{"hard":{"pods":10}}}'
resourcequota/myquota patched
# 此时重新扩展rs
root@master30 ~ 11:27:08# kubectl scale rs web-759dfd9847 --replicas 3
replicaset.apps/web-759dfd9847 scaled
# 再次验证pod数量
root@master30 ~ 11:27:22# kubectl get pods
NAME                   READY   STATUS    RESTARTS   AGE
web-759dfd9847-ddcjt   1/1     Running   0          2m1s
web-759dfd9847-hgc8f   1/1     Running   0          2m1s
web-759dfd9847-z7t94   1/1     Running   0          6s
# 清理环境
root@master30 ~ 11:27:28# kubectl delete deployments.apps web
deployment.apps "web" deleted
root@master30 ~ 11:27:40# kubectl delete resourcequotas myquota
resourcequota "myquota" deleted
**思考:**若单个用户拥有多个命名空间的管理权限,能否针对该用户整体配置统一配额限制?
Request 和 Limits
若命名空间已开启 CPU、内存类计算资源配额,则创建 Pod 时必须显式配置 request 与 limit 参数,否则配额控制器会拒绝 Pod 创建请求。
Pod 中containers.resources配置项包含两组核心参数:
- requests:定义 Pod 正常运行所需的最低算力资源,调度器会筛选剩余资源满足该请求的节点完成调度。
- limits:定义 Pod 运行可占用节点资源的最大上限,用于防止单容器耗尽节点算力;底层依托 Linux 内核 cgroup 机制完成资源限制。
测试 - 不指定计算资源
配额示例
root@master30 ~ 11:27:49# vim resourcequota.yaml
apiVersion: v1
kind: ResourceQuota
metadata:
  name: myquota
spec:
  hard:
    persistentvolumeclaims: "10"
    pods: "2"
    secrets: "5"
    services: "3"
    requests.cpu: 1000m
    requests.memory: "2048Mi"
    limits.cpu: 1000m
    limits.memory: "2048Mi"
root@master30 ~ 11:28:12# kubectl apply -f resourcequota.yaml
resourcequota/myquota created
pod 示例
root@master30 ~ 11:28:19# vim pod-without-quota.yaml
apiVersion: v1
kind: Pod
metadata:
  name: web
  labels:
    app: web
spec:
  containers:
  - name: web
    image: httpd
    imagePullPolicy: IfNotPresent
    ports:
    - name: web
      containerPort: 80
      protocol: TCP
root@master30 ~ 11:28:44# kubectl apply -f pod-without-quota.yaml
Error from server (Forbidden): error when creating "pod-without-quota.yaml": pods "web" is forbidden: failed quota: myquota: must specify limits.cpu for: web; limits.memory for: web; requests.cpu for: web; requests.memory for: web
# 清理环境
root@master30 ~ 11:28:55# kubectl delete resourcequotas myquota
resourcequota "myquota" deleted
测试 - Request
配额示例
root@master30 ~ 11:29:10# vim resourcequota.yaml
apiVersion: v1
kind: ResourceQuota
metadata:
  name: myquota
spec:
  hard:
    requests.cpu: 1000m
    requests.memory: "2048Mi"
root@master30 ~ 11:29:31# kubectl apply -f resourcequota.yaml
resourcequota/myquota created
pod 示例 1:资源请求超出命名空间配额上限
root@master30 ~ 11:29:39# vim pod-request-1.yaml
apiVersion: v1
kind: Pod
metadata:
  name: web
  labels:
    app: web
spec:
  containers:
  - name: web
    image: hub.laoma.cloud/library/httpd
    imagePullPolicy: IfNotPresent
    resources:
      requests:
        cpu: 2000m
        memory: 4096Mi
    ports:
    - name: web
      containerPort: 80
      protocol: TCP
root@master30 ~ 11:30:06# kubectl apply -f pod-request-1.yaml
Error from server (Forbidden): error when creating "pod-request-1.yaml": pods "web" is forbidden: exceeded quota: myquota, requested: requests.cpu=2,requests.memory=4Gi, used: requests.cpu=0,requests.memory=0, limited: requests.cpu=1,requests.memory=2Gi
pod 示例 2:资源请求未超出配额上限
root@master30 ~ 11:30:16# vim pod-request-2.yaml
apiVersion: v1
kind: Pod
metadata:
  name: web
  labels:
    app: web
spec:
  containers:
  - name: web
    image: hub.laoma.cloud/library/httpd
    imagePullPolicy: IfNotPresent
    resources:
      requests:
        cpu: 200m
        memory: 1024Mi
    ports:
    - name: web
      containerPort: 80
      protocol: TCP
root@master30 ~ 11:30:58# kubectl get pod
NAME   READY   STATUS    RESTARTS   AGE
web    1/1     Running   0          7s
# 验证配额占用情况
root@master30 ~ 11:31:05# kubectl describe resourcequotas myquota
Name:            myquota
Namespace:       quota
Resource         Used  Hard
--------         ----  ----
requests.cpu     200m  1
requests.memory  1Gi   2Gi
# 删除pod和配额资源
root@master30 ~ 11:31:16# kubectl delete pod web
pod "web" deleted
root@master30 ~ 11:31:27# kubectl delete resourcequotas myquota
resourcequota "myquota" deleted
测试 - Limits
压力测试镜像
可直接使用镜像 hub.laoma.cloud/progrium/stress 完成资源压力测试,镜像内置 stress 压力测试工具。
镜像文件可向讲师索取。
Usage: stress [OPTION [ARG]] ...
 -?, --help         show this help statement
     --version      show version statement
 -v, --verbose      be verbose
 -q, --quiet        be quiet
 -n, --dry-run      show what would have been done
 -t, --timeout N    timeout after N seconds
     --backoff N    wait factor of N microseconds before work starts
 -c, --cpu N        spawn N workers spinning on sqrt()
 -i, --io N         spawn N workers spinning on sync()
 -m, --vm N         spawn N workers spinning on malloc()/free()
     --vm-bytes B   malloc B bytes per vm worker (default is 256MB)
     --vm-stride B  touch a byte every B bytes (default is 4096)
     --vm-hang N    sleep N secs before free (default none, 0 is inf)
     --vm-keep      redirty memory instead of freeing and reallocating
 -d, --hdd N        spawn N workers spinning on write()/unlink()
     --hdd-bytes B  write B bytes per hdd worker (default is 1GB)
Example: stress --cpu 8 --io 4 --vm 2 --vm-bytes 128M --timeout 10s
Note: Numbers may be suffixed with s,m,h,d,y (time) or B,K,M,G (size).
常用参数说明:
-
-c, --cpu N:创建 N 个线程持续做浮点运算,占用 CPU 资源
-
-m, --vm N:创建 N 个线程循环申请、释放内存
--vm-bytes B:单个内存线程单次申请的内存容量(默认 256MB)
-
-d, --hdd N:创建 N 个线程持续读写磁盘文件
–hdd-bytes B:单次磁盘写入文件容量(默认 1GB)
使用示例:
# 内存压力测试
$ docker run --name stress hub.laoma.cloud/progrium/stress -m 1 --vm-bytes 512M
# CPU压力测试
$ docker run --name stress hub.laoma.cloud/progrium/stress -c 1
# IO磁盘压力测试
$ docker run --name stress hub.laoma.cloud/progrium/stress –d 1 --hdd-bytes 3G
适配 Pod 的部署配置:
apiVersion: v1
kind: Pod
metadata:
  name: stress
spec:
  containers:
  - name: stress
    image: hub.laoma.cloud/progrium/stress
    imagePullPolicy: IfNotPresent
    command: ['sh','-c','sleep 3600']
    # 也可省略command,通过args向镜像入口程序传递压力参数
    #args: ['-m','1','--vm-bytes','512M']
    #args: ['-c','1']
    #args: ['-d','1','--hdd-bytes','3G']
配额示例
root@master30 ~ 11:31:38# vim resourcequota.yaml
apiVersion: v1
kind: ResourceQuota
metadata:
  name: myquota
spec:
  hard:
    limits.cpu: 1000m
    limits.memory: "2048Mi"
root@master30 ~ 11:32:39# kubectl apply -f resourcequota.yaml
resourcequota/myquota created
测试 CPU 资源
pod 示例:
root@master30 ~ 11:32:45# vim pod-limit-cpu.yaml
apiVersion: v1
kind: Pod
metadata:
  name: stress
spec:
  containers:
  - name: stress
    image: hub.laoma.cloud/progrium/stress
    imagePullPolicy: IfNotPresent
    args: ['-c','1']
    resources:
      limits:
        cpu: 200m
        memory: "256Mi"
root@master30 ~ 11:33:18# kubectl apply -f pod-limit-cpu.yaml
pod/stress created
新开终端监控资源消耗
kubectl top 命令依赖提前部署 Metrics-Server 组件
root@master30 ~ 11:34:29# kubectl top pods
NAME     CPU(cores)   MEMORY(bytes)
stress   201m         0Mi
**观测结论:**容器 CPU 使用率稳定维持在 200m 上下,不会突破 limit 上限。
# 删除测试pod
root@master30 ~ 11:33:28# kubectl delete pod stress --force
Warning: Immediate deletion does not wait for confirmation that the running resource has been terminated. The resource may continue to run on the cluster indefinitely.
pod "stress" force deleted
测试 MEMORY 资源
pod 示例:
root@master30 ~ 11:35:10# vim pod-limit-memory.yaml
apiVersion: v1
kind: Pod
metadata:
  name: stress
spec:
  containers:
  - name: stress
    image: hub.laoma.cloud/progrium/stress
    imagePullPolicy: IfNotPresent
    args: ['-m','1','--vm-bytes','512M']
    resources:
      limits:
        cpu: 200m
        memory: "256Mi"
root@master30 ~ 11:35:39# kubectl apply -f pod-limit-memory.yaml
pod/stress created
新开终端实时观测 Pod 状态
root@master30 ~ 11:34:41# kubectl get pods -w
NAME     READY   STATUS      RESTARTS      AGE
stress   0/1     OOMKilled   1 (10s ago)   15s
stress   0/1     CrashLoopBackOff   1 (16s ago)   22s
stress   1/1     Running            2 (17s ago)   23s
stress   0/1     OOMKilled          2 (18s ago)   24s
stress   0/1     CrashLoopBackOff   2 (12s ago)   35s
**观测结论:**Pod 触发内存上限后状态变为 OOMKilled,控制器会持续重启容器,进入崩溃重启循环。
root@master30 ~ 11:35:49# kubectl delete pod stress --force
Warning: Immediate deletion does not wait for confirmation that the running resource has been terminated. The resource may continue to run on the cluster indefinitely.
pod "stress" force deleted
root@master30 ~ 11:36:50# kubectl delete resourcequotas myquota
resourcequota "myquota" deleted
总结
-
所有 Pod 的 limits 总和是否有可能超过节点总资源容量?
答案:存在该可能性。
举个实例:节点可用内存为 1G。
每个 Pod 配置内存 request=256M、limit=512M。节点最多调度 4 个 Pod(由 request 总量约束),但所有 Pod 的 limits 相加可达 2G,超过节点物理内存。
-
当全部 Pod 的 limits 总和超出节点资源总容量时,Kubernetes 会如何处理?
- CPU 资源:Kubernetes 将 CPU 归类为可压缩资源。容器占用达到 limit 上限后,内核会缩减该容器的 CPU 调度时间,但不会杀死容器进程。
- 内存资源:Kubernetes 将内存归类为不可压缩资源。内存资源紧张时(1.9 及以上版本),系统会终止超出自身 request 的容器。终止优先级:未配置 request 的容器最先被杀;其次是实际内存占用超出 request 更多的容器;同等占用情况下,Pod 优先级更低的容器优先终止。
LimitRange
Kubernetes 创建 Pod 时默认不会自动填充资源请求与资源上限参数。若命名空间已配置 ResourceQuota,未声明资源参数的 Pod 会被拒绝创建。为简化配额命名空间的 Pod 部署流程,可通过 LimitRange 为命名空间内容器配置资源参数的默认取值、上下限约束。
LimitRange(资源范围限制器)是独立资源对象,用于定义单个 Pod / 容器资源参数的默认值、最小值与最大值;Pod 整体资源配额为内部所有容器资源参数之和。
LimitRange 仅作用于指定命名空间。
命名空间配置 LimitRange 后,资源创建遵循以下规则:
-
若创建资源时未声明任何计算资源参数,系统会自动套用 LimitRange 中定义的默认参数生成资源。
-
若资源声明的 request 参数小于 LimitRange 规定的最小值,该资源创建请求会被拒绝。
-
若资源声明的 limit 参数大于 LimitRange 规定的最大值,该资源创建请求会被拒绝。
LimitRange 配置示例
root@master30 ~ 11:36:59# vim limits.yaml
apiVersion: v1
kind: LimitRange
metadata:
  name: mylimit
spec:
  limits:
    - type: Container
      max:
        memory: 1024Mi
        cpu: 1
      min:
        memory: 128Mi
        cpu: 100m
      default:
        memory: 512Mi
        cpu: 500m
      defaultRequest:
        memory: 256Mi
        cpu: 200m
字段说明:
-
name:命名规范仅允许小写字母、数字、短横线与小数点,首尾字符必须为字母或数字。 -
default:命名空间未声明 limit 时,容器自动使用的资源上限默认值 -
defaultRequest:命名空间未声明 request 时,容器自动使用的资源请求默认值 -
max:单容器可配置的资源参数最大值 -
min:单容器可配置的资源参数最小值参数约束关系:
== min <= defaultRequest <= default <= max
root@master30 ~ 11:37:38# kubectl apply -f limits.yaml
limitrange/mylimit created
root@master30 ~ 11:37:44# kubectl get limitranges
NAME      CREATED AT
mylimit   2026-08-13T03:37:44Z
root@master30 ~ 11:37:49# kubectl describe limitranges mylimit
Name:       mylimit
Namespace:  quota
Type        Resource  Min    Max  Default Request  Default Limit  Max Limit/Request Ratio
----        --------  ---    ---  ---------------  -------------  -----------------------
Container   memory    128Mi  1Gi  256Mi            512Mi          -
Container   cpu       100m   1    200m             500m           -
未指定 resources 参数
示例 1:Pod 完全不配置 resources
root@master30 ~ 11:37:56# vim pod-without-limits.yaml
apiVersion: v1
kind: Pod
metadata:
  name: stress
spec:
  containers:
  - name: stress
    image: hub.laoma.cloud/progrium/stress
    imagePullPolicy: IfNotPresent
    args: ['-c','1']
**观测结论:**创建完成后,Pod 会自动填充 LimitRange 定义的默认 request 与 limit 参数。
root@master30 ~ 11:38:21# kubectl apply -f pod-without-limits.yaml
pod/stress created
root@master30 ~ 11:39:01# kubectl top pod
NAME     CPU(cores)   MEMORY(bytes)
stress   501m         0Mi
oot@master30 ~ 11:38:48# kubectl get pod stress -o yaml
......
spec:
  containers:
    image: hub.laoma.cloud/progrium/stress
    imagePullPolicy: IfNotPresent
    name: stress
    resources:
      limits:
        cpu: 500m
        memory: 512Mi
      requests:
        cpu: 200m
        memory: 256Mi
......
# 清理测试资源
root@master30 ~ 11:39:18# kubectl delete limitranges mylimit
limitrange "mylimit" deleted
root@master30 ~ 11:39:46# kubectl delete pod web --force
Warning: Immediate deletion does not wait for confirmation that the running resource has been terminated. The resource may continue to run on the cluster indefinitely.
仅指定 limit 参数
示例 2-1:limit 值超过 LimitRange 最大值
apiVersion: v1
kind: Pod
metadata:
  name: web
spec:
  containers:
  - name: web
    image: hub.laoma.cloud/library/nginx
    resources:
      limits:
        cpu: 1.1
        memory: 1100Mi
root@master30 ~ 11:41:13# kubectl apply -f limits.yaml
pod/web created
Error from server (Forbidden): error when creating "limit.yml": pods "web" is forbidden: [maximum cpu usage per Container is 1, but limit is 1100m, maximum memory usage per Container is 1Gi, but limit is 1181116006400m]
示例 2-2:limit 值低于 LimitRange 最小值
apiVersion: v1
kind: Pod
metadata:
  name: web
spec:
  containers:
  - name: web
    image: hub.laoma.cloud/library/nginx
    resources:
      limits:
        cpu: 60m
        memory: 60Mi
root@master30 ~ 11:41:37# kubectl apply -f limits.yaml
pod/web configured
Error from server (Forbidden): error when creating "limit.yml": pods "web" is forbidden: [minimum cpu usage per Container is 100m, but request is 60m, minimum memory usage per Container is 128Mi, but request is 60Mi]
示例 2-3:limit 值介于 min 与 max 之间
apiVersion: v1
kind: Pod
metadata:
  name: web
spec:
  containers:
  - name: web
    image: hub.laoma.cloud/library/nginx
    resources:
      limits:
        cpu: 600m
        memory: 600Mi
观测结论:
-
容器显式配置的 limit 参数必须满足约束:min < limit < max
-
若仅配置 limit 未配置 request,系统会自动将 request 赋值为与 limit 相同的值,不会使用 defaultRequest 默认值。
root@master30 ~ 11:42:45# kubectl get pod web -o yaml
......
spec:
  containers:
  - image: hub.laoma.cloud/library/nginx
    imagePullPolicy: Always
    name: web
    resources:
      limits:
        cpu: 600m
        memory: 600Mi
      requests:
        cpu: 600m
        memory: 600Mi
......
仅指定 requests 参数
示例 3-1:requests 值超过 LimitRange 最大值
apiVersion: v1
kind: Pod
metadata:
  name: web
spec:
  containers:
  - name: web
    image: hub.laoma.cloud/library/nginx
    resources:
      requests:
        cpu: 1600m
        memory: 600Mi
root@master30 ~ 11:43:01# kubectl apply -f limits.yaml
The Pod "web" is invalid:
* spec.containers[0].resources.requests: Invalid value: "1600m": must be less than or equal to cpu limit
* spec.containers[0].resources.requests: Invalid value: "1600Mi": must be less than or equal to memory limit
示例 3-2:requests 值低于 LimitRange 最小值
apiVersion: v1
kind: Pod
metadata:
  name: web
spec:
  containers:
  - name: web
    image: hub.laoma.cloud/library/nginx
    resources:
      requests:
        cpu: 60m
        memory: 60Mi
root@master30 ~ 11:43:01# kubectl apply -f limits.yaml
Error from server (Forbidden): error when creating "limit.yml": pods "web" is forbidden: [minimum cpu usage per Container is 100m, but request is 60m, minimum memory usage per Container is 128Mi, but request is 60Mi]
示例 3-3:requests 值介于 min 与 max 之间
apiVersion: v1
kind: Pod
metadata:
  name: web
spec:
  containers:
  - name: web
    image: hub.laoma.cloud/library/nginx
    resources:
      requests:
        cpu: 400m
        memory: 400Mi
观测结论:
-
容器显式配置的 request 参数必须满足约束:min < request < max
-
若仅配置 request 未配置 limit,系统会自动填充 default 作为 limit 参数。
root@master30 ~ 11:43:03# kubectl get pod web -o yaml
......
spec:
  containers:
  - image: hub.laoma.cloud/library/nginx
    imagePullPolicy: Always
    name: web
    resources:
      limits:
        cpu: 500m
        memory: 512Mi
      requests:
        cpu: 400m
        memory: 400Mi
......
限定资源类型
LimitRange 支持对三类资源做范围约束:
| Type | Resource Name | 说明 |
|---|---|---|
| container | cpu、memory | 约束单个容器的 CPU、内存参数 |
| Pod | cpu、memory | 约束 Pod 内全部容器 CPU、内存参数总和 |
| PVC | storage | 约束单个持久卷声明可申请的存储容量大小 |
PVC 存储资源 LimitRange 配置示例:
apiVersion: v1
kind: LimitRange
metadata:
  name: storagelimits
spec:
  limits:
  - type: PersistentVolumeClaim
    max:
      storage: 2Gi
    min:
      storage: 1Gi
环境清理
root@master30 ~ 11:45:11#  kubectl delete ns quota
namespace "quota" deleted
Kubernetes Health Check
学习参考:配置存活、就绪和启动探针
环境准备
root@master30 ~ 13:33:01# kubectl create ns health
namespace/health created
root@master30 ~ 13:55:46# kubectl config set-context --current --namespace health
Context "kubernetes-admin@kubernetes" modified.
Health Check
应用程序会因各类异常进入不可用状态,例如临时网络中断、配置错误、程序内部死锁等问题。
kubelet 会通过**探针(probes)**周期性检测容器内应用健康状态,并根据检测结果判断是否需要重启容器。例如存活探针可识别应用死锁场景,通过重启 Pod 提升业务可用性,规避程序自身缺陷造成的服务停滞。
若无探针机制,可参考以下示例直观感受问题:
# 创建基础测试Pod
root@master30 ~ 13:55:53# kubectl run web --image=hub.laoma.cloud/library/httpd --image-pull-policy=IfNotPresent
pod/web created
root@master30 ~ 13:56:18# kubectl describe pod web |grep '^IP:'
IP:               10.224.133.106
root@master30 ~ 13:56:31# curl 10.224.133.106
<html><body><h1>It works!</h1></body></html>
# 删除服务首页文件,此时应用已无法正常提供页面,但Pod状态仍为Running
root@master30 ~ 13:56:42# kubectl exec web -- rm -f htdocs/index.html
# 访问验证页面异常
root@master30 ~ 13:57:14# curl 10.224.133.106
<!DOCTYPE HTML PUBLIC "-//W3C//DTD HTML 3.2 Final//EN">
<html>
 <head>
  <title>Index of /</title>
 </head>
 <body>
<h1>Index of /</h1>
<ul></ul>
</body></html>
root@master30 ~ 13:57:17# kubectl get pod
NAME   READY   STATUS    RESTARTS   AGE
web    1/1     Running   0          76s
# 清理测试资源
root@master30 ~ 13:57:24# kubectl delete pod web --force
Warning: Immediate deletion does not wait for confirmation that the running resource has been terminated. The resource may continue to run on the cluster indefinitely.
pod "web" force deleted
Probe Type
kubelet 会使用启动探针判断容器初始化是否完成。若配置启动探针,存活探针、就绪探针会等待启动探针检测成功后才开始执行,避免应用初始化阶段被误重启。针对启动耗时较长的容器,启动探针可适配更长的检测超时时间,防止应用未完成加载就被终止。
- LivenessProbe(存活探针):判断容器内应用是否持续正常运行。若存活探针检测失败,控制器会重启当前 Pod。
- ReadinessProbe(就绪探针):判断容器是否具备对外提供业务服务的能力。若检测失败,该 Pod 的 IP 会从 Service 后端端点列表中移除;即便容器进程正常运行,也不会接收负载均衡转发的业务请求。
- StartupProbe(启动探针):判断容器是否完成初始化流程。配置后其余两类探针会暂停执行,直至启动探针检测成功;若启动探针持续失败,Pod 会像存活探针异常一样被重启。适用于初始化耗时远高于稳态运行检测周期的场景,例如大数据缓存加载、数据库连接初始化。
Checking Methods
kubelet 提供四种容器健康检测实现方式:
- httpGet:向容器 IP、指定端口与路径发起 HTTP GET 请求;返回状态码 200~399 区间判定为健康。
- exec:在容器内部执行指定命令;命令退出码为 0 判定为健康。
- tcpSocket:尝试与容器指定端口建立 TCP 连接;连接可正常建立判定为健康,建立后立即断开连接也视为检测通过。
- grpc:基于 gRPC 发起健康检查 RPC 调用;服务返回 “SERVING” 状态判定为健康,要求业务服务实现 gRPC 健康检测规范。
HTTP Checks-httpGet
HTTP 检测依托 Web 接口返回状态码完成健康判定,200-399 响应码代表服务正常。适用于所有提供 HTTP 接口的业务应用。
livenessProbe
root@master30 ~ 13:57:36# vim deploy-httpGet-liveness.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: web
  name: web
spec:
  replicas: 1
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      containers:
      - image: hub.laoma.cloud/library/httpd
        imagePullPolicy: IfNotPresent
        name: httpd
        # 配置存活探针
        livenessProbe:
          failureThreshold: 3
          initialDelaySeconds: 5
          periodSeconds: 5
          successThreshold: 1
          timeoutSeconds: 10
          httpGet:
            path: /index.html
            # 填写应用对外服务端口
            port: 80
            # 指定请求协议,可选HTTP、HTTPS
            scheme: HTTP
探针通用参数说明:
- initialDelaySeconds:必填项。容器启动后延迟多久开始执行首次探针检测。
- timeoutSeconds:必填项。单次探针检测的超时阈值,超出时间则判定本次检测失败;默认值 1 秒,最小值 1 秒。
- periodSeconds:选填项。探针循环检测间隔;默认值 10 秒,最小值 1 秒。
- successThreshold:选填项。连续检测成功多少次后,标记容器恢复健康;默认值 1,最小值 1。
- failureThreshold:选填项。连续检测失败多少次后,判定容器异常并执行对应处理逻辑;默认值 3,最小值 1。
root@master30 ~ 13:58:05# kubectl apply -f deploy-httpGet-liveness.yaml
deployment.apps/web created
root@master30 ~ 13:58:20# kubectl get pod
NAME                   READY   STATUS    RESTARTS   AGE
web-7dfcbbb5df-8pmjm   1/1     Running   0          6s
root@master30 ~ 13:58:26# kubectl describe pod web-7dfcbbb5df-8pmjm |grep '^IP:'
IP:               10.224.133.91
# 删除首页文件,触发存活探针失败
root@master30 ~ 13:58:45# kubectl exec web-7dfcbbb5df-8pmjm -- bash -c 'rm htdocs/index.html'
# 持续观测Pod,RESTARTS重启计数会变为1
root@master30 ~ 13:59:18# kubectl get pod
NAME                   READY   STATUS    RESTARTS   AGE
web-7dfcbbb5df-8pmjm   1/1     Running   0          63s
# 容器终止等待时长由terminationGracePeriodSeconds控制,默认30秒
# 等待旧容器销毁、新容器重建完成后,页面恢复正常访问
root@master30 ~ 13:59:23# kubectl describe pod web-7dfcbbb5df-8pmjm |grep '^IP:'
IP:               10.224.133.91
root@master30 ~ 13:59:57# curl 10.224.133.91
<html><body><h1>It works!</h1></body></html>
# 清理部署资源
root@master30 ~ 14:00:08# kubectl delete deployments.apps web
deployment.apps "web" deleted
readinessProbe
root@master30 ~ 14:00:19# vim deploy-httpGet-readiness.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: web
  name: web
spec:
  replicas: 3
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      containers:
      - image: hub.laoma.cloud/library/httpd
        imagePullPolicy: IfNotPresent
        name: httpd
        # 配置就绪探针
        readinessProbe:
          failureThreshold: 3
          initialDelaySeconds: 5
          periodSeconds: 5
          successThreshold: 1
          timeoutSeconds: 10
          httpGet:
            path: /index.html
            port: 80
            scheme: HTTP
# 创建业务部署
root@master30 ~ 14:00:48# kubectl apply -f deploy-httpGet-readiness.yaml
deployment.apps/web created
root@master30 ~ 14:01:06# kubectl expose deployment web --port=80 --target-port=80
service/web exposed
root@master30 ~ 14:01:29# kubectl get svc
NAME   TYPE        CLUSTER-IP      EXTERNAL-IP   PORT(S)   AGE
web    ClusterIP   10.111.71.118   <none>        80/TCP    6s
root@master30 ~ 14:01:35# kubectl get pod
NAME                   READY   STATUS    RESTARTS   AGE
web-5d6964b9f5-hl2g5   1/1     Running   0          41s
web-5d6964b9f5-sknjw   1/1     Running   0          41s
web-5d6964b9f5-z4r2g   1/1     Running   0          41s
# 为三个Pod写入区分标识的首页内容
root@master30 ~ 14:01:47# for pod in $(kubectl get pods -o name|awk -F / '{print $2}'); do kubectl exec $pod -- bash -c "echo $pod > htdocs/index.html"; done
root@master30 ~ 14:02:03# for i in {1..90};do curl -s 10.111.71.118;done|sort |uniq -c
     30 web-5d6964b9f5-hl2g5
     30 web-5d6964b9f5-sknjw
     30 web-5d6964b9f5-z4r2g
root@master30 ~ 14:02:47# kubectl get endpoints web
NAME   ENDPOINTS                                             AGE
web    10.224.133.66:80,10.224.133.86:80,10.224.218.180:80   87s
# 删除其中一个Pod的首页文件,触发就绪探针检测失败
root@master30 ~ 14:02:56# kubectl exec -it web-5d6964b9f5-hl2g5 -- rm -f htdocs/index.html
# 异常Pod会从Service后端端点列表移除
root@master30 ~ 14:03:38# kubectl get endpoints web
NAME   ENDPOINTS                                             AGE
web    10.224.133.66:80,10.224.133.86:80,10.224.218.180:80   2m17s
root@master30 ~ 14:03:46# for i in {1..90};do curl -s 10.111.71.118;done|sort |uniq -c
     45 web-5d6964b9f5-sknjw
     45 web-5d6964b9f5-z4r2g
# 观测异常Pod状态:READY标记变为0,但不会触发重启
root@master30 ~ 14:04:10# kubectl get pod
NAME                   READY   STATUS    RESTARTS   AGE
web-5d6964b9f5-hl2g5   0/1     Running   0          3m11s
web-5d6964b9f5-sknjw   1/1     Running   0          3m11s
web-5d6964b9f5-z4r2g   1/1     Running   0          3m11s
# 清理部署资源
root@master30 ~ 14:04:17# kubectl delete deployments.apps web
deployment.apps "web" deleted
Execution Checks-exec
命令行检测会在容器内部执行指定 shell / 命令,命令正常退出(返回码 0)则判定容器健康。
示例 1:检测容器内置文件是否存在
root@master30 ~ 14:30:29# vim deploy-exec-liveness.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: web
  name: web
spec:
  replicas: 1
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      containers:
      - image: hub.laoma.cloud/library/httpd
        imagePullPolicy: IfNotPresent
        name: httpd
        # 配置exec类型存活探针
        livenessProbe:
          failureThreshold: 3
          initialDelaySeconds: 5
          periodSeconds: 5
          successThreshold: 1
          timeoutSeconds: 10
          exec:
            command:
            - cat
            - /usr/local/apache2/htdocs/index.html
# 创建部署
root@master30 ~ 14:30:53# kubectl apply -f deploy-exec-liveness.yaml
deployment.apps/web created
root@master30 ~ 14:31:24# kubectl get pods
NAME                   READY   STATUS    RESTARTS   AGE
web-546966967b-qg45z   1/1     Running   0          6s
# 删除首页文件,探针执行cat命令失败
root@master30 ~ 14:31:30# kubectl exec web-546966967b-qg45z -- bash -c 'rm htdocs/index.html'
'
# 观测Pod重启计数+1
root@master30 ~ 14:32:26# kubectl get pod
NAME                   READY   STATUS    RESTARTS     AGE
web-546966967b-qg45z   1/1     Running   1 (1s ago)   69s
示例 2:检测自定义健康标识文件
root@master30 ~ 14:32:33# kubectl run busybox --image=busybox --image-pull-policy=IfNotPresent -o yaml --dry-run=client > busybox.yml
root@master30 ~ 14:34:15# vim deploy-exec-busybox.yml
apiVersion: v1
kind: Pod
metadata:
  creationTimestamp: null
  labels:
    run: busybox
  name: busybox
spec:
  containers:
  - image: busybox
    imagePullPolicy: IfNotPresent
    name: busybox

    # 容器启动执行逻辑
    args:
    - /bin/sh
    - -c
    - touch /tmp/healthy; sleep 10; rm -rf /tmp/healthy; sleep 100

    # 配置exec存活探针,检测健康标识文件
    livenessProbe:
      failureThreshold: 3
      initialDelaySeconds: 5
      periodSeconds: 5
      successThreshold: 1
      timeoutSeconds: 10
      exec:
        command:
        - ls
        - /tmp/healthy
  dnsPolicy: ClusterFirst
  restartPolicy: Always
TCP Socket Checks-tcpSocket
TCP 端口检测由 kubelet 主动尝试与容器指定端口建立连接,连接成功即判定容器健康。适用于无 HTTP 接口的 TCP 长连接服务(如数据库、Redis 等)。
示例:TCP 端口检测实现存活探针
root@master30 ~ 14:34:47# vim deploy-tcpSocket-liveness.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: web
  name: web
spec:
  replicas: 1
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      containers:
      - image: hub.laoma.cloud/library/httpd
        imagePullPolicy: IfNotPresent
        name: httpd
        # 配置tcpSocket类型存活探针
        livenessProbe:
          failureThreshold: 3
          initialDelaySeconds: 5
          periodSeconds: 5
          successThreshold: 1
          timeoutSeconds: 10
          tcpSocket:
            port: 80
Health Check Case
水平扩容场景下的探针作用
多副本业务执行水平扩容时,新创建的副本会直接加入 Service 负载均衡后端参与流量分发。但应用启动存在预热周期,例如加载本地缓存、建立数据库连接等,容器进程就绪后并不能立刻处理业务请求。
通过就绪探针可精准判断副本是否完成初始化,避免负载均衡将流量转发至未就绪的新副本,减少业务报错。
滚动更新场景下的探针作用
滚动更新是探针机制另一核心应用场景。假设现有稳定运行的多副本业务,执行镜像版本更新时会触发以下流程:
- 正常场景下新副本初始化需要 10 秒,完成后才可处理业务;
- 异常场景:配置错误导致新副本始终无法完成初始化(例如数据库连接地址配置错误)。
若未配置探针机制,会产生什么风险?
由于新副本容器进程正常运行,无探针机制时集群会默认判定副本就绪,持续逐步替换旧副本。极端情况下所有旧副本被替换完毕后,全部新副本无法提供服务,业务完全中断,生产环境中会造成严重故障。
正确配置探针后,只有通过就绪探针检测的新副本才会接入 Service;若新副本持续检测失败,集群不会回收全部旧副本,原有业务流量可正常由旧副本承接,保障业务连续性。
环境清理
root@master30 ~ 14:44:04# kubectl delete ns health
namespace "health" deleted
Kubernetes 认证和授权
学习参考:API 访问控制
环境准备
root@master30 ~ 14:45:06# kubectl create ns auth
root@master30 ~ 14:45:28# kubectl config set-context --current --namespace auth
Kubernetes API 访问控制
学习参考:Kubernetes API 访问控制
当用户通过
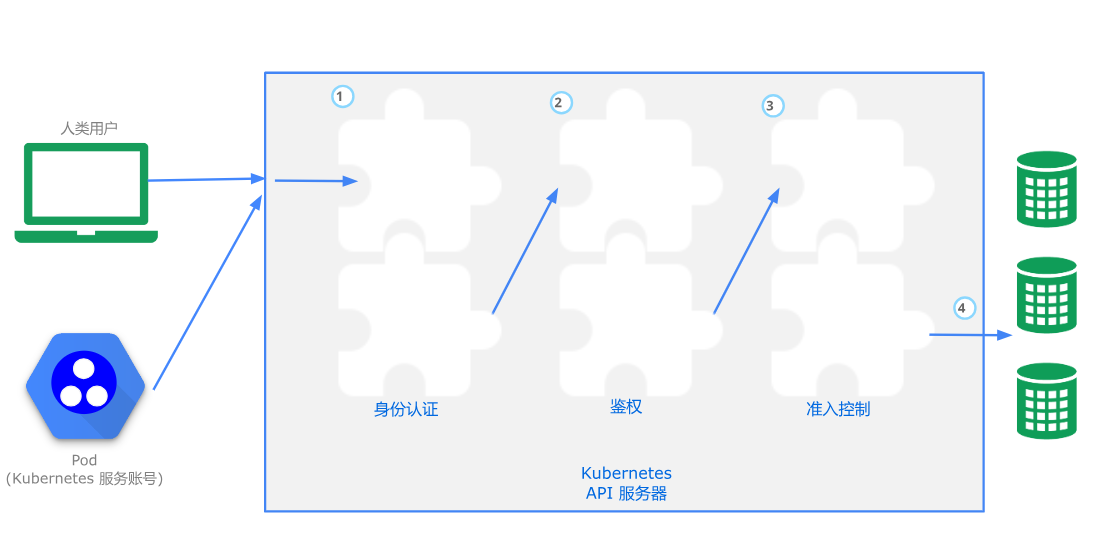
User身份或服务账号访问 Kubernetes API 时,每一次请求都会经过多道访问控制校验流程才会被处理,完整流程包含身份认证、鉴权以及准入控制(Admission Control)三个阶段。流程示意图如下:
传输安全
默认配置下,Kubernetes API 服务器会在本机首个非本地回环网卡的 6443 端口提供服务,通信全程受 TLS 加密保护。在标准生产集群环境中,API 服务通常对外暴露 443 端口。
端口可通过启动参数--secure-port自定义,监听 IP 地址则由--bind-address参数指定。
客户端发起 API 请求时,API 服务器会向客户端出示服务端证书。该证书可使用集群自建私有 CA 签发,也可采用公共可信 CA 体系签发。服务端证书与私钥文件通过--tls-cert-file和--tls-private-key-file两个启动参数配置。
若集群采用自建私有 CA,客户端~/.kube/config配置文件中必须写入该 CA 根证书,客户端才能信任 API 服务端,避免中间人劫持风险。
身份认证
对应流程图中步骤 ①:所有 Kubernetes 操作请求,第一步都会执行身份认证(Authentication)。
Kubernetes 依靠内置认证插件完成身份校验,支持的认证方式包含客户端证书、静态密码、普通令牌、集群引导令牌以及面向服务账号的 JSON Web 令牌(JWT)。当 API 服务同时启用多个认证插件时,会按配置顺序依次校验,任意一个插件校验通过即认定身份合法。
- 认证校验通过后,系统会提取请求用户名进入下一阶段鉴权流程。
- 若所有认证插件校验均失败,服务器将返回 HTTP 401 状态码拒绝本次请求。
身份认证组件的详细说明可查阅认证文档。
鉴权
对应流程图步骤 ②:完成身份认证、确定请求归属用户后,系统会对请求执行鉴权(Authorization)校验。鉴权校验需要获取三项核心信息:请求发起用户、待执行操作、操作目标资源对象。 若集群现有权限策略允许该用户执行对应操作,则鉴权通过。
示例说明:下述策略限定用户 Bob 仅能在projectCaribou命名空间内读取 Pod 资源。
{
    "apiVersion": "abac.authorization.kubernetes.io/v1beta1",
    "kind": "Policy",
    "spec": {
        "user": "bob",
        "namespace": "projectCaribou",
        "resource": "pods",
        "readonly": true
    }
}
- 若 Bob 发起读取
projectCaribou命名空间资源清单的请求,鉴权校验会放行该操作。
{
  "apiVersion": "authorization.k8s.io/v1beta1",
  "kind": "SubjectAccessReview",
  "spec": {
    "resourceAttributes": {
      "namespace": "projectCaribou",
      "verb": "get",
      "group": "unicorn.example.org",
      "resource": "pods"
    }
  }
}
- 若 Bob 尝试在
projectCaribou命名空间执行创建、更新等写入操作,或是在其他命名空间读取 Pod 资源,鉴权校验会直接拒绝请求。
注意事项:Kubernetes 鉴权体系采用标准 REST 属性设计,目的是兼容企业现有组织级、云厂商级外部访问控制系统。统一使用 REST 格式至关重要,能够保证鉴权策略同时适配 Kubernetes API 与第三方外部 API。
Kubernetes 支持多种鉴权插件,包含 ABAC、RBAC、Webhook 等类型,集群管理员部署时可在 API 服务配置文件中指定启用的鉴权插件。当配置多个鉴权插件时,系统会逐个校验;只要任意插件判定允许操作,请求即可继续流转;若全部插件均判定拒绝,则返回 HTTP 403 状态码拦截请求。
如需了解各类鉴权插件的使用方法、策略编写细则,可查阅鉴权官方文档。
准入控制
对应流程图中步骤 ③。
- 准入控制器仅作用于资源创建、修改、删除以及 Pod 代理连接类请求,仅读取资源的操作不会触发准入校验。集群配置多个准入控制器时,会按顺序逐个执行校验。准入控制器属于可修改、拦截请求的程序模块,除鉴权阶段可获取的请求属性外,还能读取待创建 / 修改资源的完整内容。
- 准入控制器与认证、鉴权模块逻辑存在明显区别:只要任意一个准入控制器拦截请求,整个流程会立刻终止并拒绝操作;除拦截请求外,准入控制器还能为资源字段设置标准化默认值。
- 当请求通过全部准入控制器校验后,系统会调用资源校验逻辑校验 API 对象合法性,校验无误后存入集群存储(流程图步骤 4)。
完整准入控制器列表及功能说明参考 准入控制器。
审计
Kubernetes 审计功能会生成按时间排序、与安全行为相关的操作日志,完整记录集群内全部操作行为。审计覆盖普通用户、调用 Kubernetes API 的应用程序以及控制平面组件产生的所有访问行为。
更多配置与使用细节参考 审计。
认证管理
学习参考:认证
Kubernetes 中的用户
Kubernetes 集群内分为两类用户主体:
-
普通用户:Kubernetes 本身不提供普通用户账号管理能力,账号体系由外部认证插件实现,
集群 API 不存在用于表征普通用户的内置资源对象
。无法通过 API 接口新增普通用户,Kubernetes 的身份判定逻辑为:
持有集群 CA 签发有效证书的访问者,视为身份认证通过的合法用户
。系统提取证书主题中的通用名称(Common Name,例如
/CN=bob)作为用户名,后续 RBAC 鉴权体系基于该用户名判定操作权限。 -
服务账号:服务账号是由 Kubernetes API 直接管理的内置用户主体,绑定至特定命名空间,可由 API 服务自动生成或通过 API 接口手动创建。每个服务账号对应一组存储在 Secret 内的访问凭证,凭证会自动挂载至对应 Pod 内部,供集群内程序调用 Kubernetes API。
所有 API 请求必须携带合法身份,归属普通用户或服务账号;客户端也可发起匿名请求。这意味着集群内外任意程序访问 API 服务器都必须完成身份认证,未携带合法凭证的请求会被归类为匿名用户。
身份认证策略
Kubernetes 通过认证插件校验 API 请求身份。当 HTTP 请求送达 API 服务器时,认证插件会为请求绑定以下身份属性:
- 用户名:用于唯一标识访问者的字符串,常见取值如
kube-admin、jane@example.com。 - 用户 ID:标识访问者的字符串,相比用户名具备更高稳定性与唯一性。
- 用户组:字符串数组,每一项代表访问者归属的逻辑用户分组,典型示例
system:masters、devops-team。 - 扩展字段:键值映射集合,键为字符串、值为字符串数组,用于存储鉴权插件可能用到的额外身份信息。
上述所有属性仅对认证系统透明无意义,属性的权限解读逻辑完全由鉴权组件实现。
集群可同时启用多种认证方式,生产环境标准配置至少包含两类:
- 面向 Pod 内服务账号的服务账号令牌认证。
- 面向运维人员的 X509 客户端证书认证。
Kubernetes 默认同时启用服务账号令牌与X509 客户端证书两种认证方式,本文档将重点讲解这两种方案。
认证插件
Kubernetes 支持并行启用多组认证插件,校验逻辑为任一插件通过即认定身份合法。认证成功后,用户名会传递至鉴权模块做权限校验;全部插件校验失败时,服务器返回 HTTP 401 拒绝请求。
主流认证插件说明:
-
X509 客户端证书
-
运维人员使用 kubectl 与集群交互时,
~/.kube/config配置文件默认采用 X509 证书完成身份校验。 -
API 服务器通过启动参数
--client-ca-file=SOMEFILE指定集群根证书文件。root@master30:~# cat /etc/kubernetes/manifests/kube-apiserver.yaml |\ grep -- --client-ca-file - --client-ca-file=/etc/kubernetes/pki/ca.crt
-
-
静态令牌文件
-
API 服务器通过启动参数
--token-auth-file=SOMEFILE开启该认证方式。root@master30:~# cat /etc/kubernetes/manifests/kube-apiserver.yaml |\ grep -- --token-auth-file -
文件采用 CSV 格式,每行至少包含三列:令牌、用户名、用户 ID。第四列为可选用户分组,多组名称需用双引号包裹,格式示例:
token,user,uid,"group1,group2,group3" -
集群默认未启用该认证方式。
-
-
集群引导令牌
-
为简化集群初始化、节点加入流程,Kubernetes 提供可动态管理的持有者令牌,即集群引导令牌(Bootstrap Token)。令牌以 Secret 资源形式存储在
kube-system命名空间,支持动态创建与回收。使用 kubeadm 部署、运维集群时,相关配置会自动完成。 -
需要在 API 服务器配置
--enable-bootstrap-token-auth启动参数开启引导令牌认证:root@master30:~# cat /etc/kubernetes/manifests/kube-apiserver.yaml |\ grep bootstrap - --enable-bootstrap-token-auth=true -
如需完整配置指南,查阅集群引导令牌官方文档。
-
-
服务账号令牌
- 服务账号是默认启用的认证机制,依靠签名持有者令牌校验 Pod 内部程序身份。
- 服务账号通常由 API 服务自动创建,并通过服务账号准入控制器自动关联至集群 Pod,令牌文件会挂载至 Pod 内固定路径,供容器进程访问 API 服务器。
- 也可在 Pod 资源清单中通过
serviceAccountName字段手动绑定指定服务账号。
-
Webhook 令牌身份认证
Webhook 认证属于回调校验机制,用于对接外部服务完成持有者令牌合法性校验。
-
身份认证代理
API 服务器支持从请求头(例如
X-Remote-User)提取用户身份信息,适用于前置统一身份代理的部署架构,由代理完成前置认证并写入请求头标识用户。 -
basic-auth-file 认证
Kubernetes 1.19 及后续版本已彻底移除
basic-auth-file基础密码认证方案。
匿名请求
若请求未通过任意已启用的认证插件校验,会被标记为匿名请求(Anonymous Requests)。匿名请求默认分配用户名system:anonymous,归属用户组system:unauthenticated。
- 1.5.1~1.5.x 版本:匿名访问默认关闭,可通过 API 启动参数
--anonymous-auth=true手动开启。 - 1.6 及以上版本:若集群鉴权模式不为
AlwaysAllow,匿名访问默认开启。从 1.6 版本开始,ABAC、RBAC 鉴权插件要求单独为system:anonymous用户、system:unauthenticated用户组配置独立权限规则;旧版本中匹配所有用户 / 分组的通配符权限策略,不再对匿名用户生效。
举例说明:集群启用令牌认证并开启匿名访问时,若请求携带无效令牌,服务器直接返回 401;若请求未携带任何令牌,则判定为匿名请求进入鉴权流程。
创建账户
本节讲解基于X509 客户端证书插件的普通用户全生命周期管理流程。
客户端准备
客户端主机需安装与集群版本匹配的 kubectl 工具,才能正常调用集群 API。
root@worker31 ~ 13:28:58# apt install -y kubectl=1.30.2-1.1
证书申请文件准备
# 生成用户私钥
root@worker31 ~ 15:31:44#  openssl genrsa -out liu.key 2048
# 基于私钥生成证书签发请求文件
root@worker31 ~ 15:31:56# openssl req -new -key liu.key -out liu.csr -subj '/CN=liu/O=kubernets'
# 参数说明:
## C,Country,代表国家
## ST,STate,代表省份
## L,Location,代表城市
## O,Organization,代表组织、企业主体
## OU,Organization Unit,代表部门
## CN,Common Name,通用名称,此处作为Kubernetes用户名
## emailAddress,代表联系人邮箱地址。
# 完整字段填写示例:
root@client:~# openssl req -new -key servera.key -out servera.csr -subj "/C=CHINA/ST=JS/L=NJ/O=LM/OU=DEVOPS/CN=servera.lab.example.com/emailAddress=laoma@lab.example.com"
# 客户端将证书签发请求文件发送至集群管理员(Master节点)
root@worker31 ~ 15:32:39# scp liu.csr root@master30:
Warning: Permanently added 'master30' (ED25519) to the list of known hosts.
liu.csr
创建用户凭据
集群管理员执行以下命令签发用户证书、生成客户端配置文件模板。
# 使用集群CA根证书与私钥签名用户请求文件,生成用户证书liu.crt,证书有效期1095天
root@master30 ~ 15:33:00# openssl x509 -req -in liu.csr -CA /etc/kubernetes/pki/ca.crt -CAkey /etc/kubernetes/pki/ca.key -CAcreateserial -out liu.crt -days 1095
Certificate request self-signature ok
subject=CN = liu, O = kubernets
# 导出集群现有kubeconfig作为配置模板
root@master30 ~ 15:34:29# kubectl config view > config.tpl
# 将配置模板、用户证书、集群CA根证书一并下发至客户端主机
root@master30 ~ 15:35:20# scp config.tpl liu.crt /etc/kubernetes/pki/ca.crt root@worker31:~
config.tpl                                                                            100%  453   584.1KB/s   00:00
liu.crt                                                                               100% 1013     1.7MB/s   00:00
ca.crt                                                                                100% 1107     1.9MB/s   00:00
创建 kubeconfig
-
方法:
通过
kubectl config系列命令自动生成(推荐)。修改模板文件 config.tpl,参考最终格式如下:
apiVersion: v1
clusters:
- cluster:
    server: https://10.1.8.30:6443
  name: kubernetes
contexts:
- context:
    cluster: kubernetes
    namespace: default
    user: liu
  name: liu@kubernetes
current-context: liu@kubernetes
kind: Config
users:
- name: liu
# 复制模板文件作为待编辑配置文件 root@worker31 ~ 15:48:29# cp config.tpl config root@worker31 ~ 15:48:41# kubectl config set-cluster kubernetes --kubeconfig=config --certificate-authority=ca.crt --embed-certs Cluster "kubernetes" set. # --kubeconfig 指定本次操作生效的kubeconfig文件 # --server 指定Kubernetes API服务访问地址 # --certificate-authority 指定集群CA根证书路径 # --embed-certs 参数作用:将ca.crt证书内容内嵌写入config文件; # 若不添加该参数,配置文件仅记录证书文件本地路径ca.crt # 配置用户身份凭证 root@worker31 ~ 15:48:52# kubectl config set-credentials liu --kubeconfig=config --client-key=liu.key --client-certificate=liu.crt --embed-certs User "liu" set. # --client-key 指定用户私钥文件路径 # --client-certificate 指定管理员签发的用户证书文件 # 配置上下文(集群+命名空间+用户绑定关系) root@worker31 ~ 15:49:21# kubectl config set-context liu --kubeconfig=config --namespace=default --cluster=kubernetes --user=liu Context "liu" created. # --namespace 指定默认操作命名空间 # --cluster 指定目标集群标识 # --user 指定绑定的用户身份 # 在Master节点为用户liu授予集群管理员完整权限,RBAC权限管理细节后续展开讲解 root@master30 ~ 15:35:25# kubectl create clusterrolebinding liu-admin --clusterrole=cluster-admin --user=liu clusterrolebinding.rbac.authorization.k8s.io/liu-admin created # 验证客户端配置可用性 root@worker31 ~ 15:52:44# kubectl get nodes --kubeconfig=config NAME STATUS ROLES AGE VERSION master30.liu.cloud Ready control-plane 8d v1.30.2 worker31.liu.cloud Ready <none> 8d v1.30.2 worker32.liu.cloud Ready <none> 8d v1.30.2 root@worker31 ~ 15:53:08# kubectl config get-contexts --kubeconfig=config CURRENT NAME CLUSTER AUTHINFO NAMESPACE liu kubernetes liu default * liu@kubernetes kubernetes liu default
删除账户
# 理论上删除用户证书即可作废账号;本实验保留该账号用于后续演示,暂不执行删除操作
# 注意:仅删除集群内CSR资源无法阻止用户访问集群
# 原理:X509证书身份校验逻辑独立于Kubernetes API资源,集群本身无法管控证书有效性
# 若需永久封禁用户登录,需从证书体系层面处理,例如将客户端证书加入CA黑名单
# 解绑用户集群管理员权限
root@worker31 ~ 15:53:34# kubectl delete clusterrolebindings.rbac.authorization.k8s.io liu-admin
# 验证权限回收效果
root@worker31 ~ 15:53:40# kubectl get nodes
Error from server (Forbidden): nodes is forbidden: User "liu" cannot list resource "nodes" in API group "" at the cluster scope
授权管理
学习参考:鉴权、使用 RBAC 鉴权
鉴权概述
Kubernetes API 服务器会对所有已通过身份认证的请求执行鉴权校验,系统读取全部权限策略匹配请求属性,判定操作放行或拦截。权限判定逻辑为默认拒绝,仅当存在匹配策略允许对应操作时,请求才可继续执行。
集群配置多组鉴权插件时,系统按顺序依次校验:
- 任意鉴权插件给出允许 / 拒绝结论,会立刻终止校验流程,采用该插件判定结果,不再执行后续插件。
- 若全部插件均无匹配策略,统一判定拒绝请求,服务器返回 HTTP 403 状态码。
鉴权模式
鉴权模式定义身份合法用户可执行的操作范围,通过 kube-apiserver 静态配置文件指定启用类型:
root@worker31 ~ 16:41:39# cat /etc/kubernetes/manifests/kube-apiserver.yaml |grep mode
    - --authorization-mode=Node,RBAC
本实验集群同时启用RBAC与Node两种鉴权模式。
集群支持的全部鉴权模式说明:
-
Node:节点专属鉴权模式,专门为 kubelet 组件分配权限,仅允许 kubelet 操作调度至本机的 Pod 资源。详细用法查阅节点鉴权文档。
-
ABAC:基于属性的访问控制,依靠组合用户、资源、环境等多维度属性编写权限策略,实现细粒度访问管控。完整指南参考 ABAC 模式。
-
RBAC
:基于角色的访问控制,是企业级集群主流权限方案,依托用户绑定角色实现权限统一管理。官方文档
RBAC 模式
包含完整配置教程。
- 启用后,RBAC 依托
rbac.authorization.k8s.ioAPI 组管理权限策略,所有权限规则可通过集群 API 动态增删改查。 - 启用 RBAC 鉴权的配置方式:API 服务器启动参数添加
--authorization-mode=RBAC。
- 启用后,RBAC 依托
-
Webhook:WebHook 本质是 HTTP 回调接口,API 服务器鉴权时发送 HTTP POST 请求至外部服务,由第三方系统返回权限判定结果。配置说明查阅 Webhook 模式。
-
AlwaysAllow:永久放行所有用户的全部操作请求,无任何权限拦截。
# 前文已回收用户liu的集群权限,此处临时切换鉴权模式为AlwaysAllow,测试权限放行效果 root@worker31 ~ 16:42:01:~# vim /etc/kubernetes/manifests/kube-apiserver.yaml ...... # 在spec.containers.command数组内修改鉴权参数 spec: containers: - command: - --authorization-mode=AlwaysAllow ...... # 修改完成后kube-apiserver Pod会自动重启,等待Pod状态恢复Running后重新验证 root@worker31 ~ 16:42:16# kubectl get nodes NAME STATUS ROLES AGE VERSION master30.liu.cloud Ready control-plane 12d v1.30.2 worker31.liu.cloud Ready <none> 12d v1.30.2 worker32.liu.cloud Ready <none> 12d v1.30.2 -
AlwaysDeny:永久拦截所有用户操作请求,集群管理员账号不受该模式限制。
role 管理
Kubernetes 采用角色封装权限集合,将一组操作权限绑定至角色,再把角色关联至用户;用户会自动继承绑定角色内定义的全部操作权限,简化权限批量管控。
角色分类
- role:命名空间级角色,权限范围仅限定单个命名空间内资源。将 Role 关联用户的资源称为rolebinding。
- clusterrole:集群级角色,权限覆盖全集群,可管控所有命名空间资源及集群级资源。将 ClusterRole 关联用户的资源称为clusterrolebinding。
集群内置多套预定义 ClusterRole 权限模板,其中 admin 角色包含完整资源操作权限,可通过命令查看完整权限清单:
root@worker31 ~ 16:42:28# kubectl describe clusterroles admin
Name:         admin
Labels:       kubernetes.io/bootstrapping=rbac-defaults
Annotations:  rbac.authorization.kubernetes.io/autoupdate: true
PolicyRule:
  Resources                                       Non-Resource URLs  Resource Names  Verbs
  ---------                                       -----------------  --------------  -----
  rolebindings.rbac.authorization.k8s.io          []                 []              [create delete deletecollection get list patch update watch]
  roles.rbac.authorization.k8s.io                 []                 []              [create delete deletecollection get list patch update watch]
  configmaps                                      []                 []              [create delete deletecollection patch update get list watch]
  endpoints                                       []                 []              [create delete deletecollection patch update get list watch]
......
输出字段释义:
-
Resources:资源类型名称,例如 Secret、Configmap、Pod 等。
-
Resource Names:限定权限生效的指定资源名称;若为空,代表权限作用于该类型全部资源。以 Secret 为例,此字段可填写单个 Secret 名称实现精准管控。
-
Non-Resource URLs:非资源类虚拟 URL,对应集群特殊管理接口,日常运维极少涉及。
-
Verbs:针对资源可执行的操作动作,包含 get、list、create、delete、update、edit、watch、exec 等,各动作功能说明如下:
-
get:获取单个指定资源详情,对应 API 路径示例
GET /api/v1/namespaces/{namespace}/pods/{podname}root@worker31 ~ 16:43:06# kubectl get pod -n kube-system Error from server (Forbidden): pods is forbidden: User "liu" cannot list resource "pods" in API group "" in the namespace "kube-system" root@worker31 ~ 16:43:21# kubectl get pod kube-proxy-8kp8w -n kube-system NAME READY STATUS RESTARTS AGE kube-proxy-8kp8w 1/1 Running 4 52d -
list:列出某一类资源的全部清单,对应 API 路径示例
GET /api/v1/namespaces/{namespace}/podsroot@worker31 ~ 16:43:39# kubectl get pod -n kube-system NAME READY STATUS RESTARTS AGE calico-kube-controllers-6dfcd885bf-lq4n5 1/1 Running 4 52d calico-node-44cf4 1/1 Running 4 52d calico-node-48sm4 1/1 Running 4 52d ..... root@worker31 ~ 16:44:01# kubectl get pod kube-proxy-8kp8w -n kube-system Error from server (Forbidden): pods "kube-proxy-8kp8w" is forbidden: User "liu" cannot get resource "pods" in API group "" in the namespace "kube-system"完整 API 接口文档参考:https://kubernetes.io/docs/reference/kubernetes-api/
-
创建 role
root@master30 ~ 16:44:30# kubectl create -h
Create a role with single rule.
Usage:
  kubectl create role NAME --verb=verb --resource=resource.group/subresource
[--resource-name=resourcename] [--dry-run=server|client|none] [options]
示例 1:授予用户在 default 命名空间读取 Pod 的全部只读权限(get、list、watch)
root@master30 ~ 16:45:02# kubectl create role pod-role --verb=get,list,watch --resource=pods -n default --dry-run=client -o yaml
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  creationTimestamp: null
  name: pod-role
  namespace: default
rules:
- apiGroups:
  - ""
  resources:
  - pods
  verbs:
  - get
  - list
  - watch
root@master30 ~ 16:46:03# kubectl create role pod-role --verb=get,list,watch --resource=pods -n default
role.rbac.authorization.k8s.io/pod-role created
root@master30 ~ 16:46:51# kubectl get roles pod-role -n default
NAME       CREATED AT
pod-role   2026-08-13T08:46:51Z
root@master30 ~ 16:47:12# kubectl describe roles pod-role -n default
Name:         pod-role
Labels:       <none>
Annotations:  <none>
PolicyRule:
  Resources  Non-Resource URLs  Resource Names  Verbs
  ---------  -----------------  --------------  -----
  pods       []                 []              [get list watch]
示例 2:仅允许读取 default 命名空间内两个指定 Pod 资源 readablepod、anotherpod
root@master30 ~ 16:47:33# kubectl create role pod-role --verb=get --resource=pods \
--resource-name=readablepod
--resource-name=anotherpod
role.rbac.authorization.k8s.io/pod-role created
示例 3:授予用户 default 命名空间内 ReplicaSet 只读权限
root@master30 ~ 16:48:22# kubectl create role foo --verb=get,list,watch --resource=replicasets
role.rbac.authorization.k8s.io/foo created
修改 role
# 为现有pod-role角色新增pod创建权限
root@master30 ~ 16:49:10# kubectl edit roles -n default pod-role
......
rules:
- apiGroups:
  - ""
  resources:
  - pods
  verbs:
# 在verbs数组内补充需要新增的操作权限
  - list
  - get
  - watch
  - create
apiGroups
- 角色权限规则
rules中的apiGroups默认取值为空字符串。 - Pod、Service 等基础资源 apiVersion 为 v1,对应 apiGroups 为
""。 - Deployment、DaemonSet 资源 apiVersion 为 apps/v1,对应 apiGroups 为
"apps",示例配置如下:
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  creationTimestamp: null
  name: deployments-role
  namespace: default
rules:
- apiGroups:
  - "apps"
  resources:
  - deployments
  verbs:
  - get
  - list
  - watch
**示例 1:**错误配置演示,因 apiGroups 未指定 apps,角色无法操作 Deployment 资源。
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  creationTimestamp: null
  name: deployments-role
  namespace: default
rules:
- apiGroups:
  - ""
  resources:
  - deployments
  verbs:
  - get
  - list
  - watch
**示例 2:**定义支持扩容 Deployment 的角色,需额外配置子资源 deployments/scale 与 patch 操作权限。
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  creationTimestamp: null
  name: deployments-role
  namespace: default
rules:
- apiGroups:
  - "apps"
  resources:
  - deployments
  # 扩容子资源
  - deployments/scale
  verbs:
  - get
  - list
  - watch
  # 允许修改扩容副本数
  - patch
**示例 3:**单角色配置多类资源差异化权限,同时管控 Pod 与 Deployment。
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  creationTimestamp: null
  name: all-role
  namespace: default
rules:
- apiGroups:
  - ""
  resources:
  - pods
  verbs:
  - get
  - list
  - watch
- apiGroups:
  - "apps"
  resources:
  - deployments
  - deployments/scale
  verbs:
  - get
  - list
  - watch
  - patch
常用资源 apiGroups 对照表
| 资源类型 | apiVersion | apiGroups |
|---|---|---|
| Pod、Service、PersistentVolume、PersistentVolumeClaim | v1 | “” |
| Deployment、DaemonSet、StatefulSets | apps/v1 | apps |
| Job | batch/v1 | batch |
| CronJob | batch/v1beta1 | batch |
| Role RoleBinding ClusterRole ClusterRoleBinding | rbac.authorization.k8s.io/v1 | rbac.authorization.k8s.io |
| NetworkPolicy | networking.k8s.io/v1 | networking.k8s.io |
查询任意资源对应 apiVersion 的命令:
root@master30 ~ 16:50:10# kubectl explain deployment|grep VERSION
VERSION:    v1
root@master30 ~ 16:50:35# kubectl explain networkpolicy|grep VERSION
VERSION:    v1
role 绑定
将命名空间级 Role 关联至指定用户,实现权限下发。
root@master30 ~ 16:51:28# kubectl create rolebinding deploy-pod-liu -n default --role=pod-role --user=liu --dry-run=client -o yaml
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  creationTimestamp: null
  name: deploy-pod-liu
  namespace: default
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: Role
  name: pod-role
subjects:
- apiGroup: rbac.authorization.k8s.io
  kind: User
  name: liu
# 将default命名空间的pod-role角色绑定至用户liu
root@master30 ~ 16:52:38# kubectl create rolebinding default-pod-liu -n default --role=pod-role --user=liu
rolebinding.rbac.authorization.k8s.io/default-pod-liu created
# 权限动态生效:修改Role内权限规则后,已绑定该角色的用户权限会实时同步更新。
root@master30 ~ 16:53:37# kubectl get rolebindings -n default default-pod-liu
NAME              ROLE            AGE
default-pod-liu   Role/pod-role   59s
root@master30 ~ 16:54:36# kubectl describe rolebindings -n default default-pod-liu
Name:         default-pod-liu
Labels:       <none>
Annotations:  <none>
Role:
  Kind:  Role
  Name:  pod-role
Subjects:
  Kind  Name  Namespace
  ----  ----  ---------
  User  liu

# 权限验证
root@worker31 ~ 16:44:33# kubectl run web --image=hub.laoma.cloud/library/httpd --image-pull-policy=IfNotPresent -n default
root@worker31 ~ 16:53:45# kubectl get pod -n default
NAME   READY   STATUS    RESTARTS   AGE
web    1/1     Running   0          2m30s
root@worker31 ~ 16:53:55# kubectl get pod -n default -w
NAME   READY   STATUS    RESTARTS   AGE
web    1/1     Running   0          2m42s
role 权限回收
root@master30 ~ 16:55:01# kubectl delete rolebindings default-pod-liu -n kube-system
rolebinding.rbac.authorization.k8s.io "default-pod-liu" deleted
# 回收后验证权限失效
root@worker31 ~ 16:56:02# kubectl get pod -n default
Error from server (Forbidden): pods is forbidden: User "liu" cannot list resource "pods" in API group "" in the namespace "default"
role 删除
root@master30 ~ 17:00:06# kubectl delete roles pod-role -n default
role.rbac.authorization.k8s.io "pod-role" deleted
更多推荐



 37
 0
- 0


 已为社区贡献15条内容

所有评论(0)