
大模型时代,人脸识别还有必要吗?GPT-4o视觉 vs 专用SDK
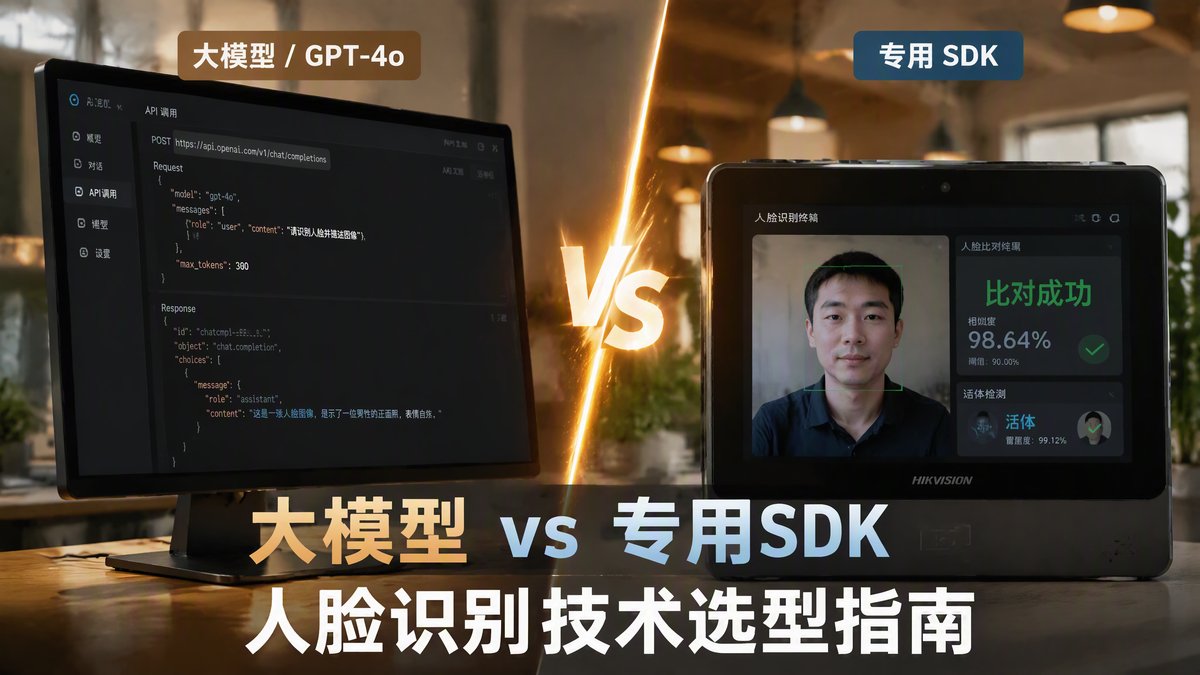
本文基于GPT-4o公开技术文档、百度人脸识别离线SDK官方资料及行业实测数据整理。涉及的技术原理和性能数据来自公开渠道,选型建议供开发者参考。
上个月,一个做智慧办公的创业公司找我聊技术选型。他们的产品经理挺兴奋:"我们用GPT-4o做了一套人脸门禁,直接拍张照片扔给API,它就能认出人是谁,还能描述这人在干什么。多模态才是未来啊。"
我当场问了三个问题:"你这套系统,单个人每次开门成本多少钱?如果断网了怎么办?如果我用高清照片骗它,它能分辨出来吗?"
产品经理愣了一下,说回去算笔账。三天后他告诉我,他们算错了——每次人脸识别要调一次GPT-4o的API,按图像分析收费,单月成本奔着五位数去了。更麻烦的是,API平均响应580毫秒,高峰期超过1秒,员工站在门口等门开的体验很差。
这不是GPT-4o的问题。它是当前最强的多模态大模型之一,在图像理解、语义分析、跨模态推理上确实远超传统方案。问题是:人脸识别这个场景,需要的不是"看懂照片",而是"在100毫秒内、离线状态下、以万分之一误识率、防住各种攻击手段,确认这个人就是本人"。
这两个目标,本质上是不一样的。
一、GPT-4o做视觉,到底强在哪
先说清楚大模型的优势,免得有人以为我在黑它。
优势一:零样本理解能力
传统人脸识别SDK,人脸库得提前录入、特征提取、建索引。来了新人,得先拍照片注册。
GPT-4o不需要。你扔一张聚会照片给它,它直接告诉你"左边穿红衣服的是张三,他在笑,右手举着酒杯"——它从来没见过张三,但通过语义关联和跨模态推理,能把人和名字对上。这种零样本理解能力,学术界已经有不少研究在探索,比如用自然语言描述面部特征("方形下巴""深色眼窝")来实现跨模态匹配,大模型在这类任务上确实展现出传统CV方法不具备的灵活性。
这在某些场景下是革命性的。比如找一个失踪儿童,传统SDK得先有这个孩子的注册照片;大模型可以直接理解"10岁左右、圆脸、左眉有痣"这种描述,从海量照片里筛出目标。
优势二:语义级图像理解
传统SDK只能告诉你"这是张三,相似度0.92"。GPT-4o能告诉你"这是张三,他看起来很累,背景是在一个会议室里,光线偏暗,可能是在开夜会"。
这种语义理解能力,在安防分析、用户行为洞察、智能客服等场景里,是传统CV算法完全做不到的。
优势三:多模态融合推理
GPT-4o能同时处理文本、图像、音频。你可以问它:"这张门禁照片里的人是不是在打电话?他是不是在跟别人一起进门?"——它能把视觉信息和上下文逻辑结合起来判断。
传统SDK只能做人脸1:1或1:N比对,没法做这种跨模态的复杂推理。
二、但为什么它不适合做身份认证
GPT-4o的优势列完了。但落到真实的身份认证项目里,有五个地方它暂时还扛不住。
硬伤一:实时性不够
GPT-4o的API平均响应时间在580毫秒左右(2026年4月实测数据,来源:CSDN公开测试),高峰期超过1秒。这还没算网络传输、图片上传、结果解析的时间。
人脸识别SDK呢?本地运行在设备上,从摄像头抓帧到返回结果,整个链路可以控制在50-100毫秒。员工走到门前,门已经开了;用GPT-4o,员工得站在门口等半秒,体验完全不是一个级别。
更关键的是,API调用依赖网络。电梯里、地下车库、偏远厂区——没网的时候,GPT-4o直接罢工。而离线SDK不依赖任何网络,本地芯片就能跑。
硬伤二:成本高得离谱
按2026年4月后OpenAI调整后的定价,GPT-4o的文本输入每千token约$0.0025,输出每千token约$0.01。图像分析按分辨率收费,低分辨率模式大约折算为$0.01-0.02每张。如果你每次调用包含1张图片+100 token文本输入+100 token输出,单次成本约$0.015-0.025。
算一笔账:一个1000人的公司,每天每人进出2次,一个月工作日22天,总调用次数 = 1000 × 2 × 22 = 44,000次。按每次$0.02算,月成本约880美元,折合人民币6300元。
而专用SDK呢?百度人脸离线SDK标准版授权费119元/个(50-1000台规模),买断制,永久有效。1000台设备一次性投入11.9万元,摊到3年,每月成本约3300元——而且这是买断,不是按月付费。
如果设备量更大(5000台),SDK单价降到79元/个,总成本3.95万元。用GPT-4o呢?5000人公司月调用22万次,成本约4400美元,折合人民币3.16万元——每月。
三年总成本对比:SDK约4-12万元(一次性),GPT-4o约114万元(按月累积)。这还没算网络带宽、服务器运维、API限流处理等隐性成本。
硬伤三:隐私合规风险
身份认证场景涉及人脸数据,国内有《个人信息保护法》、欧盟有GDPR,都对生物特征数据的存储和传输有严格限制。
用GPT-4o意味着:员工的人脸照片要上传到OpenAI的服务器(或国内中转节点),数据出境风险、第三方存储风险、审计追溯困难——这些在等保三级、金融合规场景里都是致命的。
离线SDK的人脸数据从不出设备,特征提取、比对、活体检测全在本地完成。银行、政务、 prisons 等敏感场景,这是硬性要求。
硬伤四:精度不够可控
GPT-4o是通用模型,不是专门为人脸识别训练的。它"认识"张三是基于语义关联和统计推断,而不是基于严格的人脸特征向量比对。
专用SDK呢?百度人脸离线SDK的误识率可以做到万分之一(阈值0.8),金融场景建议调到0.85,误识率进一步降低。这个精度是经过BCTC(银行卡检测中心)增强级认证的,活体检测通过率99.99%+。
GPT-4o没有这种精确可控的阈值机制。它说"这是张三",置信度是多少?不同光照、角度、表情下稳定性如何?没有人脸识别SDK那种工程化的精度保证。
硬伤五:防攻击能力空白
身份认证最大的敌人不是"认不出",而是"被冒充"。照片攻击、屏幕翻拍、3D面具、深度伪造视频——这些攻击手段,专用SDK有三模态活体检测来防御(RGB可见光、NIR近红外、Depth深度图)。
GPT-4o目前没有任何活体检测能力。你拿一张高清照片给它,它大概率会告诉你"这是张三本人"。因为它的训练数据里,照片和真人没有被区分标注,它不具备"判断眼前是真人还是图像"的意识。
三、同一张照片,两种处理方式
为了更直观地说明差异,我模拟了一个场景:员工站在门禁摄像头前,系统需要判断"他是不是本人"以及"他是不是真人"。
| 处理环节 | GPT-4o方案 | 专用SDK方案(以百度为例) |
|---|---|---|
| 人脸检测 | 通用目标检测,能框出人脸但优化不足 | 专用模型,支持侧脸、遮挡、暗光等复杂场景 |
| 特征提取 | 通用视觉编码器,非针对人脸优化 | 针对人脸结构优化的专用低维向量 |
| 1:N比对 | 无专用索引结构,遍历比对,耗时不可控 | Faiss等专用索引,万人库<100ms |
| 活体检测 | 不具备,照片/视频/屏幕无法区分 | RGB+NIR+Depth三模态,BCTC增强级认证 |
| 响应时间 | 580ms-2000ms(含网络传输) | 50-100ms(纯本地) |
| 单次成本 | 约$0.015-0.025 | 买断制,边际成本趋近于0 |
| 离线可用 | ❌ 必须联网 | ✅ 纯本地运行 |
| 数据隐私 | 人脸数据上传第三方服务器 | 数据从不出设备 |
| 额外价值 | 能描述场景、分析行为、语义推理 | 只能输出"是谁"和"是不是真人" |
这张表很清晰地说明了问题:GPT-4o和专用SDK,不是"谁更好"的关系,是"各自负责不同环节"的关系。
四、场景决策矩阵:什么场景选什么方案
基于上面的分析,我整理了一个决策框架。这不是标准答案,是我过去一年交付多个项目后的经验判断。
场景一:门禁考勤(选专用SDK)
要求:毫秒级响应、离线运行、活体检测、成本控制
理由:员工每天进出多次,对延迟极度敏感;断网不能停摆;活体检测是刚需;设备量大,API模式成本不可承受。
场景二:金融核身(选专用SDK)
要求:精度可控、活体检测、合规认证、数据不出域
理由:等保三级、BCTC认证、数据本地化——这些都是硬门槛。大模型目前无法满足金融监管要求。
场景三:智慧园区访客管理(混合架构)
要求:快速通行 + 访客语义分析
架构:SDK负责1:N身份识别(本地、毫秒级),大模型负责访客行为分析("这个人是不是在尾随""他是不是在拍照")。
场景四:公安找人/失踪人口(选大模型)
要求:跨年龄识别、语义描述匹配、海量照片筛选
理由:没有注册照片,SDK没法比对。大模型可以通过自然语言描述("10岁、圆脸、左眉有痣")在海量监控里筛目标,这是它的强项。
场景五:智能客服/用户画像(选大模型)
要求:理解用户情绪、分析用户行为、生成语义报告
理由:不需要精确到"这是张三本人",只需要"这个人看起来焦虑、可能遇到了问题"。大模型的语义理解能力远超SDK。
| 场景 | 推荐方案 | 核心原因 |
|---|---|---|
| 门禁/考勤 | 专用SDK | 实时、离线、低成本、防攻击 |
| 金融核身 | 专用SDK | 合规、精度可控、数据不出域 |
| 访客管理 | 混合架构 | SDK管身份,大模型管行为分析 |
| 公安找人 | 大模型 | 零样本、语义匹配、海量筛选 |
| 智能客服 | 大模型 | 语义理解、情绪分析、报告生成 |
五、混合架构设计:让它们各干各的
实际上,最合理的方案不是二选一,而是让它们在各自擅长的环节发力。
架构设计:端-边-云三级协同
端(设备层):SDK负责核心识别
- 人脸检测、活体检测、1:N比对:全部本地完成,<100ms响应
- 数据不出设备,通过TSL/SSL加密传输比对结果(仅传输ID,不传输人脸照片)
- 异常场景(活体检测失败、比对分数过低)触发二次校验
边(网关层):规则引擎负责策略调度
- 判断是否需要调用大模型:VIP客户来访、异常行为 detected、需要语义分析
- 控制调用频率:大模型API成本高,不能每帧都调
- 缓存常用结果:同一个人一天内多次进出,不需要每次都调大模型
云(服务端):大模型负责高阶分析
- 访客行为分析:"这个人是不是在园区里迷路了""他是不是在跟陌生人长时间交谈"
- 安全事件研判:结合多路摄像头画面,判断是否存在尾随、翻墙、聚集
- 日报生成:自动输出"今日访客统计、异常事件汇总、风险预警"
这套架构的核心思路是:能用SDK解决的事,绝不用大模型;大模型只处理SDK搞不定的语义级问题。
成本对比:纯大模型方案月调用成本约3万元(5000人规模),混合架构中大模型只承担5%的高阶分析调用,月成本降到1500元以内。
六、未来趋势:不是替代,是互补
最近技术圈里有个说法挺常见:"大模型会吞噬所有专用模型"。我的看法相反——至少在计算机视觉领域,这事不会发生。
大模型的进化方向是"通用性"——它要能理解一切、推理一切。但专用模型的进化方向是"极致性"——在特定场景里把精度、速度、成本做到极致。
这两个方向并不矛盾,就像汽车和马车的关系:汽车没有替代马车的全部功能,但在长途运输上彻底碾压马车;马车在崎岖山路、仪式感场景里,依然有自己的位置。
具体到人脸识别:
- 大模型会接管"语义理解"层:这个人是谁、他在干什么、他的情绪状态
- 专用SDK会守住"身份认证"层:他是不是本人、是不是真人、能不能通过
- 两者的接口会越来越标准化:SDK输出结构化数据(ID、置信度、活体状态),大模型消费这些数据做语义分析
学术界也有不少研究在探索这个方向:用大语言模型的零样本能力作为传统人脸识别的"增强器",在注册样本不足、跨年龄匹配等场景下提供补充判断。但核心身份认证的精度和安全,还是要靠专用模型来保障。
七、开发者自检清单
如果你正在做技术选型,以下清单帮你快速判断该走哪条路:
□ 你的场景是否要求200ms以内的响应时间?如果是,必须选SDK
□ 你的设备是否需要在断网状态下工作?如果是,必须选SDK
□ 你的人脸数据是否有合规不出域要求?如果是,必须选SDK
□ 你的月调用量是否超过1万次?如果是,SDK成本优势明显
□ 你的场景是否需要活体检测/防攻击?如果是,必须选SDK
□ 你的需求是否涉及语义理解/行为分析?如果是,大模型更合适
□ 你是否没有注册照片,需要通过描述找人?如果是,大模型更合适
□ 你的预算是否足够承受每月数千到数万元的API费用?如果不能,选SDK
如果你的勾选前5项居多,选专用SDK;勾选后3项居多,选大模型;两项都很多,考虑混合架构。
写在最后
回到开头那个创业公司的故事。他们最终选择了混合架构:门禁身份识别用百度人脸离线SDK(本地、毫秒级、活体检测),访客行为分析用GPT-4o(云端、语义级、日报生成)。
产品上线后,老板问了一个很有意思的问题:"既然大模型这么强,为什么还要花精力集成SDK?直接全部用大模型不好吗?"
技术负责人的回答我觉得挺有道理:"用大模型做人脸识别,就像用瑞士军刀切菜——它能切,但刀工不如专用菜刀,而且贵。瑞士军刀的价值在于你出门徒步时,一把刀能开瓶、能锯木、能剪线;但厨房里,你还是需要菜刀、剪刀、削皮器各司其职。"
大模型是瑞士军刀,专用SDK是厨房刀具。没有谁会替代谁,关键是看你在什么场景下做饭。
你在做人脸识别项目时,有没有遇到过"大模型 vs 专用SDK"的选型纠结?最后选了什么方案,踩过什么坑?欢迎在评论区留言交流。
系列文章导航
第一篇:百度人脸离线识别SDK集成指南(一):从零开始跑通Android Demo
第二篇:百度人脸离线识别SDK进阶优化(二):性能调优与稳定性提升
第三篇:百度人脸离线SDK实战(三):门禁系统从零搭建完整方案
第四篇:百度人脸离线SDK多场景适配方案(四):门禁/考勤/支付全覆盖
第五篇:百度人脸离线SDK生产环境踩坑汇总:从授权失效到多线程崩溃,这一篇全搞定
第六篇:百度人脸离线SDK大规模人脸库压测:1万到5万,到底扛不扛得住?
第七篇:百度人脸离线SDK规模化部署指南:从10台到1000台的运维实战
第八篇:百度人脸识别SDK信创版实测:鸿蒙/麒麟/统信三大国产系统适配全记录
第九篇:智能硬件厂商选型实录:百度人脸离线SDK的5个真实使用场景
第十篇:百度人脸SDK三模态活体防御实测:6种攻击手段全记录
第十一篇:智慧校园人脸识别落地方案:电子班牌、门禁、智慧食堂,离线SDK怎么选怎么搭
第十二篇:金融行业人脸核身方案:合规要求+技术实现+避坑清单
第十三篇:2026年人脸识别SDK横评:百度/阿里/腾讯/商汤,开发者该选谁
第十四篇:AI换脸诈骗频发,人脸SDK怎么防?深度伪造检测技术解析
技术数据及事实性描述已核对至公开来源(截至2026年8月),价格与性能参数可能随厂商政策调整,如果你在做活体检测方案选型,评论区聊聊你的场景和安全等级要求。
更多推荐


 23
 0
- 0


 已为社区贡献2条内容

所有评论(0)