
微服务部署架构探讨:Nginx + Java + Python Agent + 消息队列的可用性设计
实验室里的原型部署在单机上或许运行平稳,但生产环境的流量具有不确定性。请求量可能在某个时刻迅速攀升,给系统带来显著压力。
本文将分析一套微服务部署架构——看 Nginx、Java 业务层、Python Agent 执行引擎与消息队列如何高效协作,构建出兼具稳定性与扩展能力的智能系统。
接入与调度:Nginx
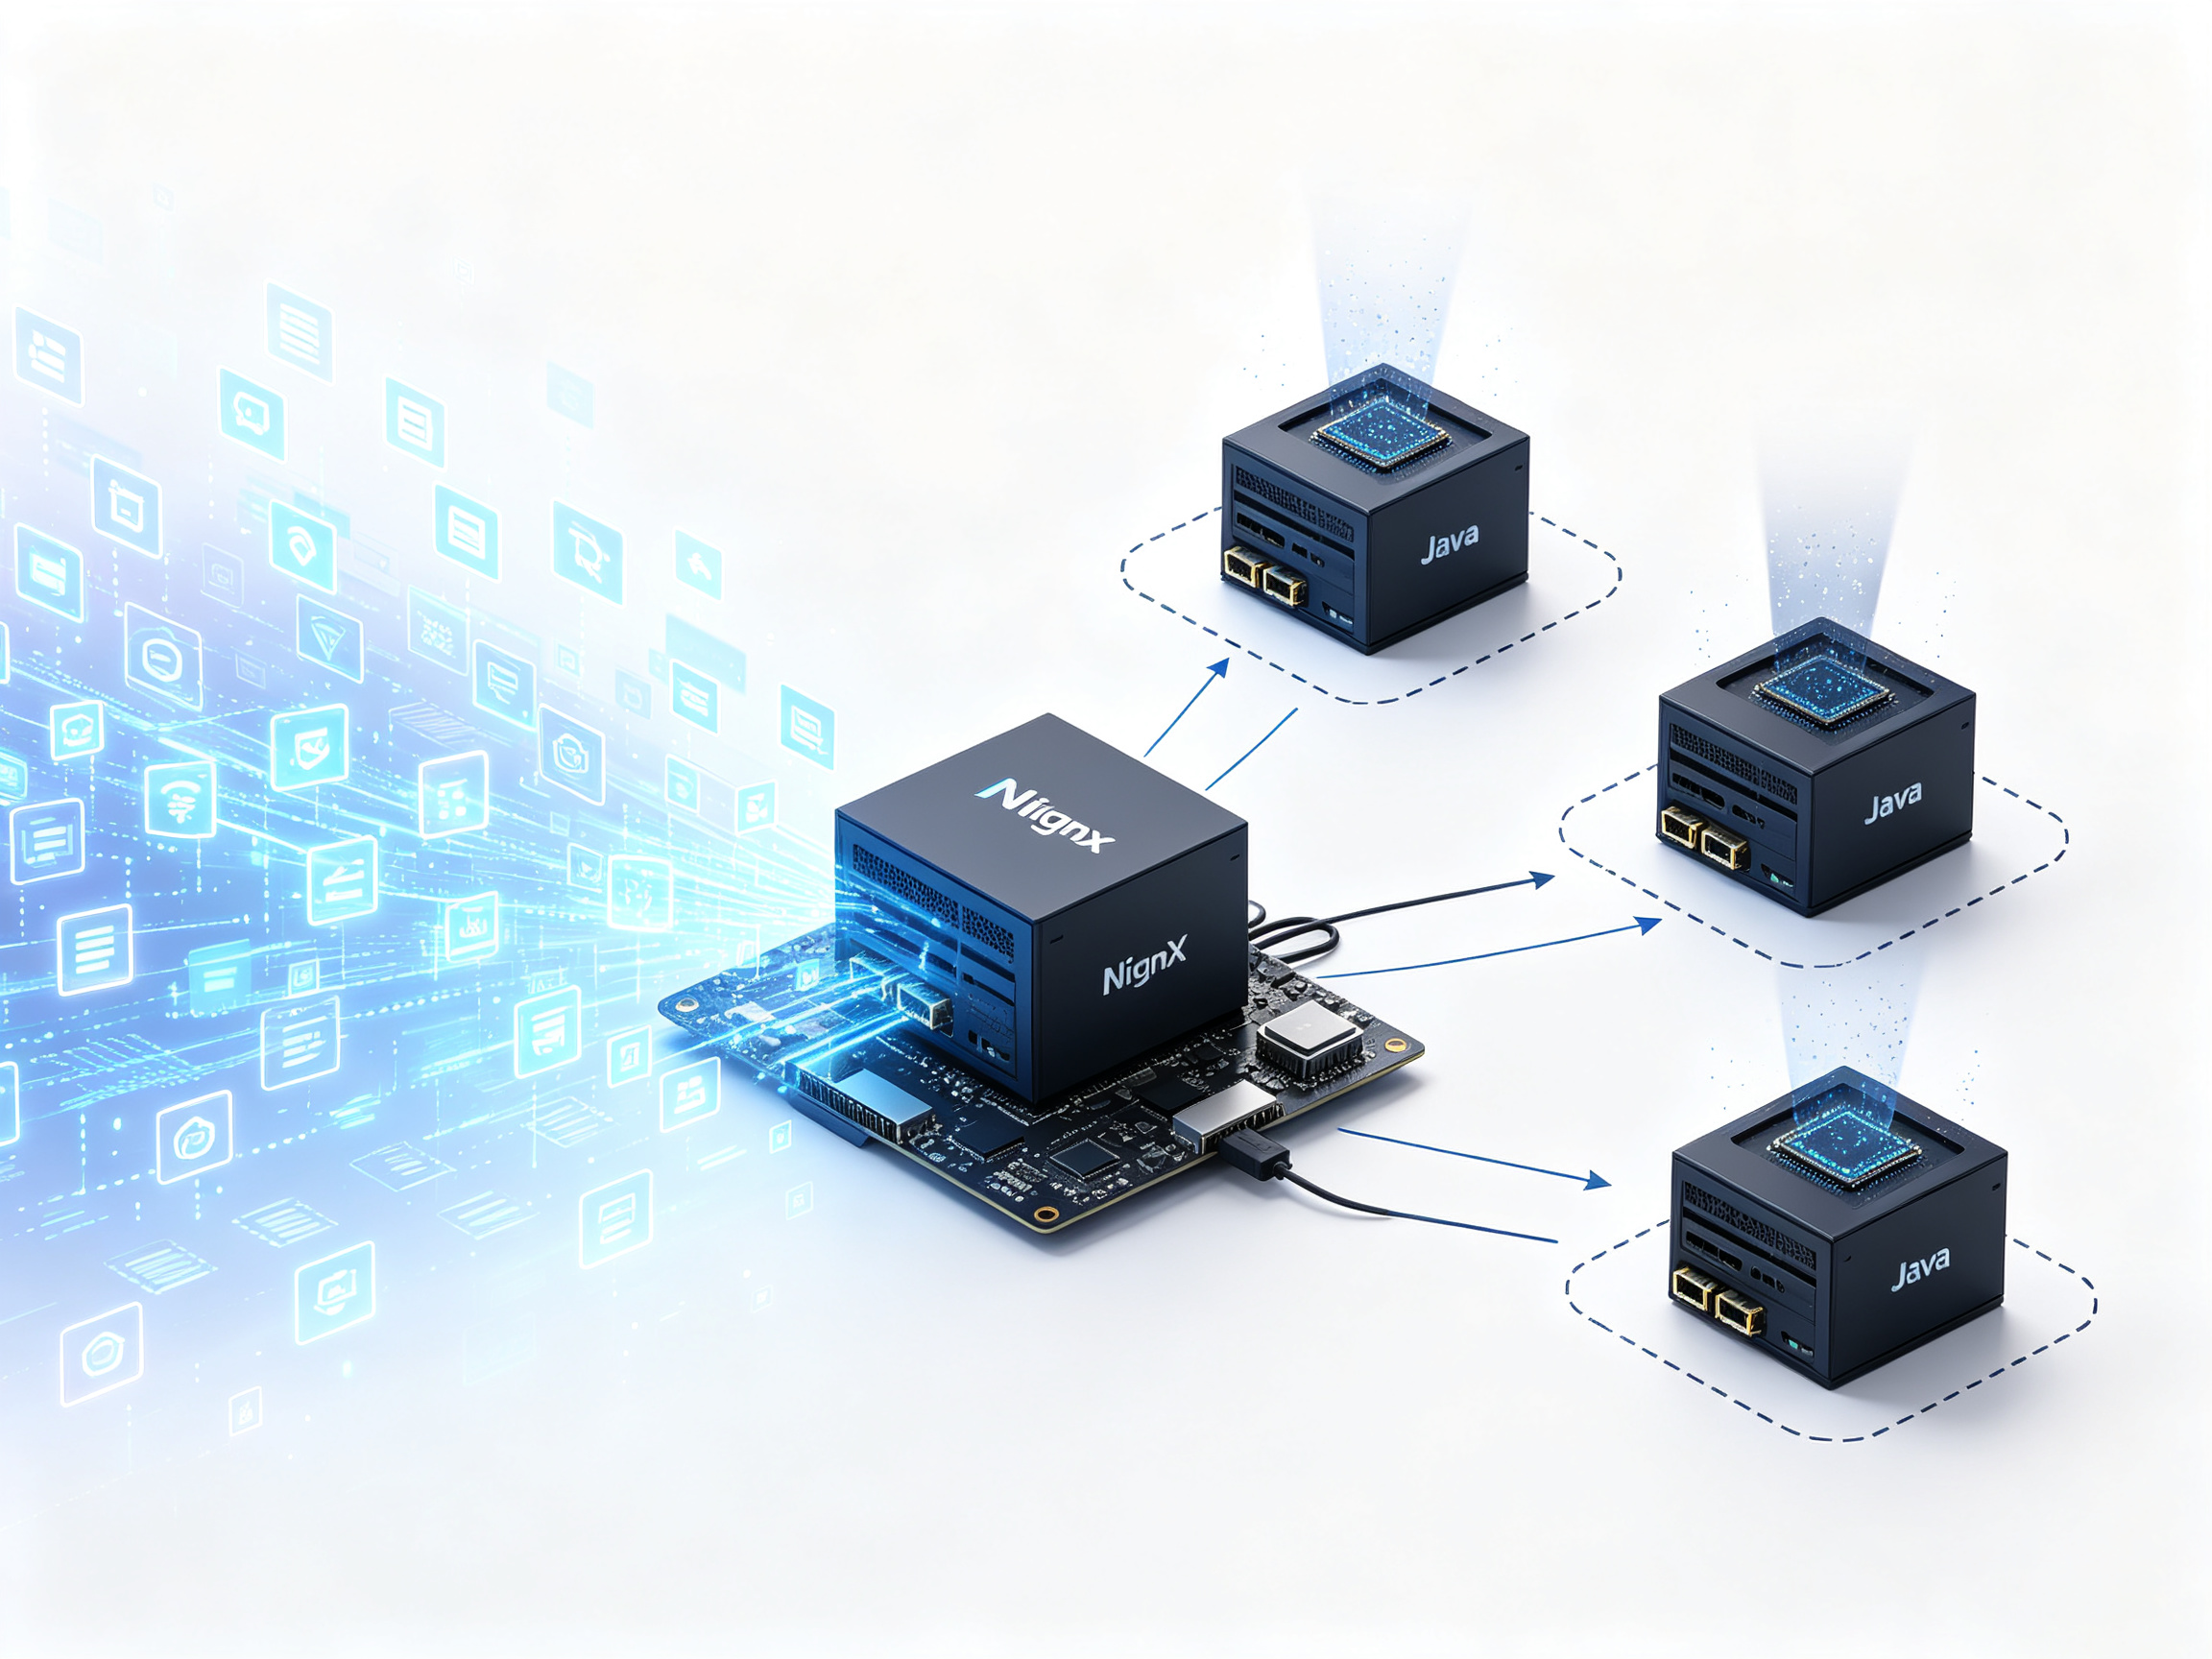
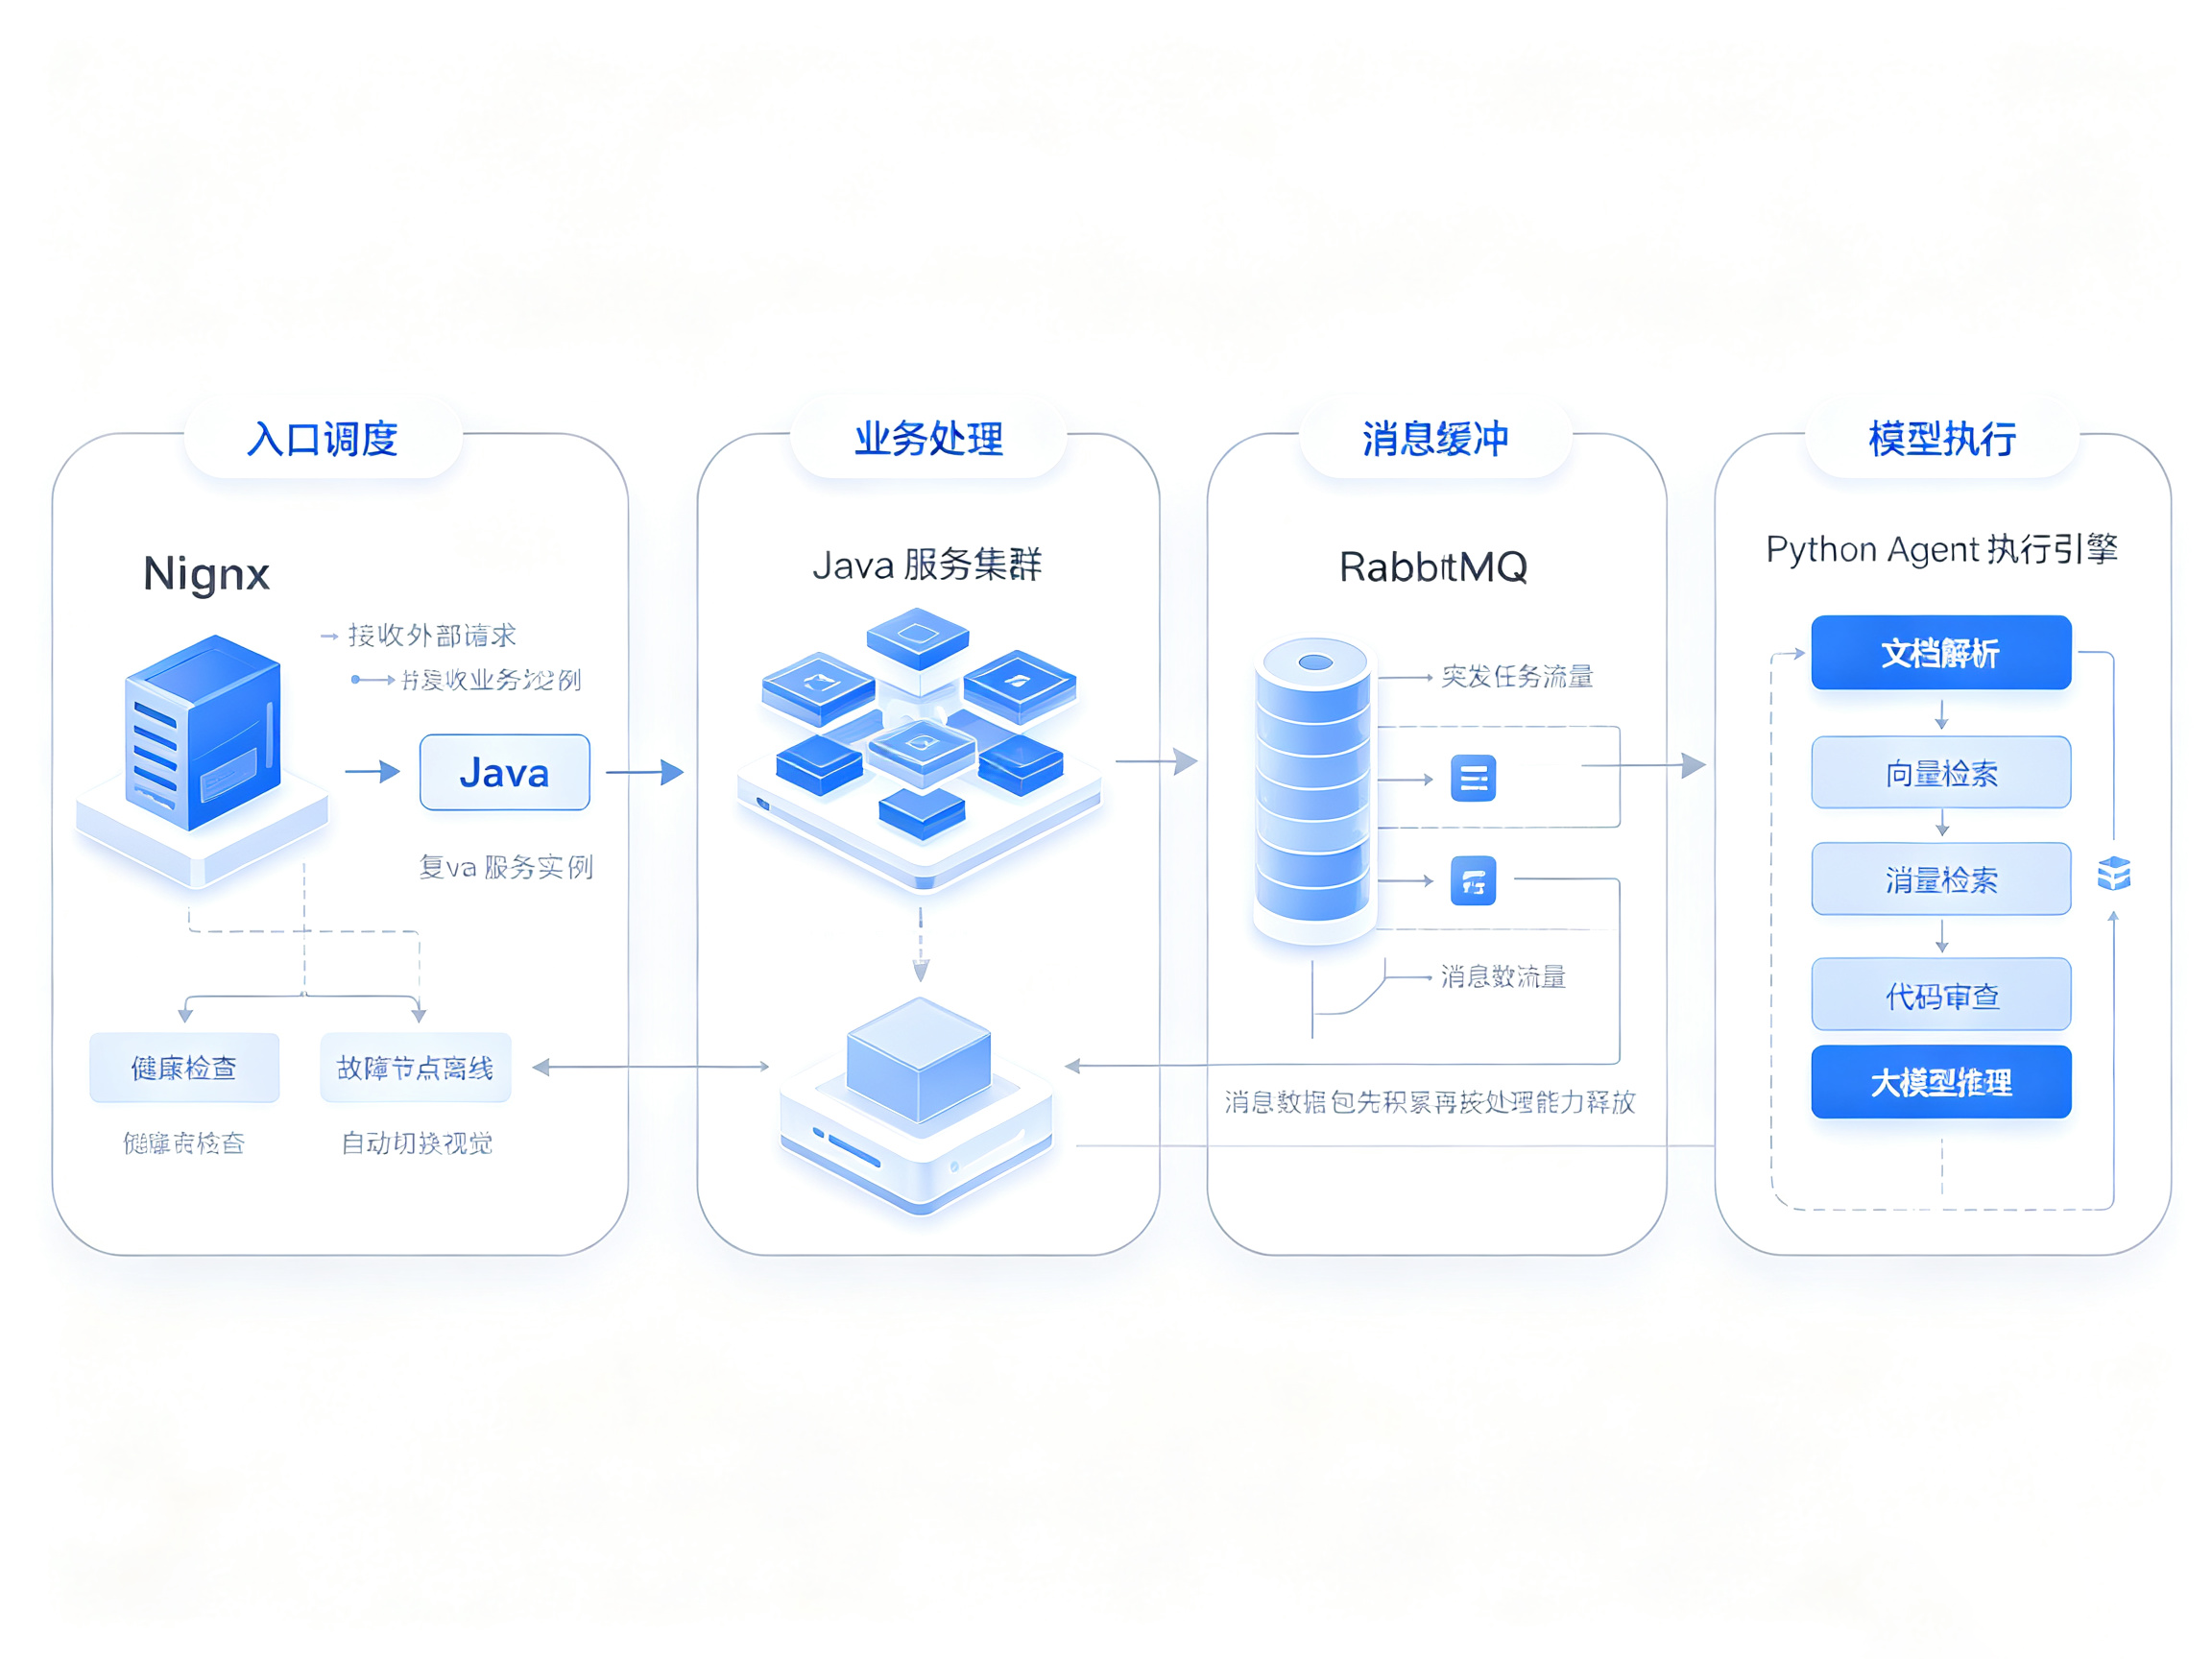
外部请求通常先到达 Nginx,它作为系统的集中接入点,将流量均衡分发至后端 Java 服务实例。
Nginx 具备较强的并发连接处理能力,单机可支撑较大规模的连接,将 TLS 卸载、静态资源缓存等处理开销前置。当某台 Java 节点因发布或故障离线时,Nginx 的健康检查机制会及时将其从转发列表中移除,请求自动切换至健康节点。
入口层夯实了,后方业务层便能更专注于复杂逻辑的处理。
业务中枢:Java
Java 服务位于架构核心,承接 Nginx 的流量,专职处理用户交互、鉴权认证与业务编排,再将具体任务准确分发给执行引擎。
Java 与 Python Agent 之间依靠清晰定义的接口通信,双方可独立迭代与扩容:业务高峰时,Java 侧增加实例即可吸收并发;模型侧吃紧时,单独扩展 LLM 推理服务即可。
解耦,让任一层级的升级互不牵制。但任务如何在两层之间可靠传递?答案在于异步机制。
执行引擎:Python Agent
Python Agent 是工作流的实际执行主体。它基于 LangGraph 这类面向大模型应用设计的编排框架,驱动从文档解析、向量检索到代码审查的一整条工具链。
它接收 Java 分发的指令,按预设节点顺序调用各能力组件,让中间结果在节点间流转。执行引擎与编排层分离后,Python 侧可专注于算法与模型集成,版本升级不波及前端业务。长任务的状态由检查点机制持久化,中途失败可从断点续跑。结果返回时,它只交付最终产物。
异步解耦:RabbitMQ
当任务量在某个时段暴涨,同步调用会让系统快速过载。RabbitMQ 作为消息队列部署在 Java 与 Python Agent 之间,先承接突发流量,再按执行引擎的处理能力平稳释放。
这种任务缓冲机制让系统在峰值面前保持从容。队列支持持久化,消息落盘后再确认,即便服务重启,未处理任务也得以保留。长耗时任务(如整批文档的知识图谱构建)交给异步通道执行,前端用户不必阻塞等待。
需注意:队列并非无限容纳,若消费速度长期低于生产速度,积压仍会导致系统性能下降。
多存储集群的高可用协作
知识类系统依赖多类存储,各自承担专门职责。
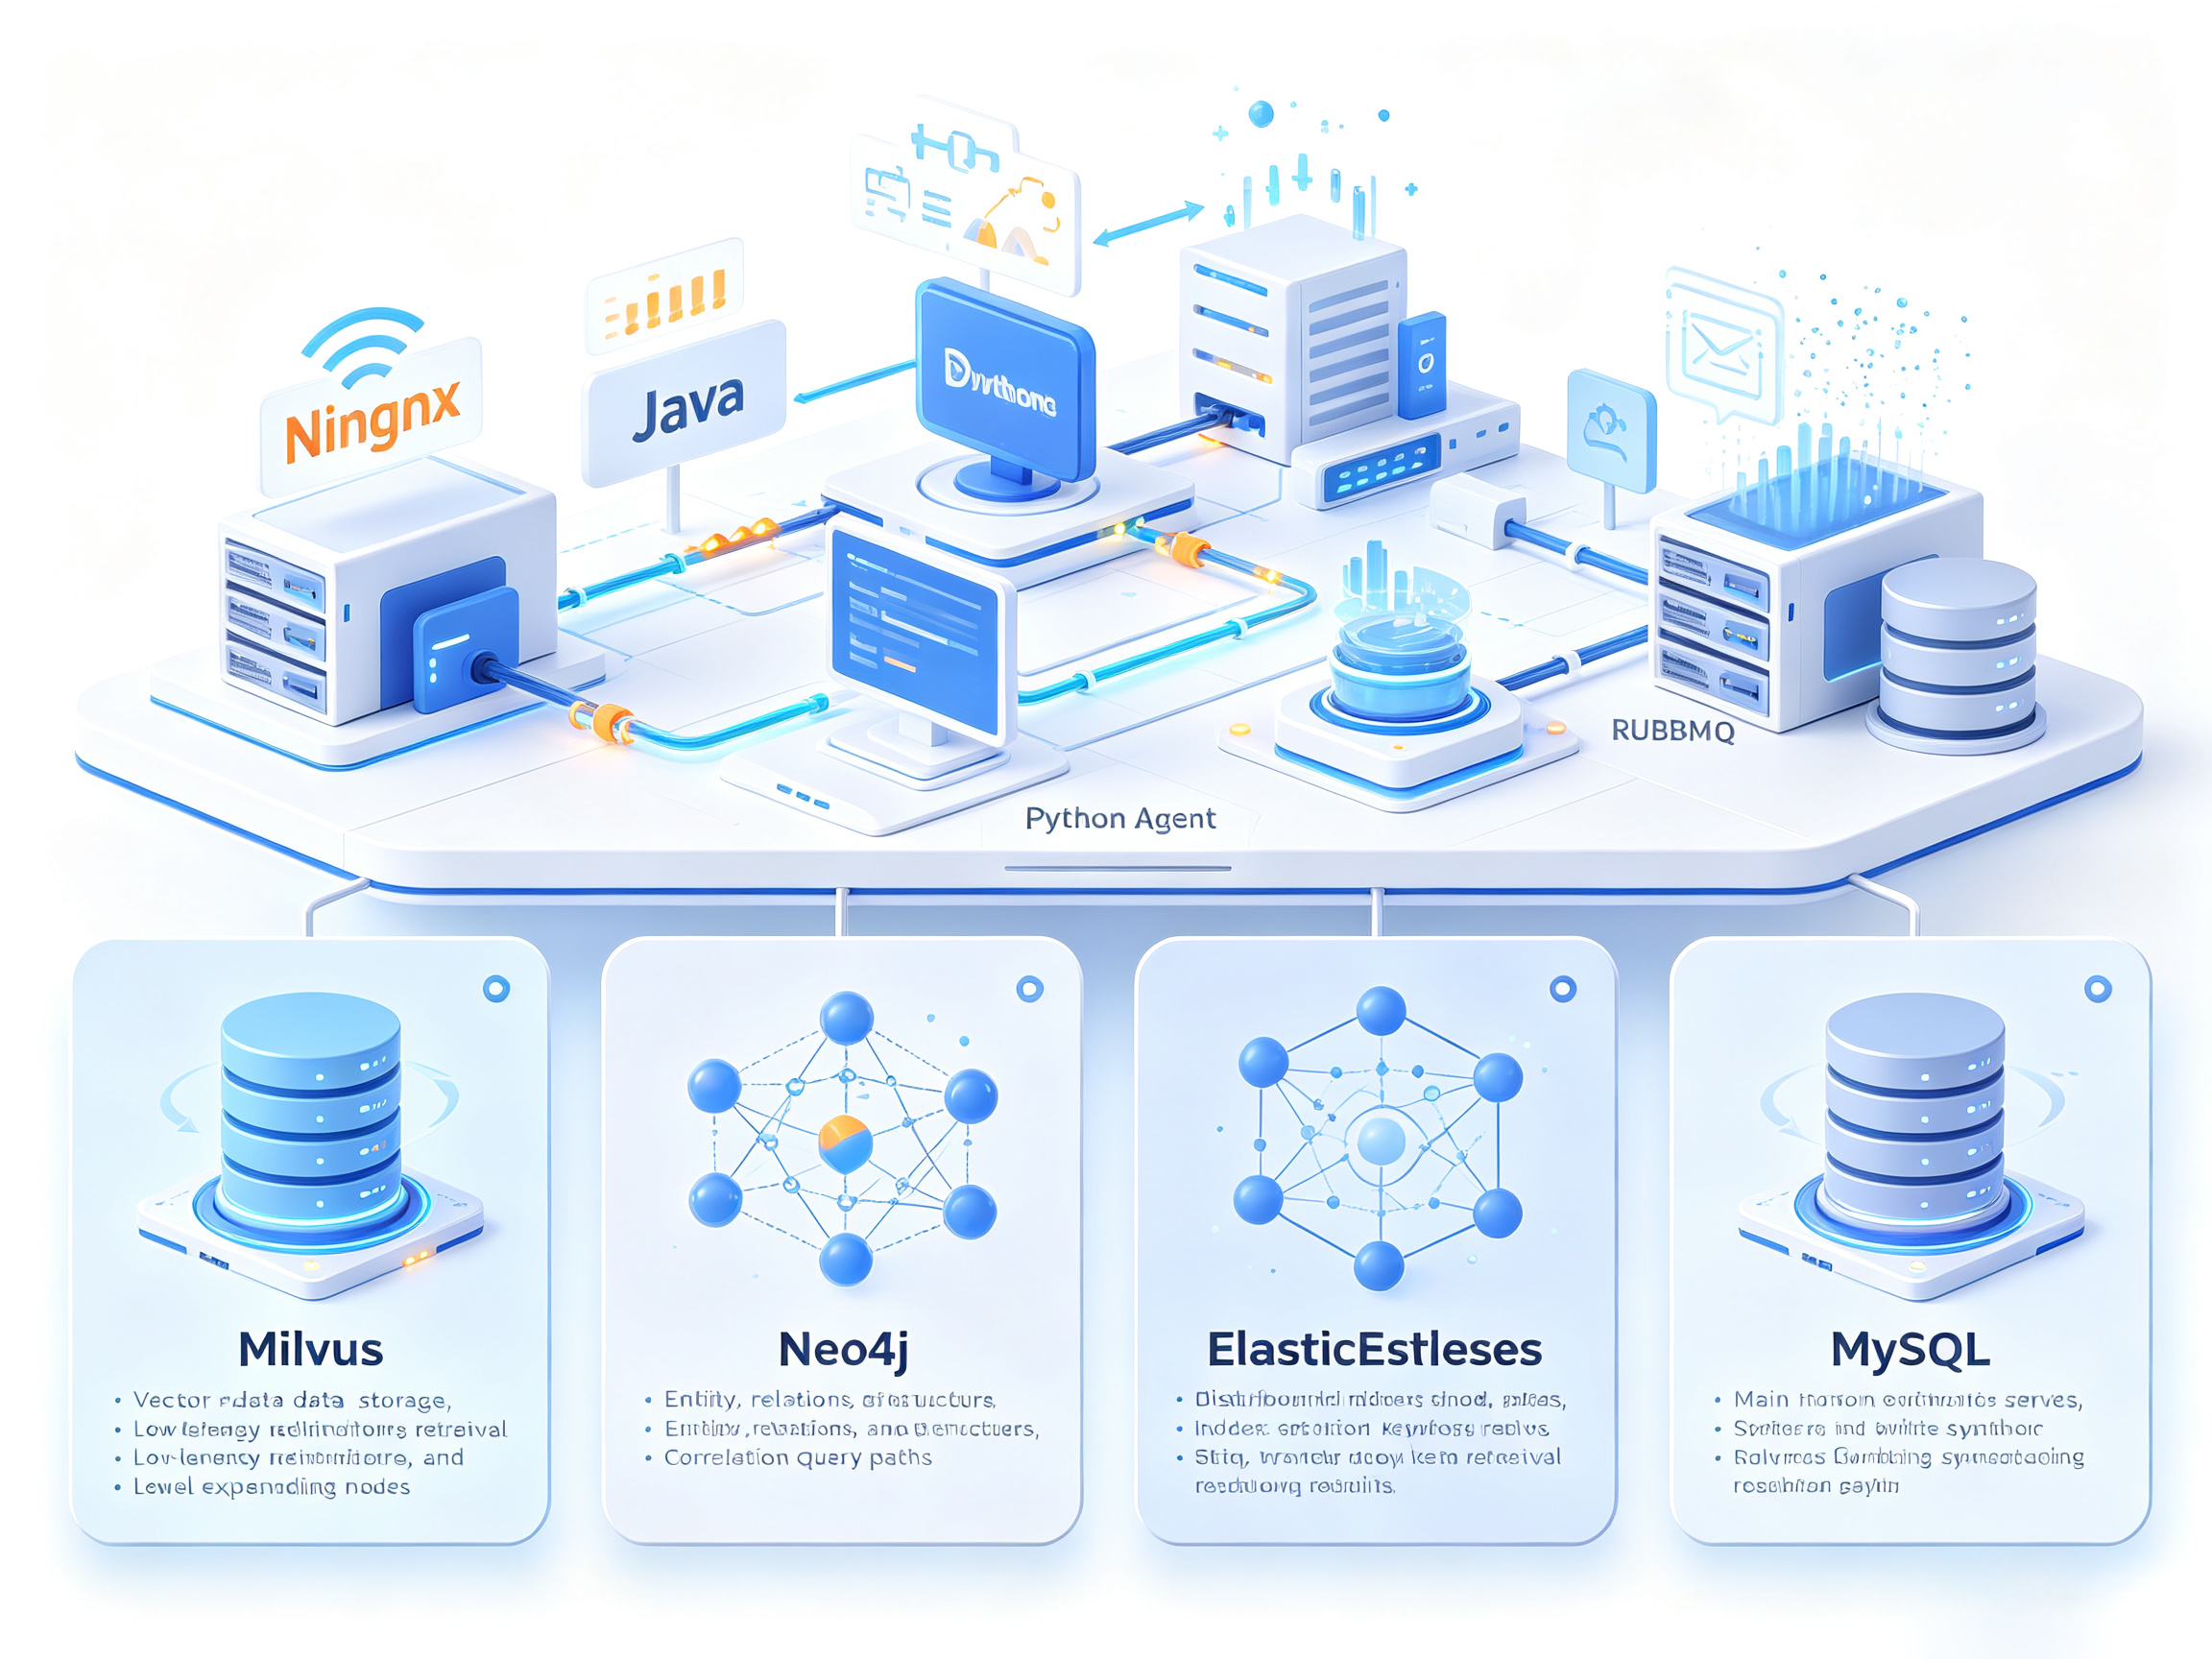
- Milvus 集群负责向量数据存放,助力实现低延迟相似度检索,支持独立水平扩展。
- Neo4j维护实体与关系的图结构,支撑跨节点关联查询,提供图数据高可用能力。
- Elasticsearch承担关键词全文检索,与向量检索融合后提升结果准确性,具备分布式检索特性。
- MySQL 主从集群保存业务元数据与配置,采用主写从读模式,在保障一致性的同时分摊读压力,同样支持水平扩展。
再优秀的模型,也离不开一套经得起生产考验的系统。Nginx 负责接入,Java 做编排,Python Agent 执行任务,RabbitMQ 缓冲流量,Milvus/Neo4j/ES/MySQL 各司存储职责。当这些组件以微服务方式紧密协作,企业 Agent 正逐步从演示原型转化为更可用的生产力工具。
FAQ
Q1:企业级 Agent 为何适合采用微服务架构?
单一进程较难同时优化高并发接入、重算力推理和持久化存储。微服务让每层独立伸缩,故障也被隔离在局部,减少对全局的影响。
Q2:RabbitMQ 在架构里解决了什么关键问题?
它缓存突发任务后匀速放出,避免执行引擎被瞬时流量冲垮;持久化机制同时保障任务不丢失。
Q3:向量检索和全文检索为何要混合使用?
向量检索理解语义,关键词检索提升精确性。两者融合后既容错又准确,是缓解 RAG 幻觉的实用手段之一。
Q4:知识图谱在 RAG 里发挥什么作用?
图谱将实体和关系结构化,补充上下文背景,让模型捕捉数据间的结构关联。
更多推荐


 22
 0
- 0


 已为社区贡献7条内容

所有评论(0)