
通用大模型 API VS 企业级私有化智能体平台:为什么企业不宜只依赖一个 Chat 接口?
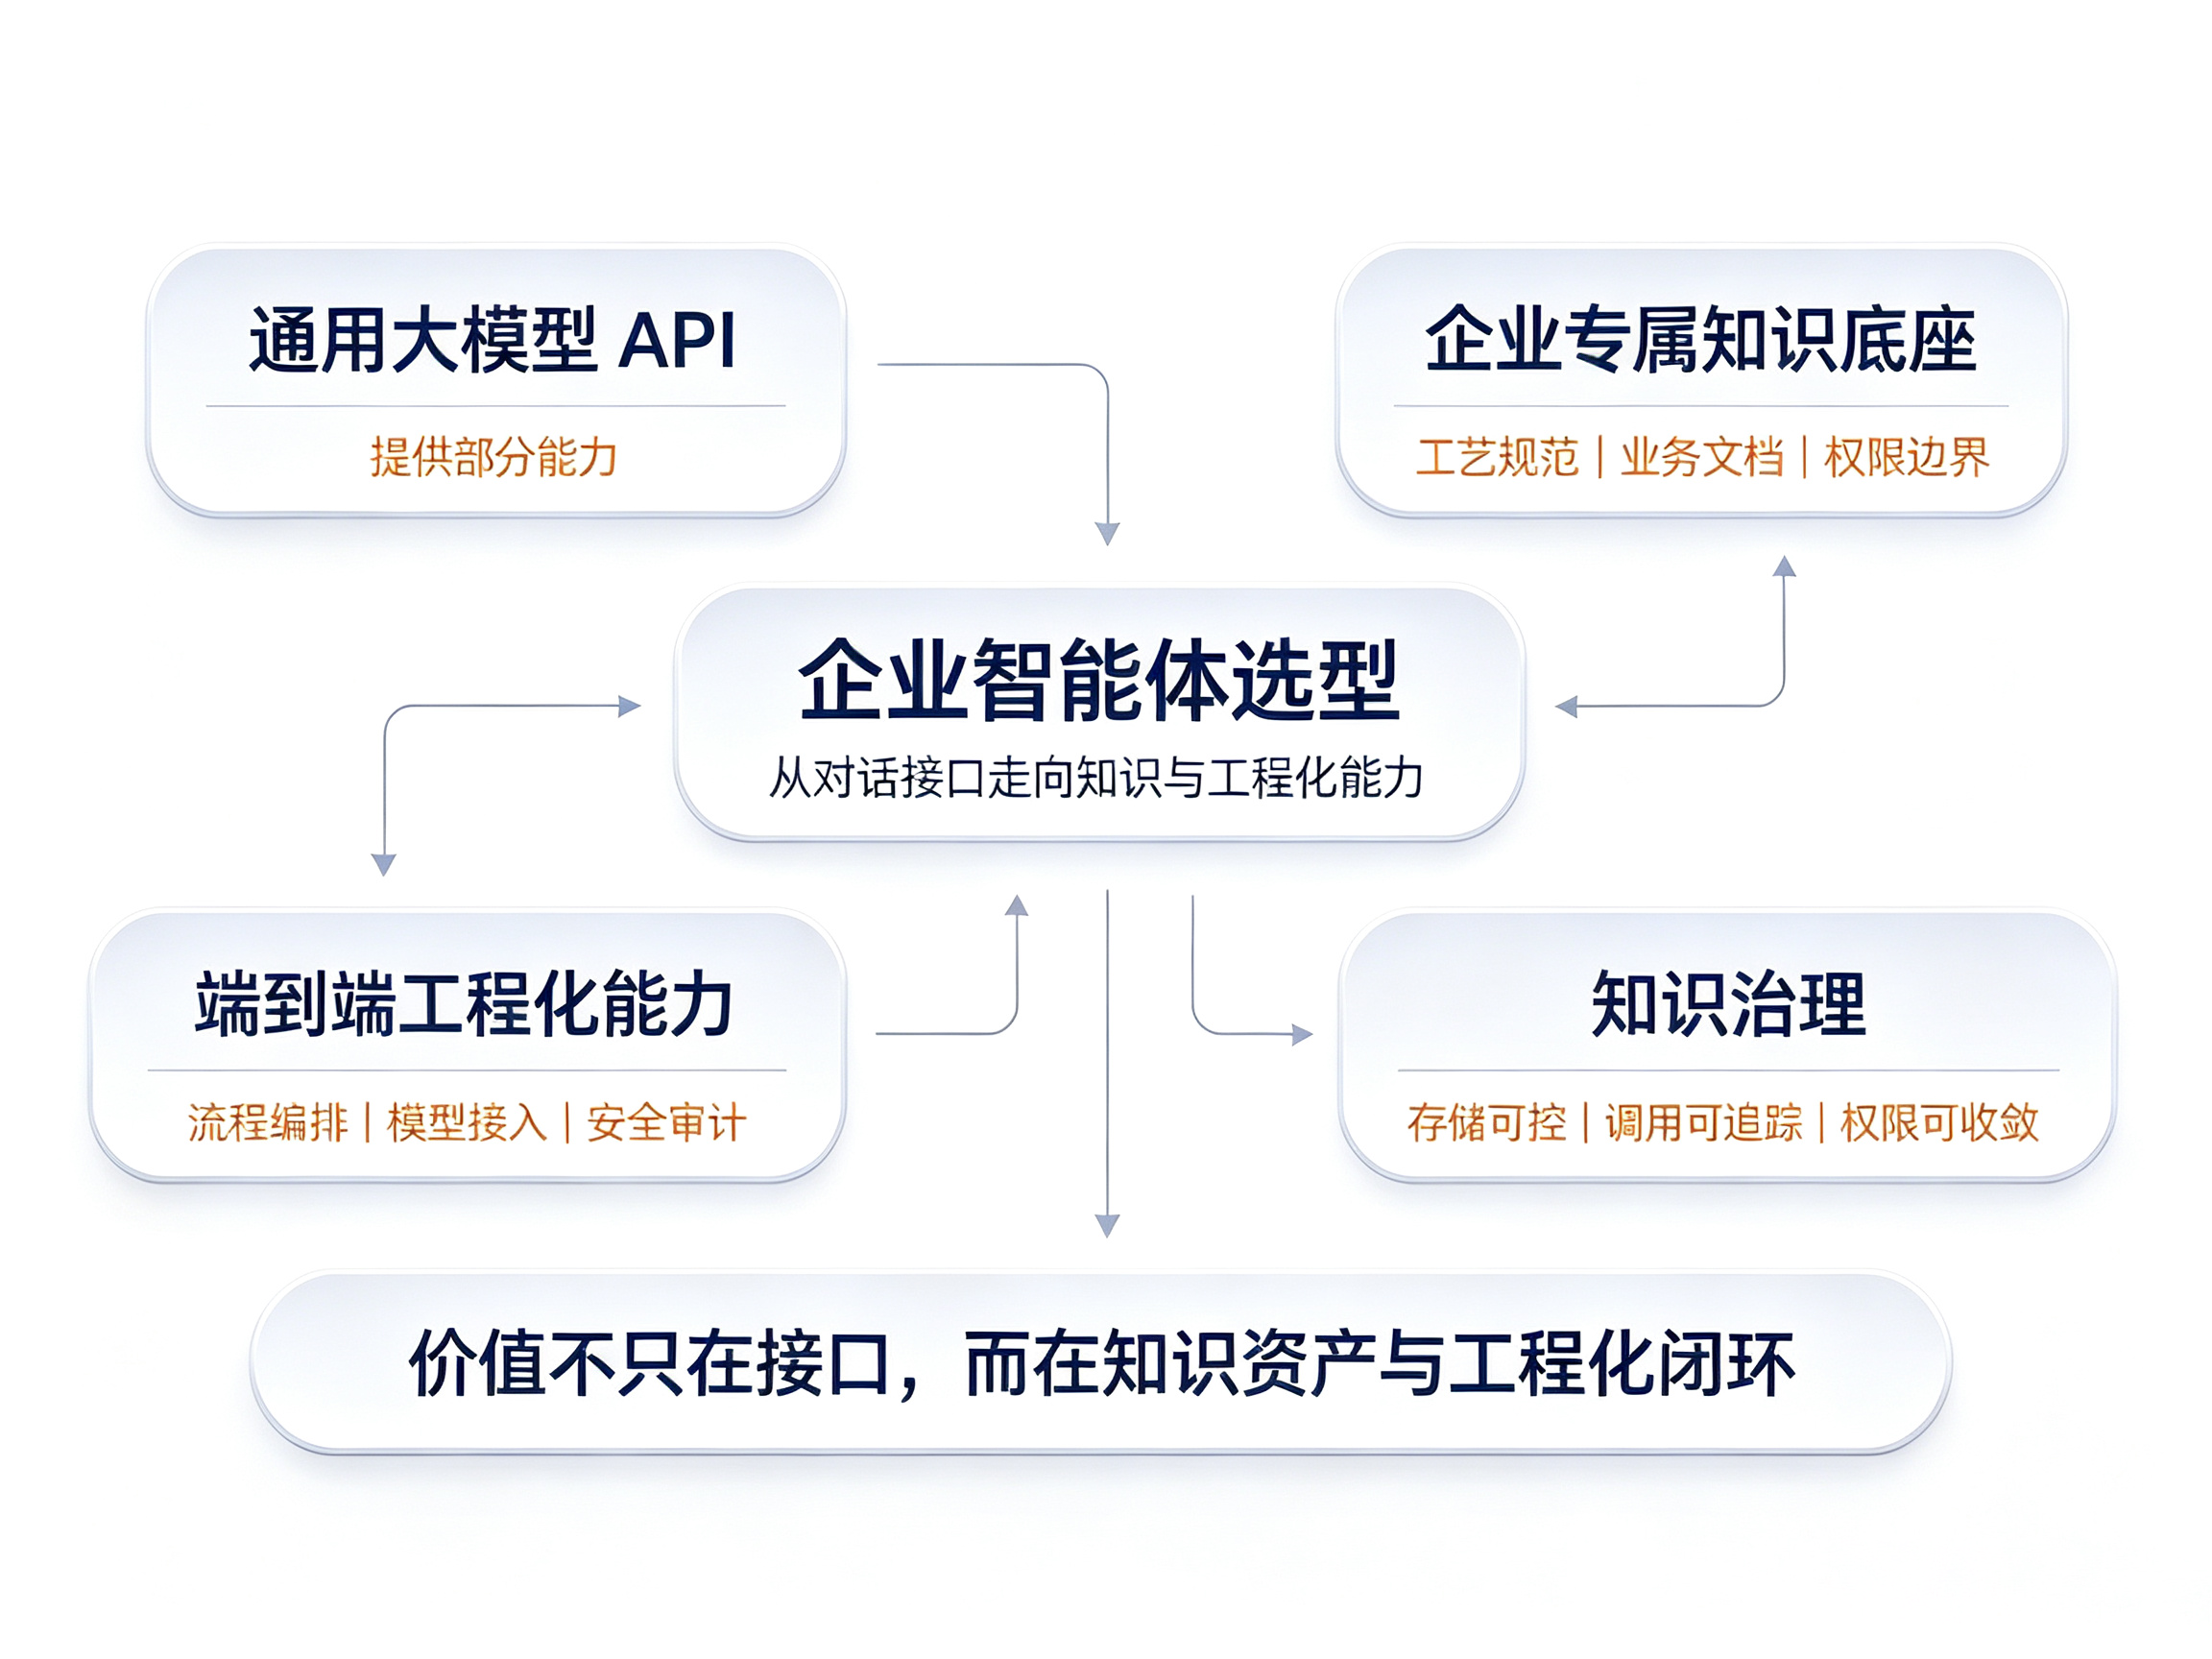
企业部署 AI 的成效,在很大程度上受是否拥有企业专属的知识底座与端到端的工程化能力的影响,通用大模型 API 提供的是其中一部分能力。
本文围绕企业智能体选型这一主题,在私有化 AI 平台对比的框架内,厘清企业 Agent 系统选为何要跨过对话接口这道坎。传统知识库和 AI 知识库区别、企业知识管理系统选型的关键标准,也会在后续逐层展开。
我们首先明确一个结论:把 AI 价值寄托在外部接口上,企业需要评估数据与知识在外部服务中的存储、调用和权限边界,如果缺少知识治理和工程化能力,项目可能停留在演示阶段。你能接受自家核心工艺规范存放在别人的服务器上吗?
第一步总想着接个 API?
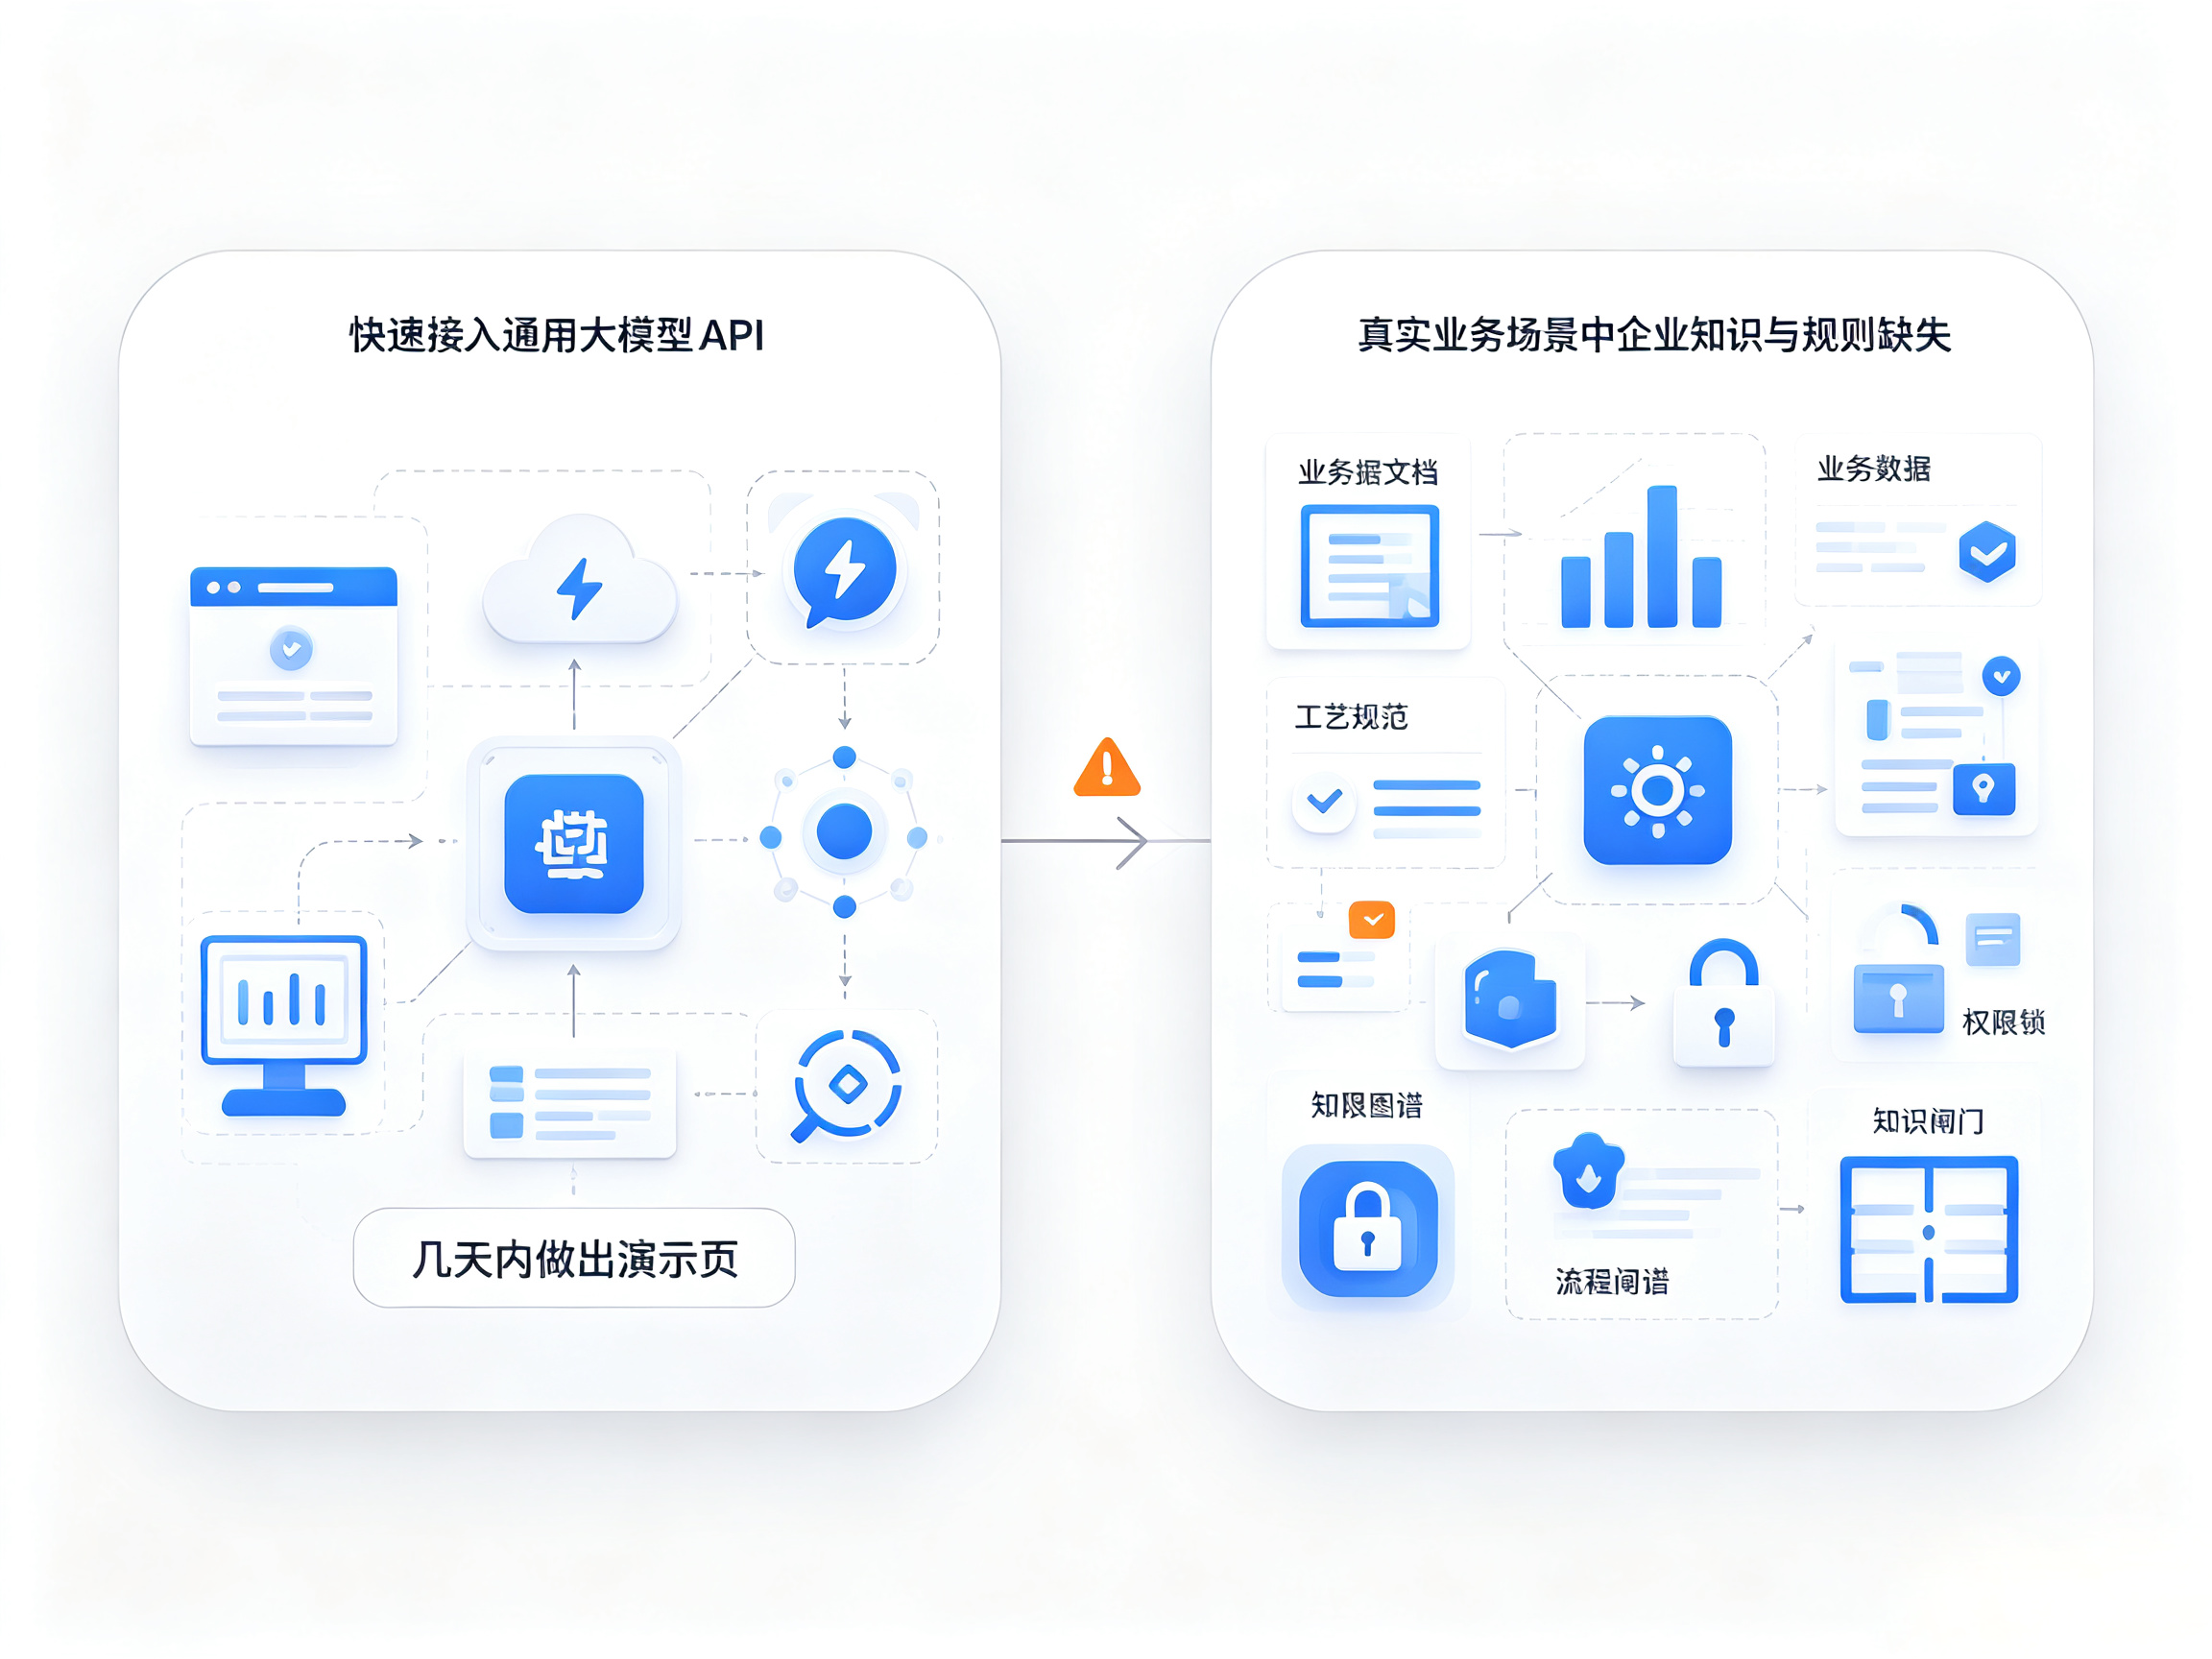
部分团队启动 AI 项目时,会选择调用大模型厂商的接口。因为这条路最短,几天就能端出一个会聊天的演示页,看起来已经把 AI 用起来了。
但演示页终究只是演示。真实业务数据喂进去,回答开始跑偏,越问越像在说外行话。模型其实很聪明,错在有人把接口当成了平台。接口只提供了对话能力,并没有导入企业的业务知识与规则。
知识是否专属可控
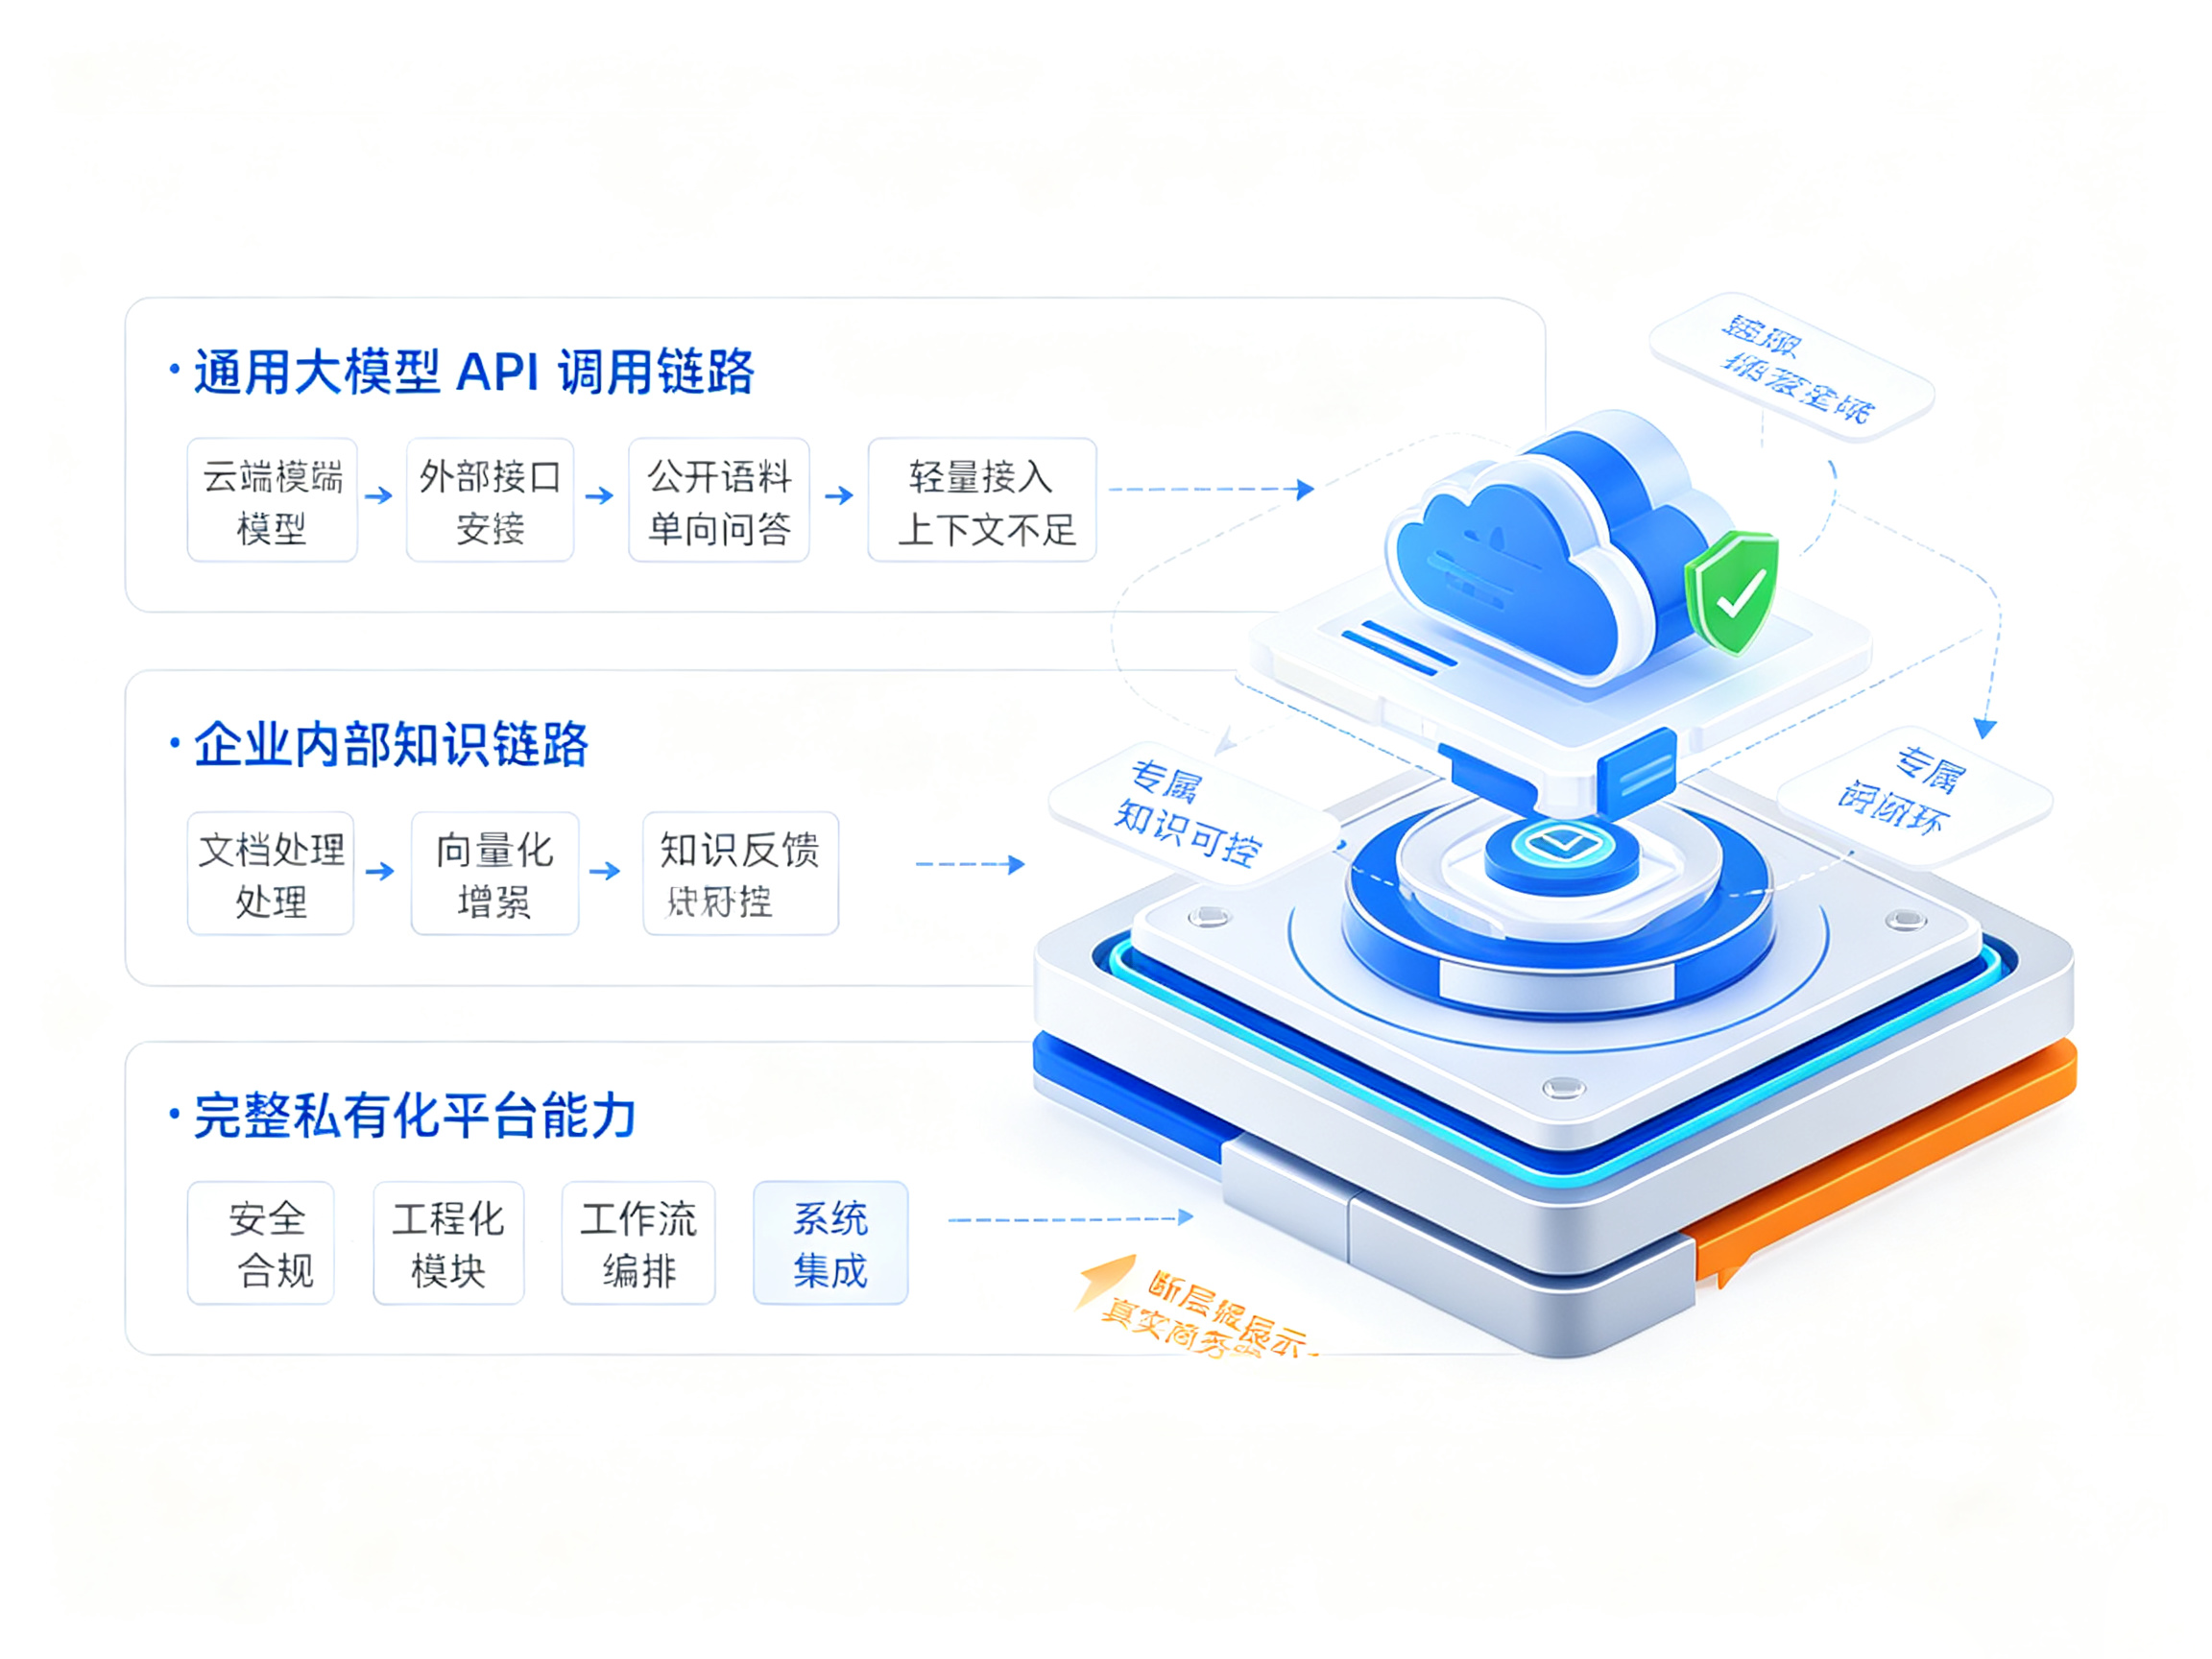
直接调通用 API,模型靠公开语料作答。若未接入企业内部知识和上下文,通用API通常难以覆盖具体业务流程和规则。
私有化平台把内部知识库打通,文档切分、向量化后进入检索体系,回答能引用具体条款并标出来源。知识在系统里通过持续反馈可逐步优化,检索增强生成还有助于缓解模型凭空编造的问题。
数据安全与合规
核心文档与源代码如直接上传至外部接口,企业需评估数据安全风险。制造、金融等受监管行业对数据出境卡得很严,这类调用方式埋着合规隐患。
私有化部署通常有助于将关键数据控制在企业指定环境内,并为等保及行业监管合规建设提供支持。对不少企业来说,数据安全是上线 AI 的第一道门槛。
工程化与落地能力
单独调用API主要获得模型调用能力,检索、知识图谱、工作流等能力通常仍需额外建设。检索增强要自己搭,知识图谱要从零建,工作流编排和自学习机制同样要自研。从文档处理引擎到 Agent 编排框架,如果关键环节出现不足,可能会影响项目进度和落地效果。
成熟的私有化平台通常会预置较完整的链路能力,并可结合项目测试进行验证,上述能力封装成可配置模块,可减少从零搭建部分基础能力的投入,复用平台已有模块。
模型大小说明不了问题,工程化做到位没有才是关键。
定制与集成
通用 API 很难贴合企业自有的业务流程,跟 OA 及 CRM 等内部系统的对接基本都要单独开发。私有化平台带上配置化工作流引擎,用户用 JSON 或 YAML 就能拼出复杂的 Agent 流程,再通过开放 API 和现有系统接成一体。平台里多种预置节点覆盖了数据提取与条件路由等环节,业务的特殊逻辑也能写进配置。”AI可以从孤立聊天窗,逐步嵌入业务流程中的执行节点。仅靠 API 接口,难以与业务系统深度集成。
避坑点:会聊天不等于能干活
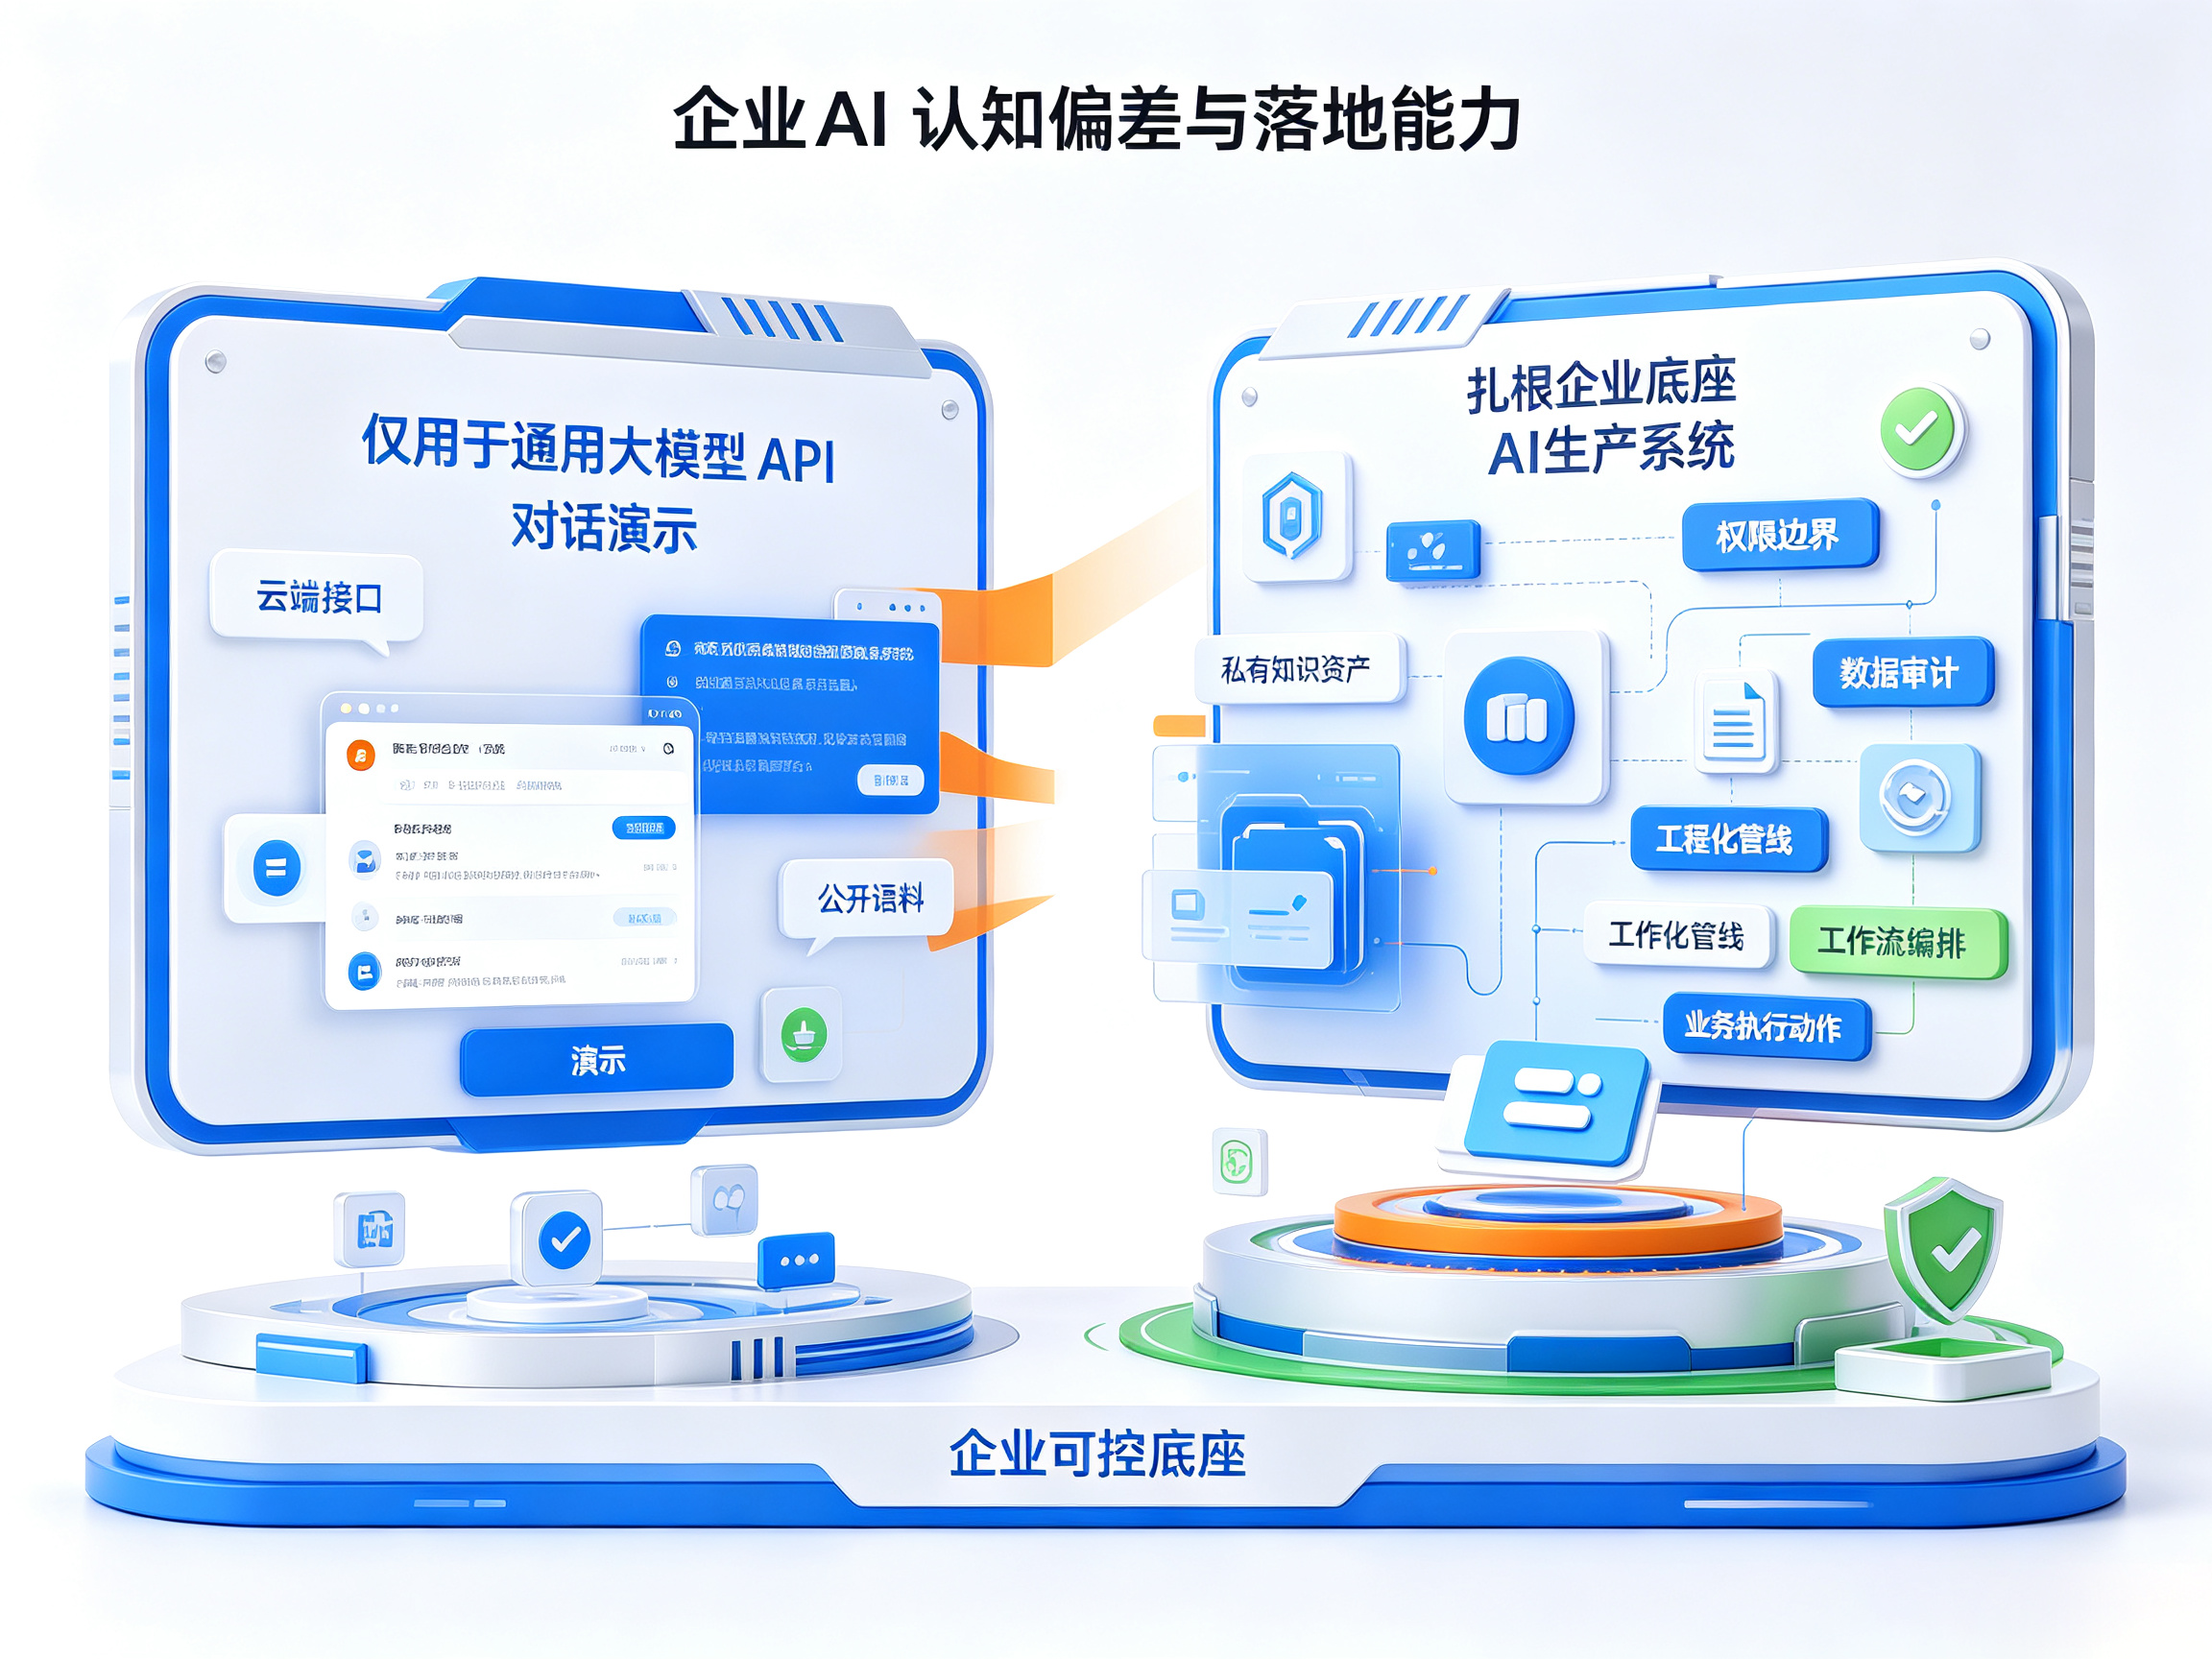
需注意将“会对话”等同于“能干活”可能存在认知偏差。对话能力只解决沟通这一层,业务价值来自知识加工与执行动作。
企业的 AI 能力,适合扎根在自己能掌控的底座上。私有化平台可将知识沉淀能力与权限、审计、隔离等安全机制结合交付,工程化能力让 AI 从演示走到实际生产。选型时把专属知识的沉淀深度摆在前面,数据边界的守护力度与业务流程的嵌入程度同样要看重。模型参数规模,可以排到清单末尾。
常见问题(FAQ)
问:中小企业是否也需要私有化部署? 答:业务涉及客户隐私或受行业监管时,私有化能有助于合规建设。数据敏感度低的团队可先用公有 API 验证场景,后续再迁移。
问:传统知识库和 AI 知识库区别在哪里? 答:传统知识库依靠人工录入与关键词检索,查找效果受限于维护人员的经验。AI 知识库自动解析文档、生成向量并做语义检索,可结合内容检索与生成能力辅助产出答案,重要场景仍建议保留审核机制。
问:切换大模型会影响已有工作流吗? 答:配置化平台把模型调用抽象为节点参数,更换模型时主要调整配置参数,工作流逻辑与知识库原样保留。
问:企业知识管理系统选型应优先看什么? 答:优先评估知识加工能力,检索准确性与集成开放度紧随其后,部署灵活性也要纳入考量,模型参数规模反而可以放在后面。
更多推荐


 18
 0
- 0


 已为社区贡献7条内容

所有评论(0)