
大模型幻觉频发,企业如何把AI回答用在业务流程里?
面对AI生成的回复,我们通常会进行审阅、检查和修改,不会直接用作成果。就是企业用AI的难点:回答能不能被验证、能不能追到原始依据。
通用大模型未接入企业知识库时,可能会生成和事实对不上的内容,这类内容流进合同、报价这类环节,存在业务风险。这就要求我们进行知识可信化改造,用检索增强生成和知识图谱把每个回答锚定在企业自有资料上,有助于减少无依据生成,让回答更多建立在可追溯资料上。
首先我们来搞清楚大模型的“幻觉”。
幻觉需应对
幻觉这个词最早出现在医学里,指人清醒时看见、听见并不存在的东西。研究者把它借用到生成式AI上,形容模型输出和事实或给定材料冲突的内容。2022年ChatGPT走红后,这现象被反复讨论,渐渐成了通用说法。
模型为什么会编?其实是它的工作方式问题。它底层是个概率模型,训练目标是依据前文生成下一个词,挑哪个词按概率高低定。其训练目标并不等同于事实校验机制。
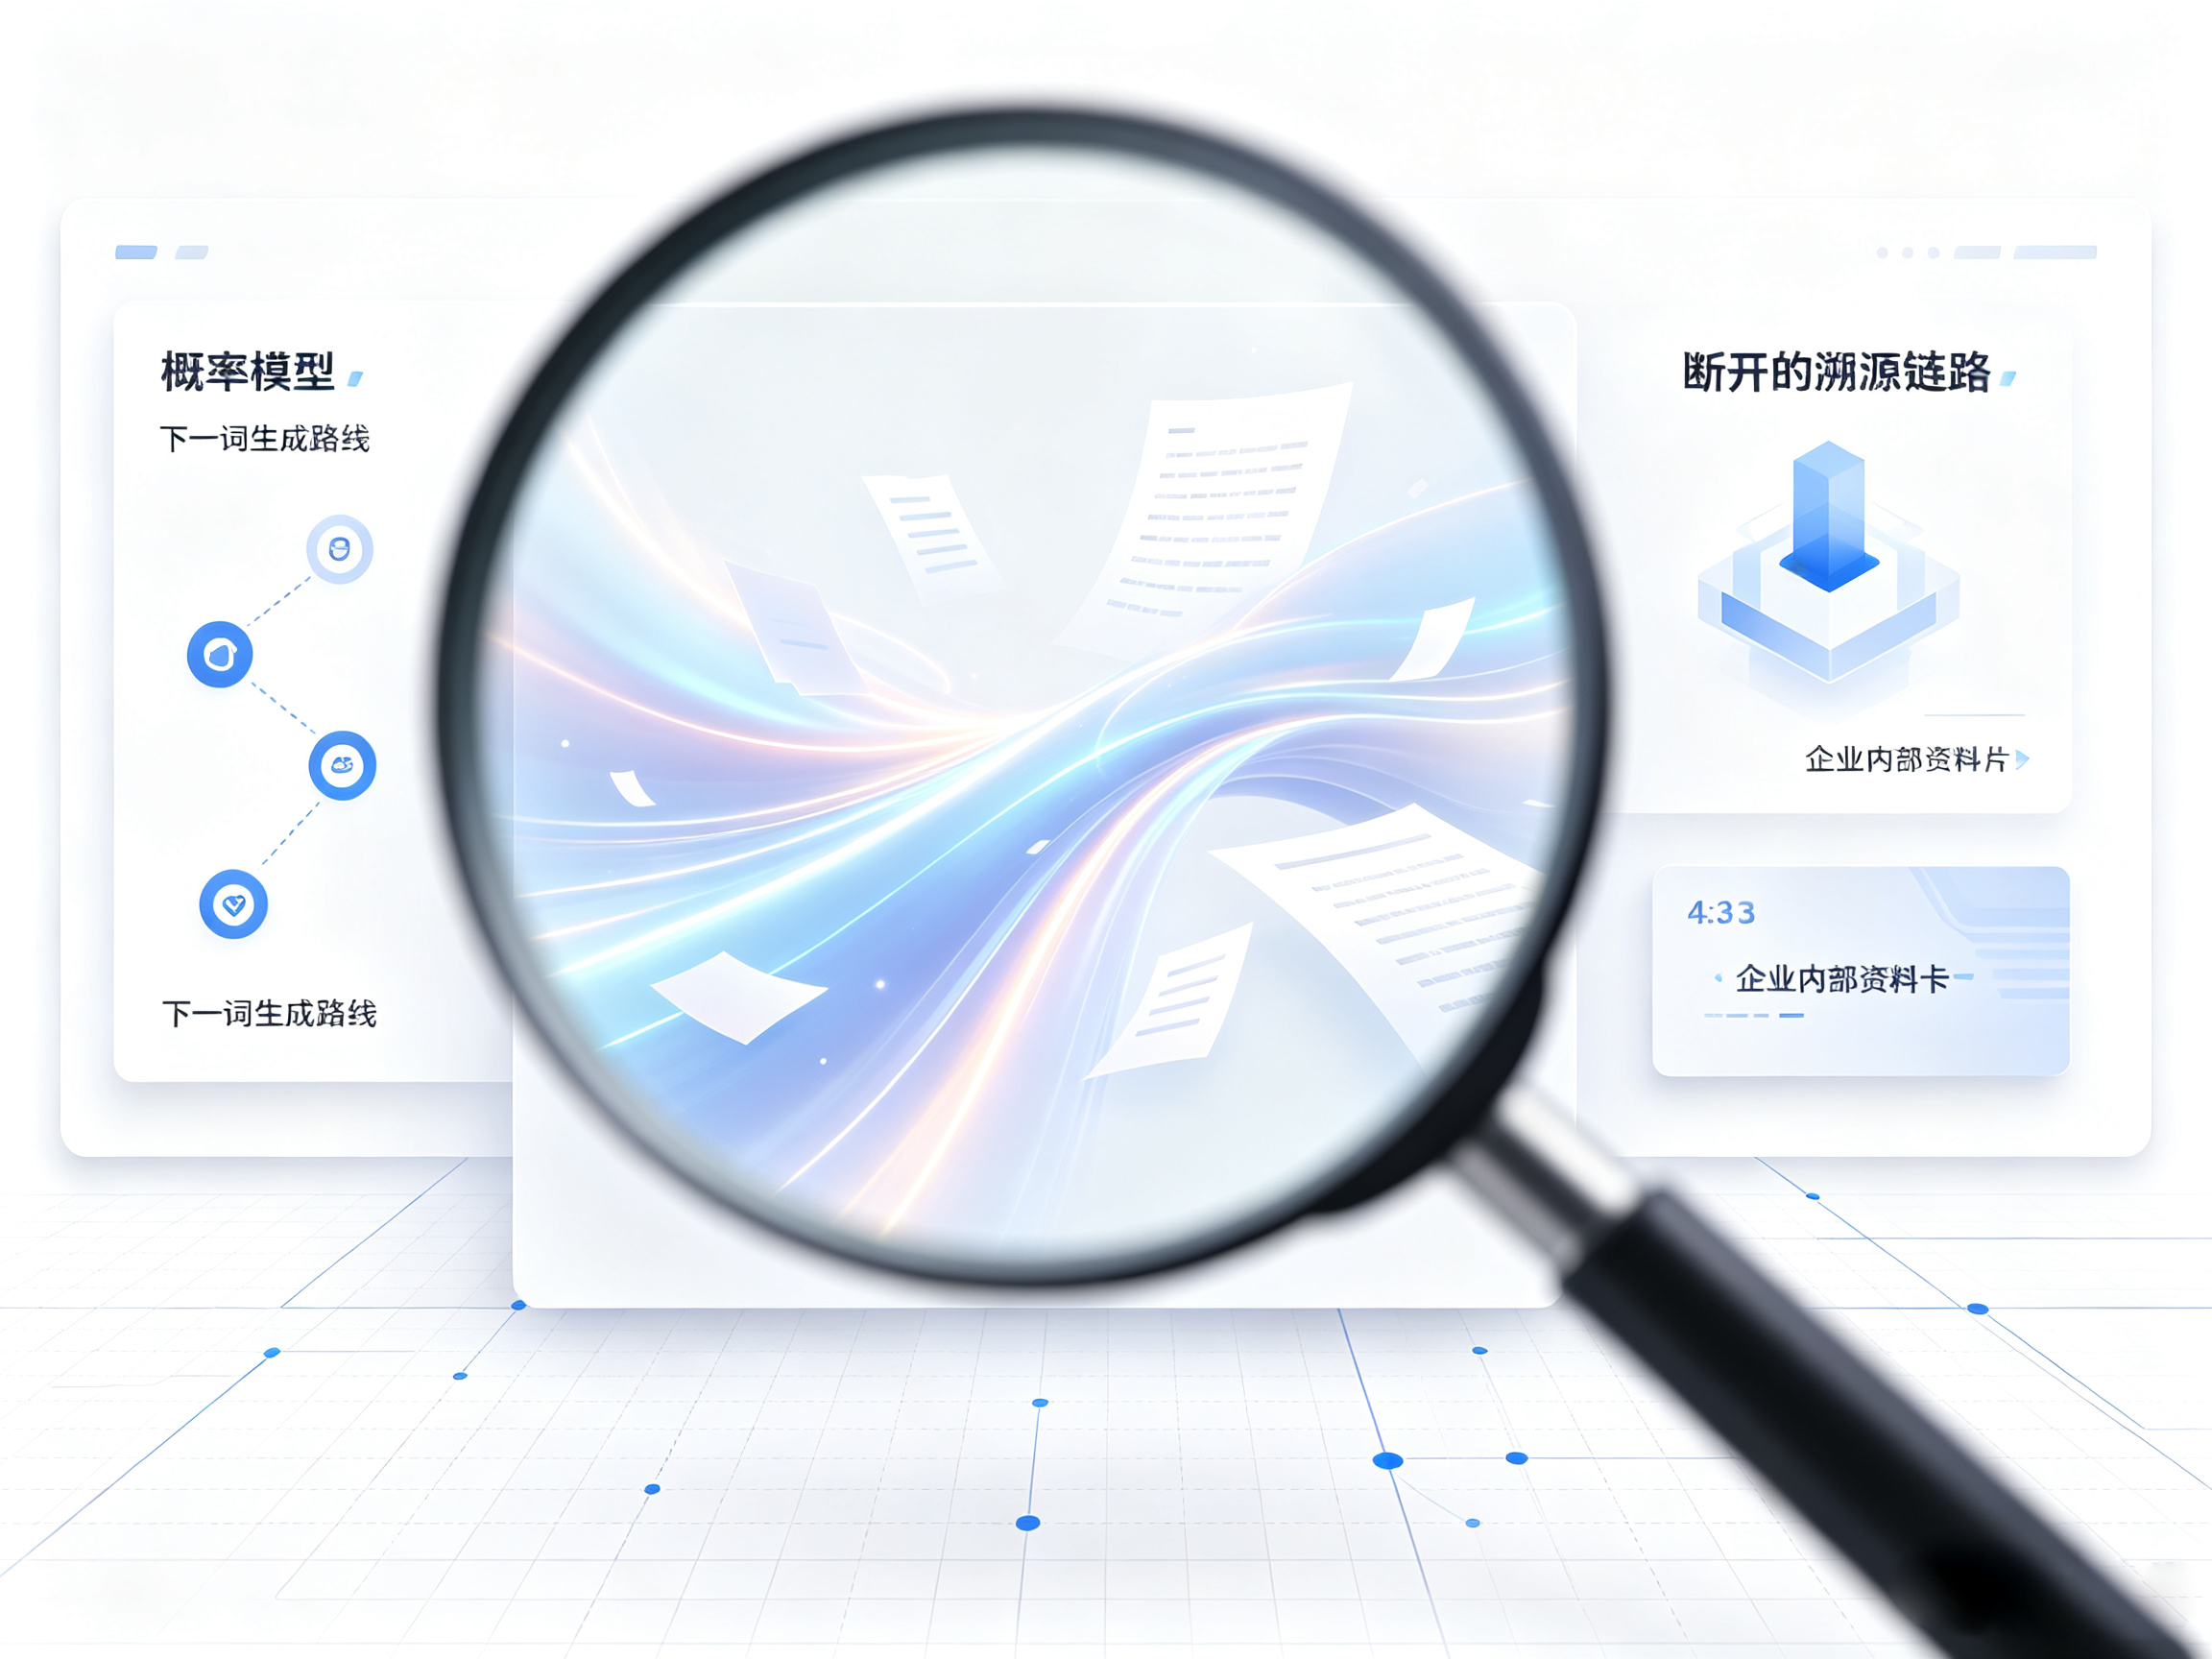
无法溯源
溯源这个词原属制造和供应链。工厂每批产品带批次号和流转记录,出问题能一路查回原料和产线,这叫可追溯。到了AI问答里,溯源是指回答要能指认自己依据了哪份文档、哪一段原文。
通用大模型较难提供这一环。它给的答案常是一段整合后的文字,来源和推理路径都收在模型内部。审计和合规都要求指认依据,在审计、合规要求较高的业务场景中,难以直接采用,责任因此难界定。拿不出依据的回答较难满足合规审查要求。
缺少企业专属上下文
公开训练的大模型读过整个互联网,却没读过某家企业的内部制度和产品资料。它不懂这家企业的私有业务,遇到具体问题常常答非所问。员工问完还得自己翻系统重查,刚省下的时间又还回去。
没有专属上下文,模型可能主要依赖公开知识,面对企业专属问题时准确性容易受限。它需要补充的,结果正是企业自己的内部资料。
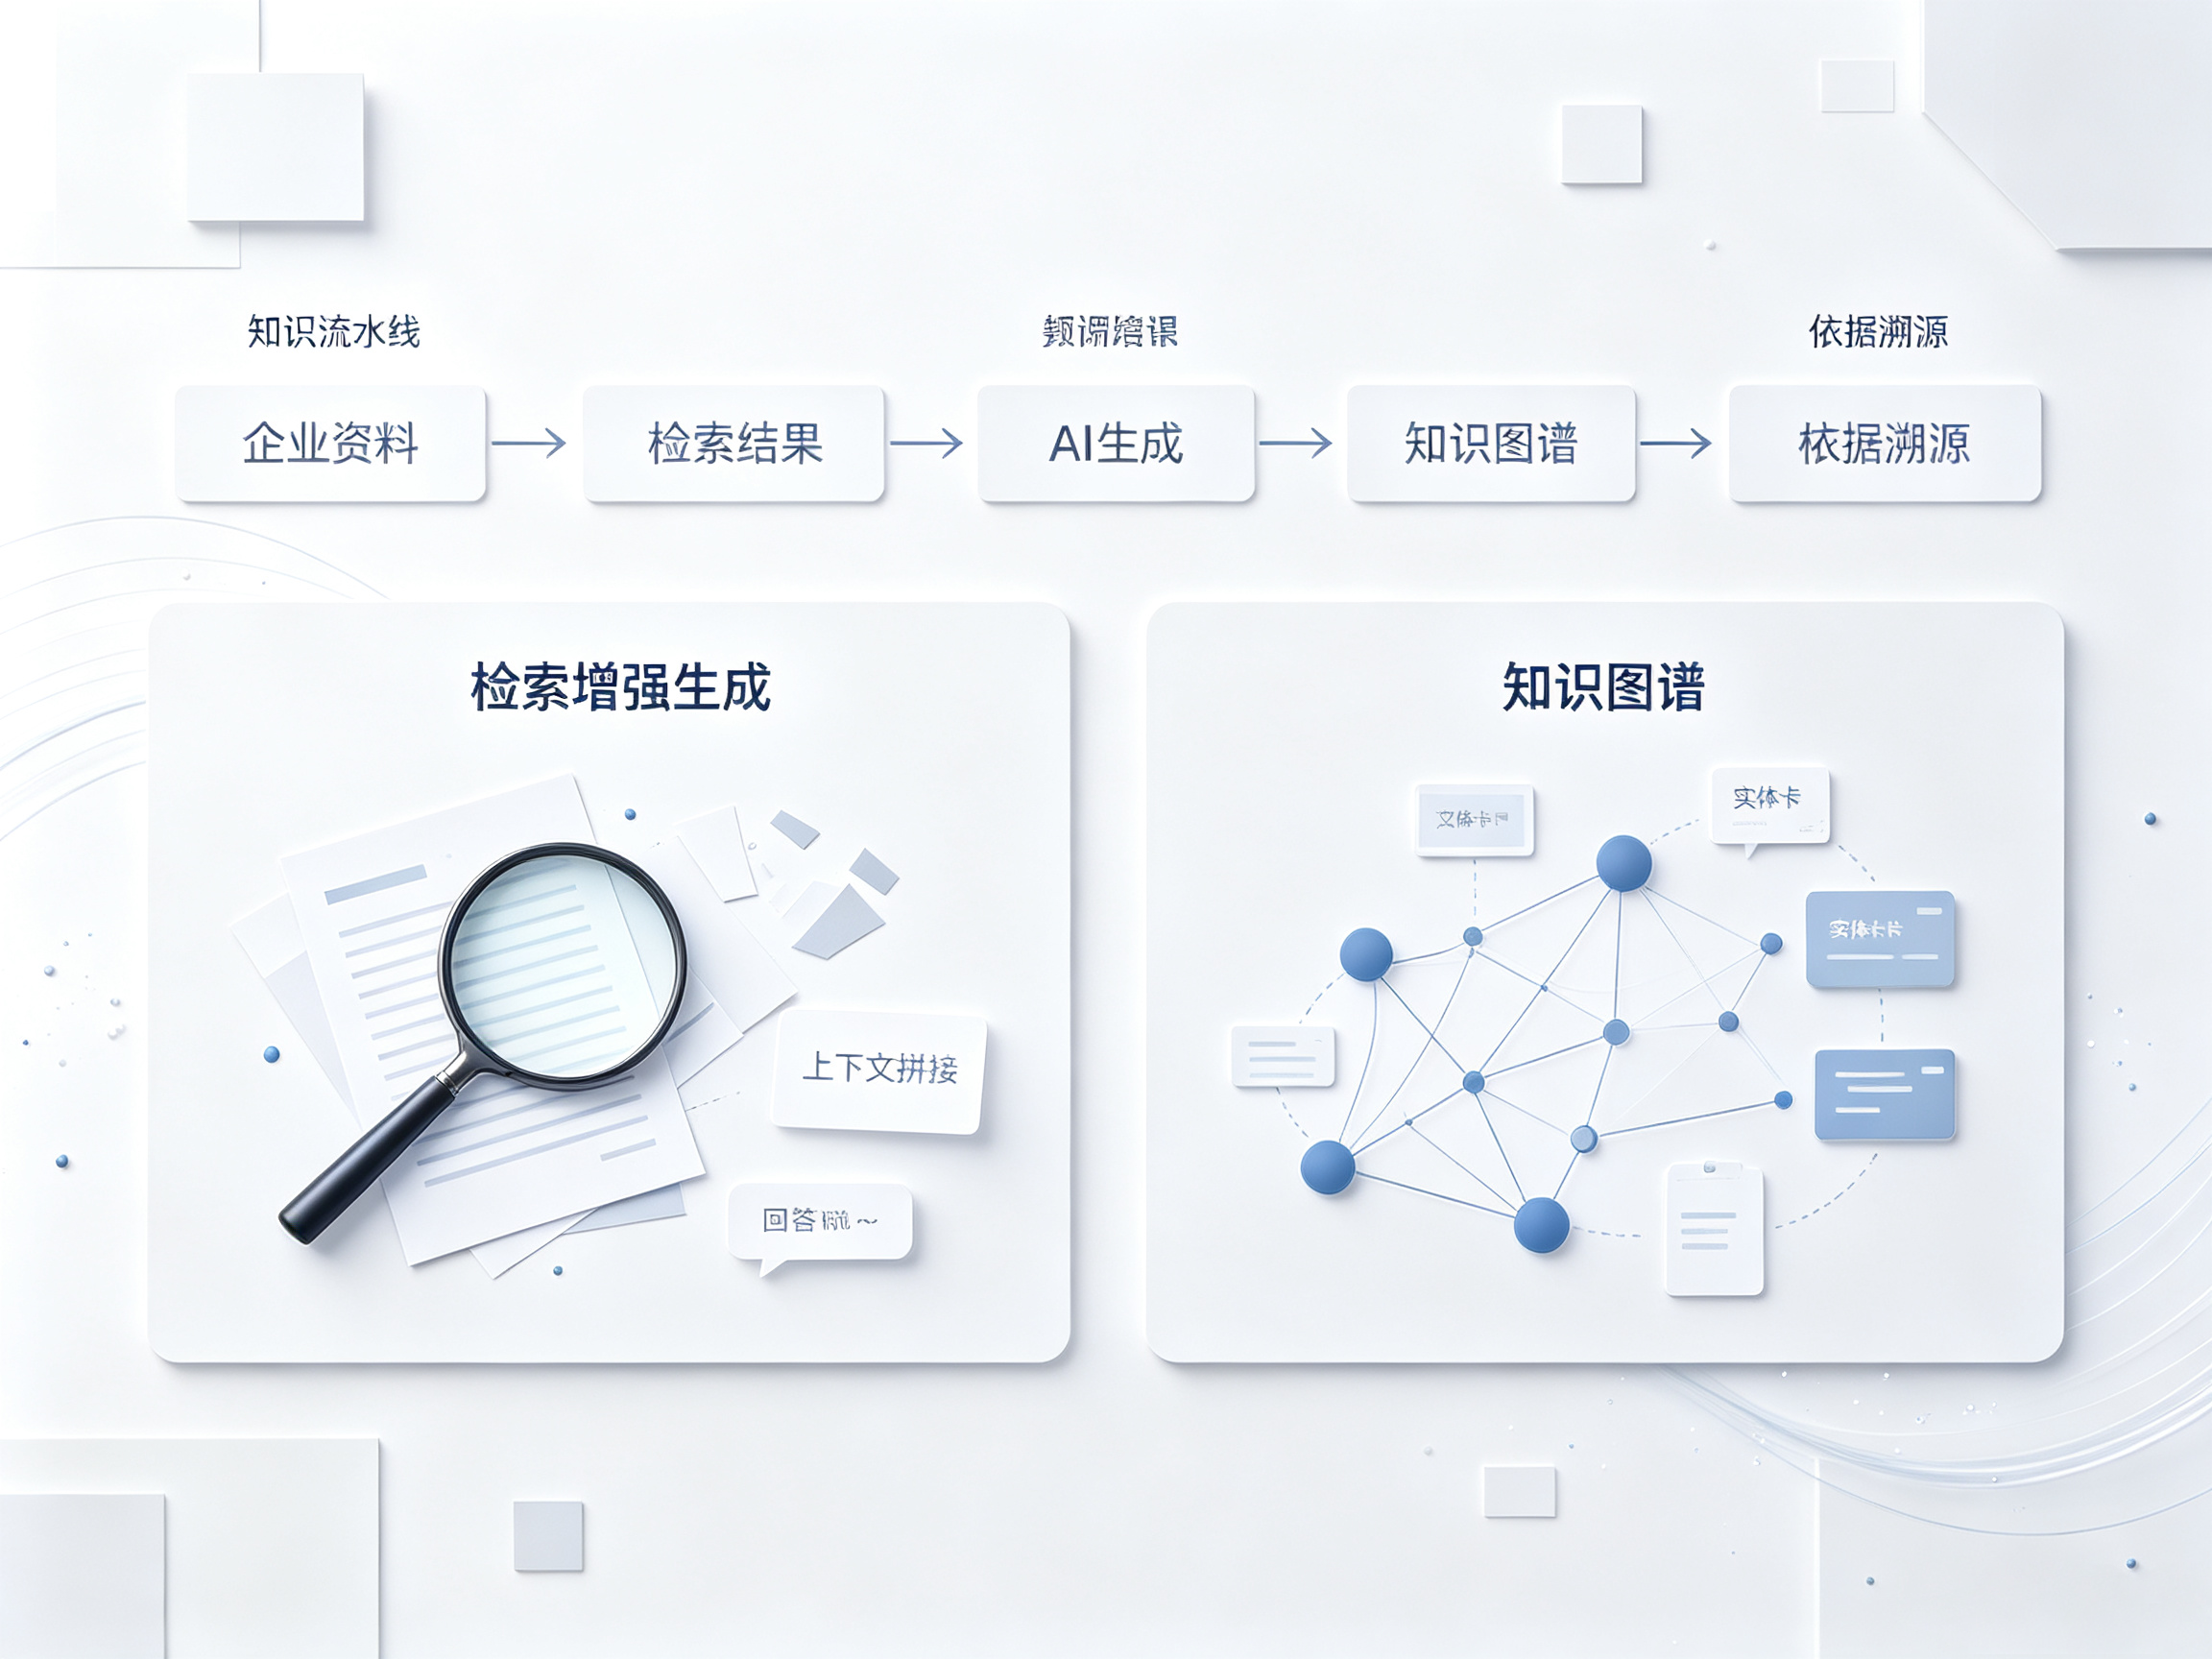
破局思路
可行的思路是,给模型它本该有的资料,再让它现学现答。
第一种是检索增强生成,缩写RAG。2020年,Meta AI的Lewis等人在NeurIPS发表《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》,首次系统化提出RAG范式:生成回答前,先从企业资料里检索相关内容,拼进上下文再让模型作答。答案受真实文档约束,编造的余地变小。
第二种是知识图谱。知识图谱技术源于谷歌2012年推出的Knowledge Graph项目,把搜索结果背后的实体和关系连成网络。企业版知识图谱自动抽取文档里的人名、机构等实体,再识别"总部位于""包含零部件"这类关系,连成一张能查的网络。它补上的是文字相似度之外的逻辑关联,比如A产品和B供应商的间接联系,靠关键词检索很难发现。
两套机制合起来,有助于将回答指向原始条目。
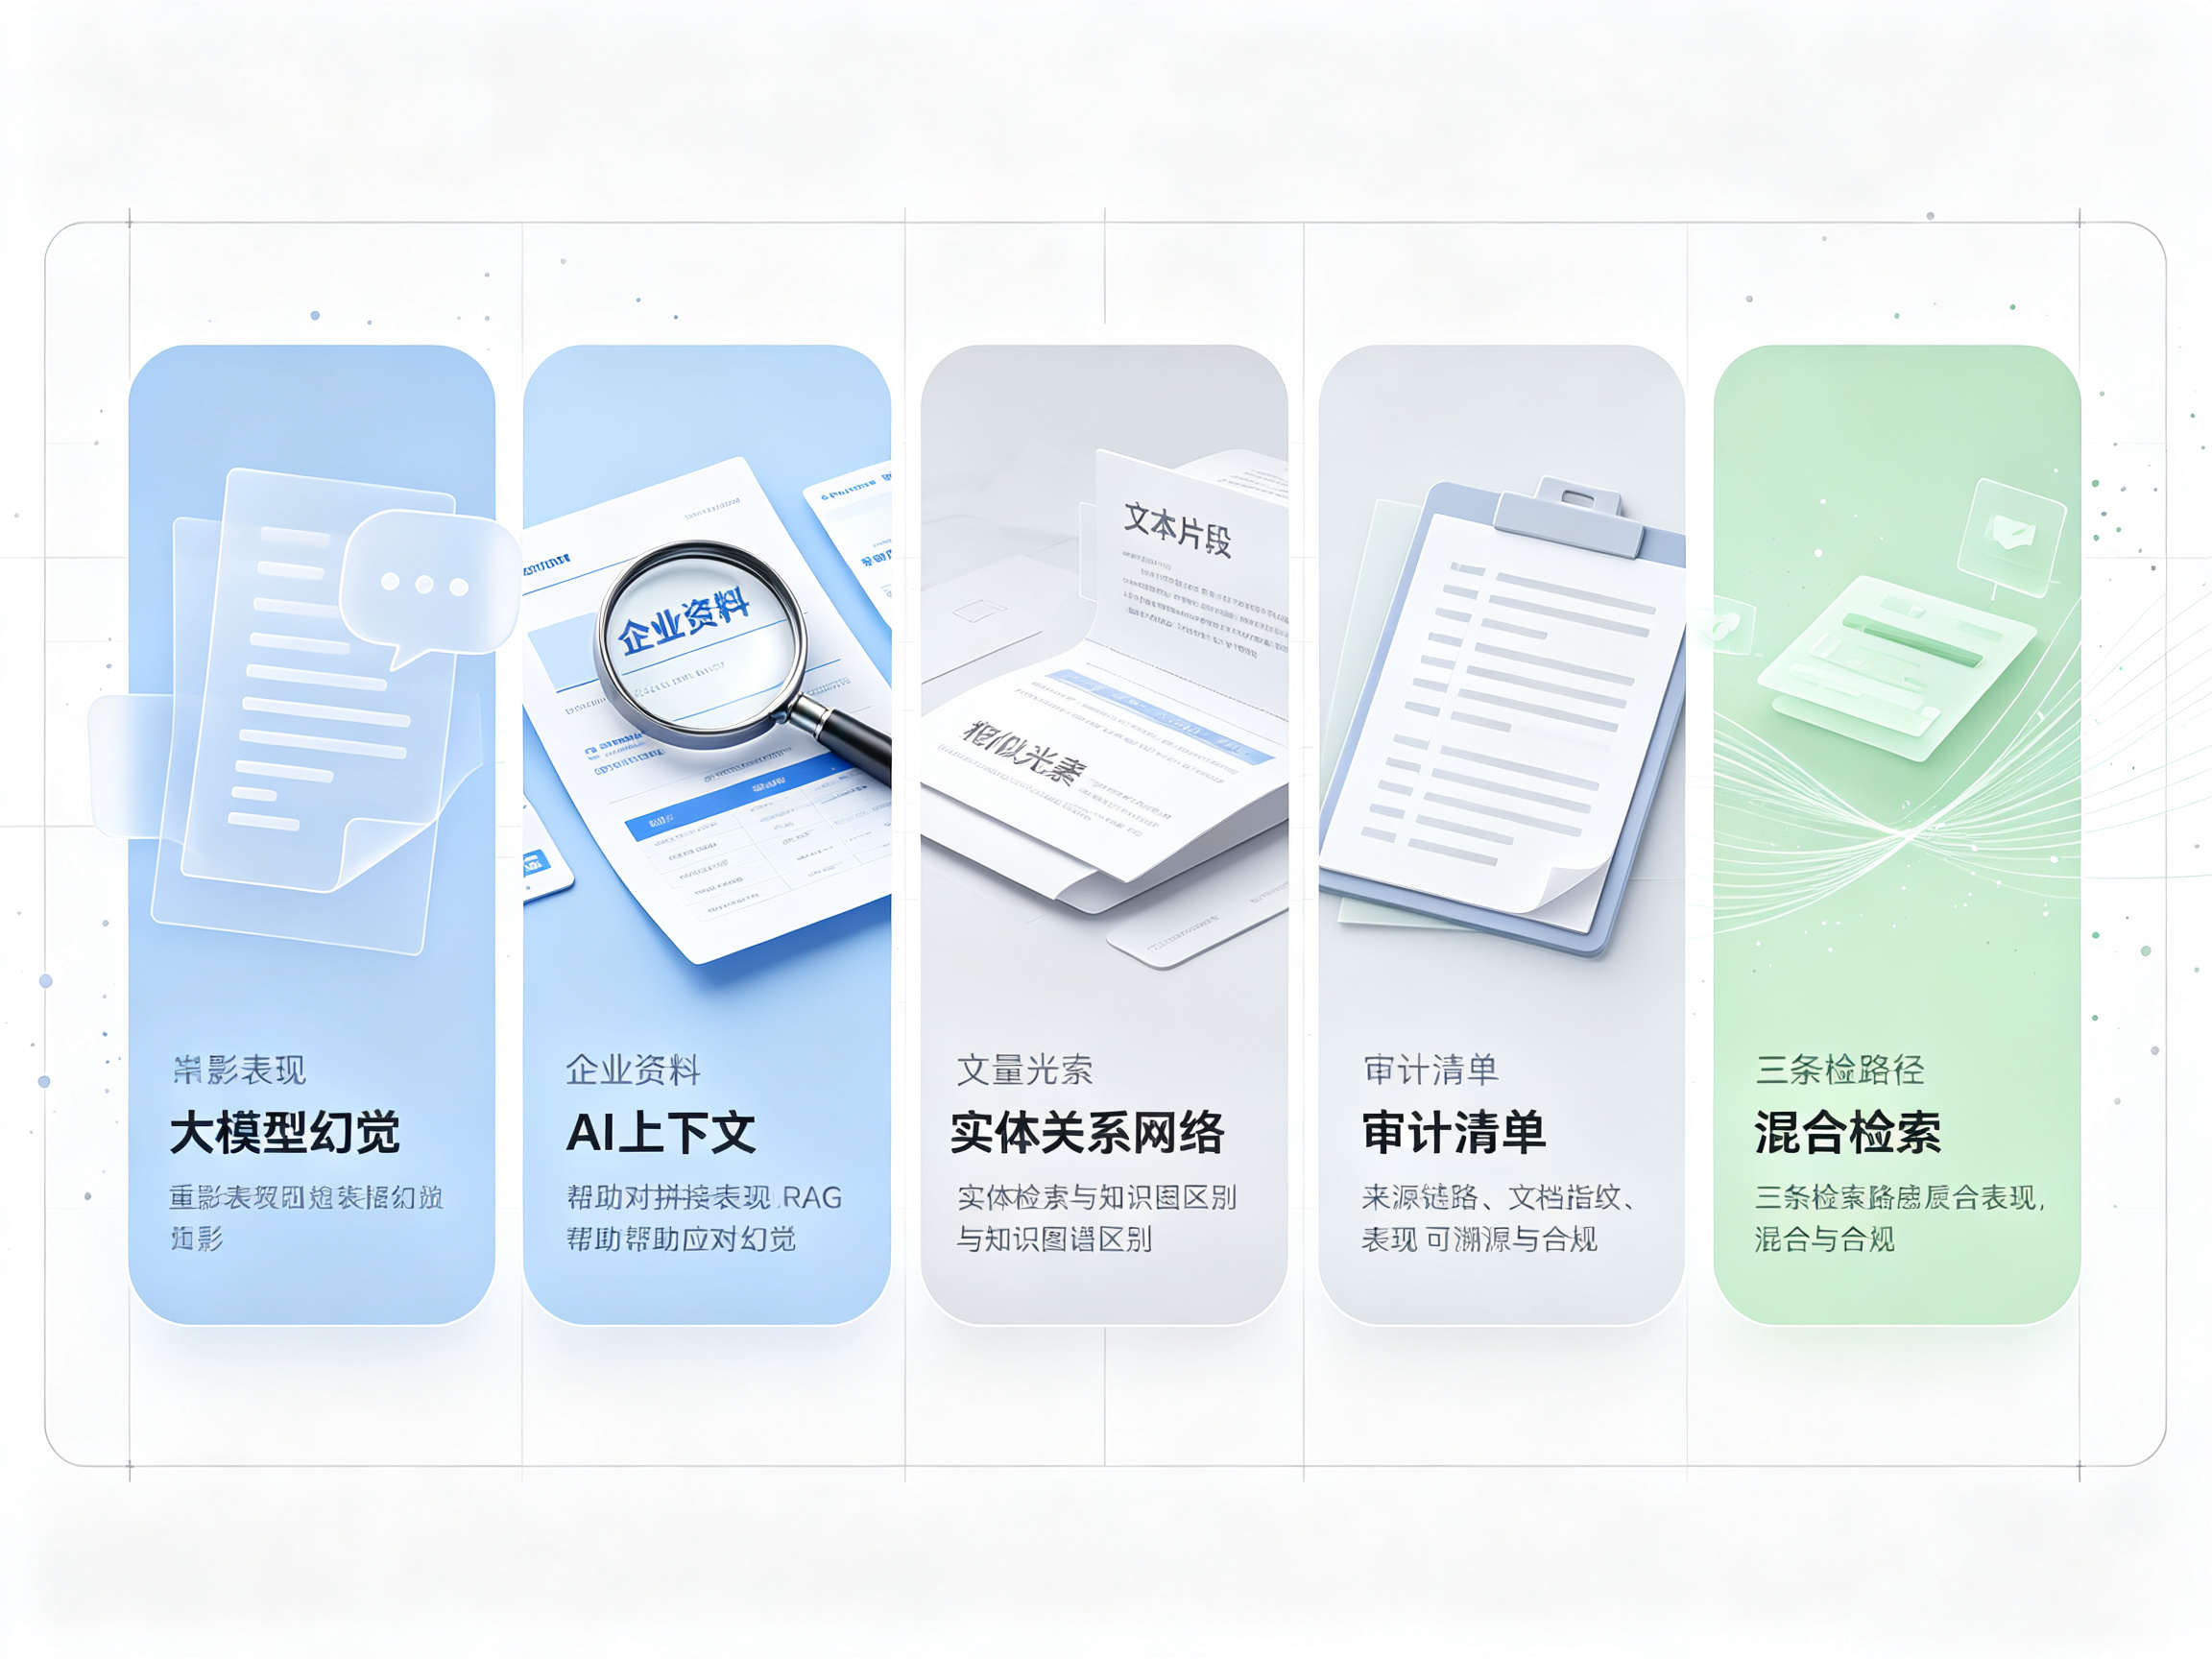
常见问题
问:什么是大模型幻觉? 答:模型输出了与事实或给定材料不符的内容。术语借用自医学,原指人清醒时感知到不存在的事物。
问:RAG如何帮助应对幻觉? 答:它在生成前先从企业资料检索相关内容作为上下文,答案受真实文档约束,有助于提升回答的准确性。
问:知识图谱和向量检索有什么区别? 答:向量检索按语义相似度找文本片段,知识图谱按实体关系找逻辑联系,两者互补。
问:企业AI回答为什么要可溯源? 答:审计和合规要求指认依据,在审计、合规要求较高的业务场景中,难以直接采用”,责任因此难界定。
问:混合检索包含哪几种方式? 答:混合检索把向量、全文、图谱三种检索合在一起,弥补各自短板。
更多推荐



 7
 0
- 0


 已为社区贡献7条内容

所有评论(0)