
【专栏开篇】从底层控制理论到前沿大模型 —— 前言
写在前面
在过去两年的大学生涯里,我从最开始扎进嵌入式学习,到实习时接触时序算法、参与具身机械臂的研发,再到如今深入学习控制原理和控制算法。某天在工位突然停下来想:这两年像散点一般的知识,是否能像穿针引线一样编织成属于我自己的知识体系?
于是我结合自己过往的学习积累,加上现在乃至未来深入学习冒出来的新感悟,打算开一个新专栏——《从底层控制理论到前沿大模型》。一方面是给自己做总结巩固并补全延伸自己的知识边界;另一方面也分享出来,和大家一起讨论,共同进步。
和大众分类的内容不太一样,本专栏完全依据自己的知识脉络整理,一共分成五部分:控制理论、控制算法、嵌入式、机器学习、大模型。这五块并非平行铺开的,而是螺旋上升的关系。我会先搭起整体框架,再带着具体问题往每一层里了解,来回循环着加深理解。
一、五层知识的整体脉络
先聊最核心的主线。从控制理论一路走到大模型,其实有一条特别清晰的演进逻辑:
从最开始只求系统能稳住,到追求控制得最优;从解决算法怎么落到硬件上,到升级成直接从数据里学规律,最后一步步走向通用智能。
每往上走一层,都是上一层的升维,同时又是下一层的底子。缺了哪一步,上面的东西都是空中楼阁。
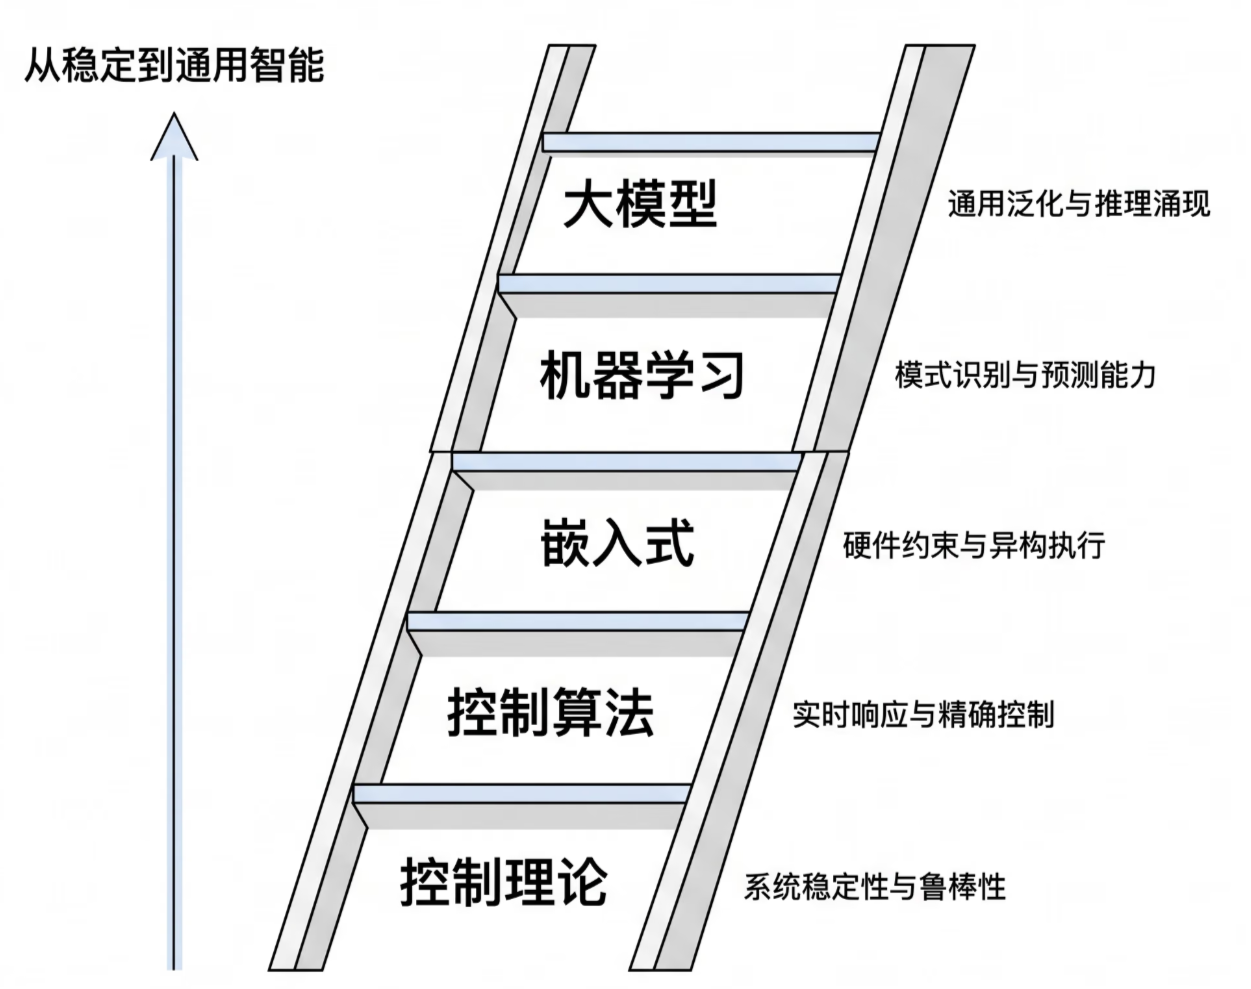
图1 五层技术知识体系演进全景
简述一下每一层在解决什么问题:
- 控制理论:先回答最根本的定性问题——这个系统能不能控、能不能观测、能不能稳定。这是所有后续工作的前提,系统本身不可控不收敛的话,再精妙的算法都没有设计的意义。
- 控制算法:在能控的基础上,研究怎么控最好。是能耗最小、响应最快,还是抗干扰能力最强。把控制问题转化成优化问题,去追求定量的最优性能。
- 嵌入式:把数学里推导完美的算法,真正落到硬件上跑。算力够不够、实时性能不能保证、功耗能不能接受、恶劣环境下稳不稳——这些是工程落地的必要环节。
- 机器学习:当系统复杂到写不出精确模型的时候,换个思路:不研究机理而是直接从数据里学规律。绕开了人工建模的瓶颈,也打开了新的范式。
- 大模型:当模型、数据、算力都堆到一定规模,就从一个任务一个模型的专用模式,变成了一个模型解决一堆任务的通用模式,涌现出了很多小模型没有的能力。
二、贯穿五层的三条主线
梳理时有感,这五层看似跨了好几个领域,实则有三条线索从头到尾串着。
第一条:反馈回路的进化
从最底层的控制环到最高层的大模型智能体,本质上都是一个反馈环路。区别只是环的复杂度越来越高,能处理的问题越来越复杂,但响应速度也越来越慢。
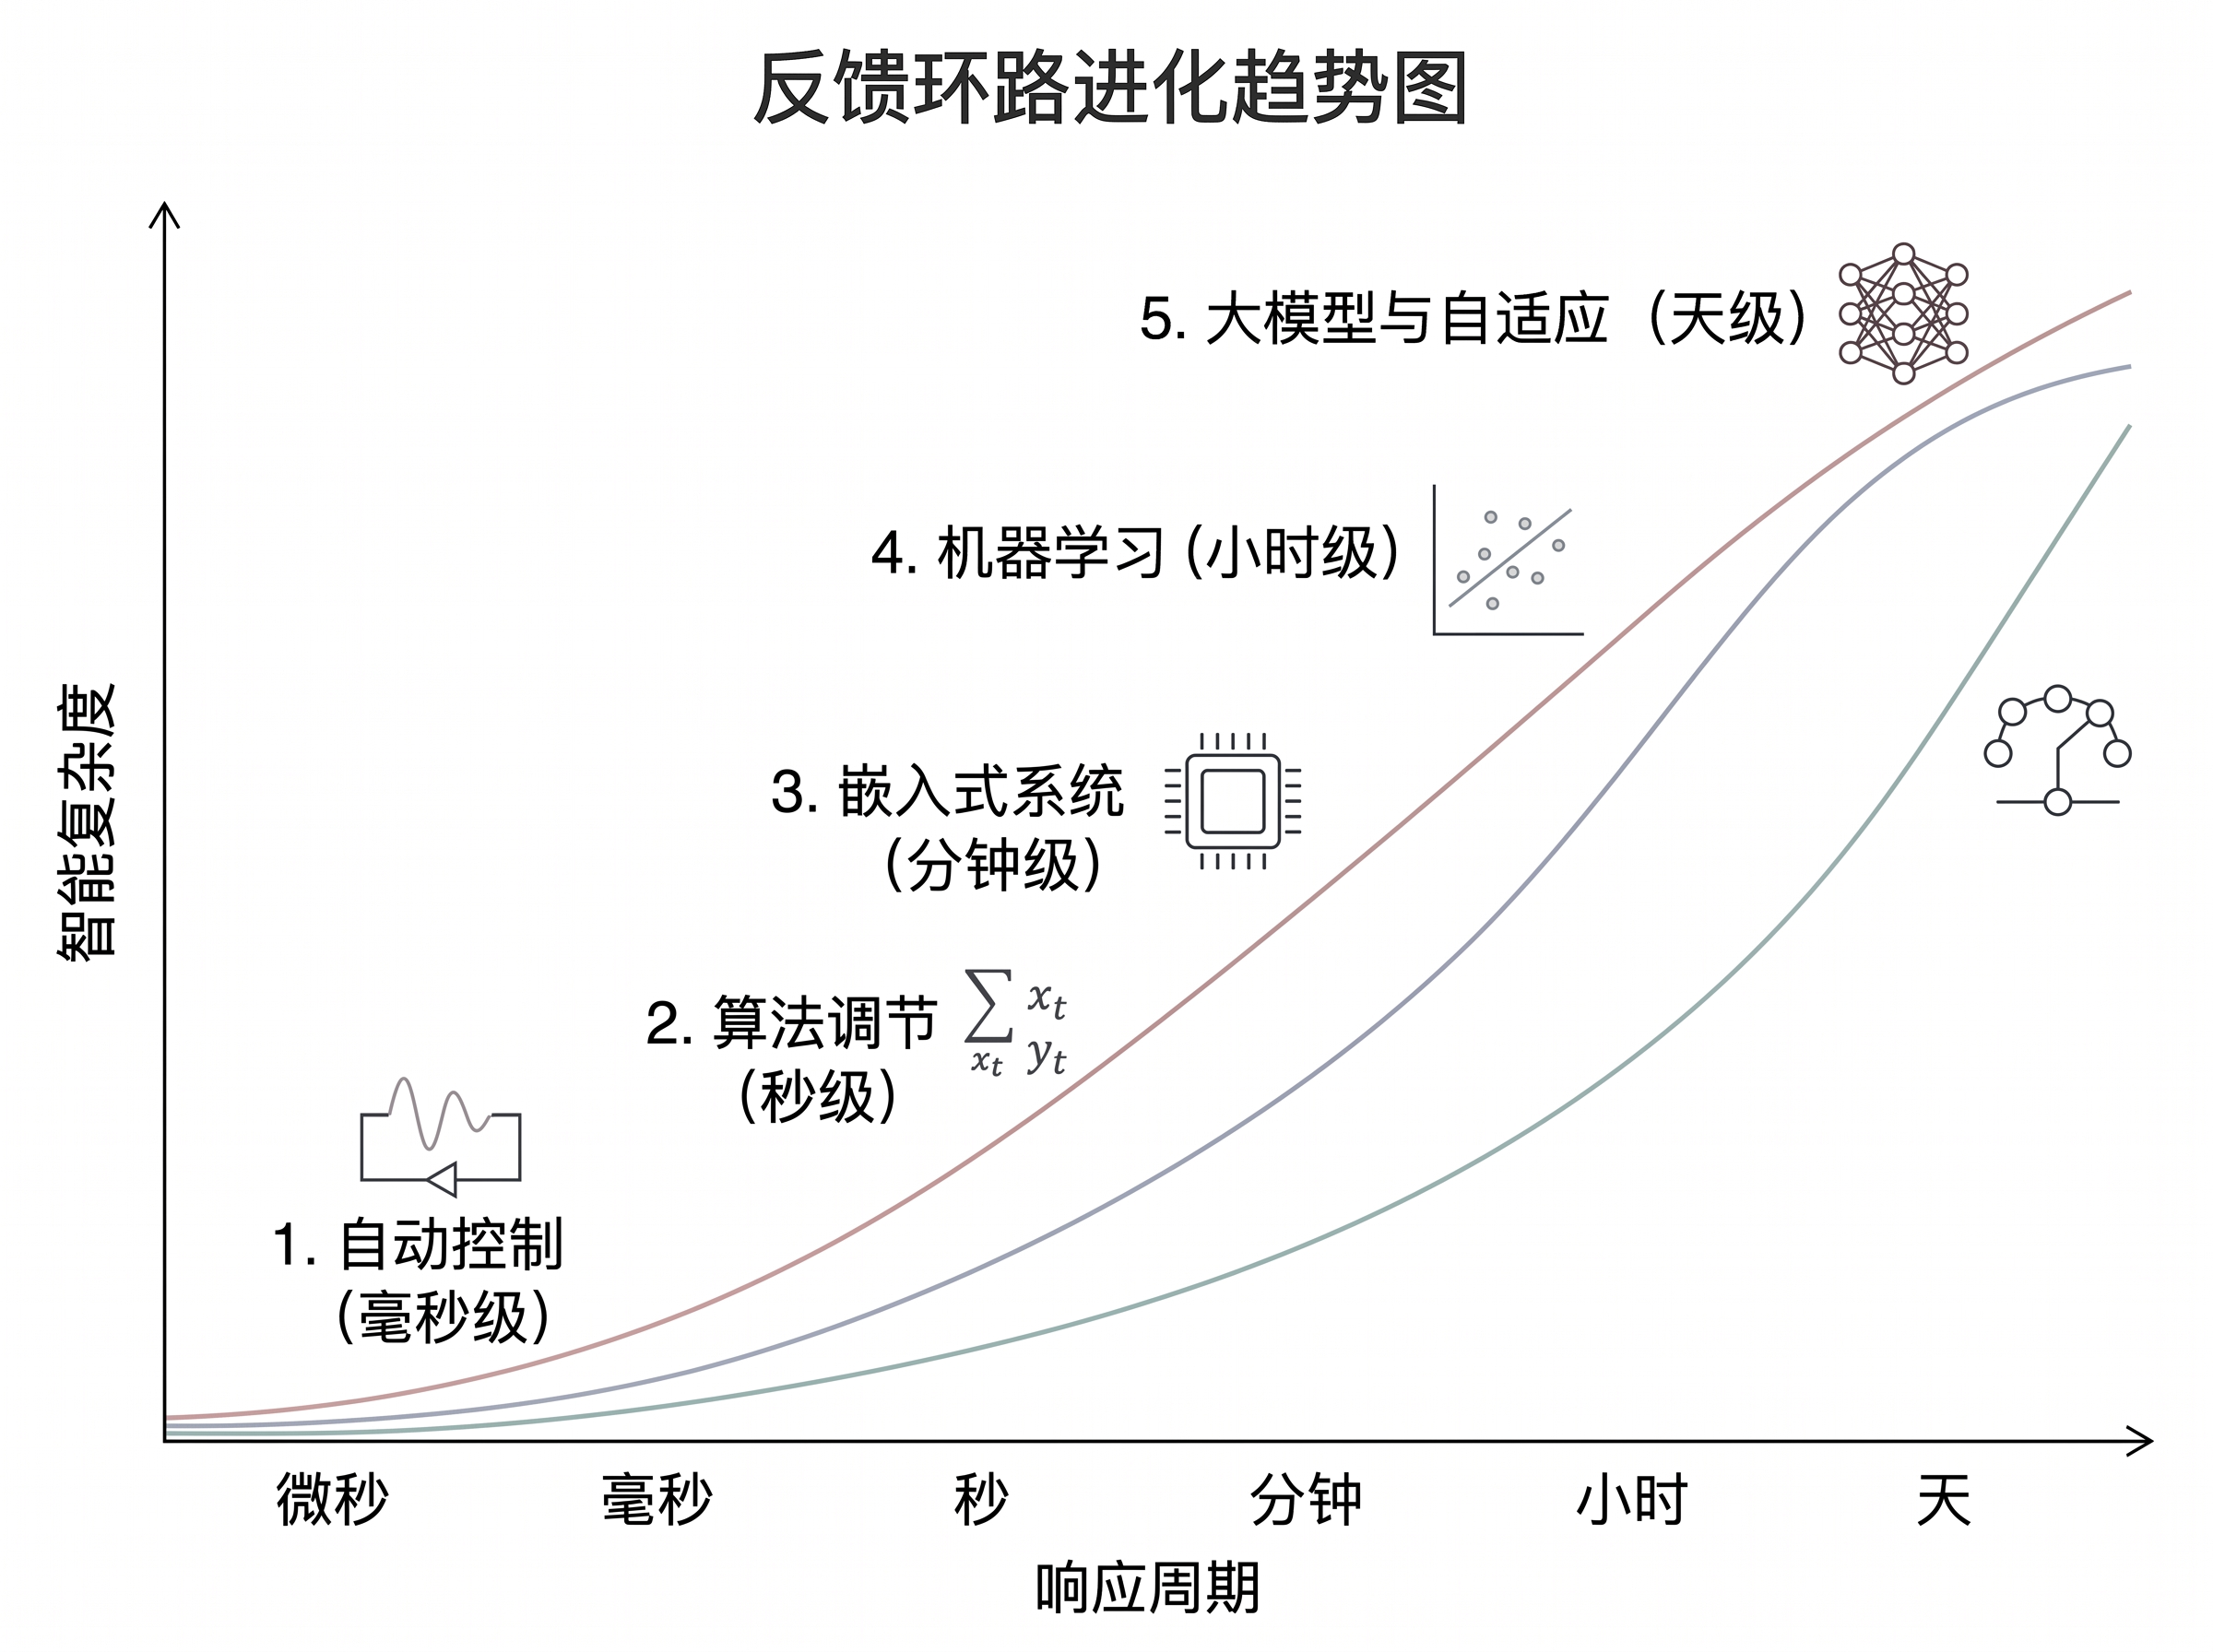
图2 反馈环路的速度与智能度对应关系
具体到每一层:
- 控制理论层是最基础的负反馈闭环,微秒到毫秒级响应,用来处理简单的线性控制;
- 控制算法层是状态反馈搭配观测器,毫秒级响应,核心是实现最优控制;
- 嵌入式层是采样、计算、输出的硬件闭环,同样是微秒到毫秒级,优先级最高的是实时确定性;
- 机器学习层是训练迭代加反向传播的循环,响应周期从秒到小时级,做的是数据规律的拟合;
- 到了大模型Agent层,就变成了观察、思考、行动的完整循环,周期从秒到天级,用来解决复杂的推理决策问题。
这里有个很有意思的规律:反馈越快的环路越简单,越慢的反而越智能。
第二条:不确定性处理的升维
所有技术本质上都是在和不确定性交手,但每一层面对的不确定性,性质完全不一样。从下往上,不确定性从物理问题,慢慢变成了偏认知层面的问题,应对思路也从硬件兜底变成了代码引导。
最底层的控制和嵌入式,面对的是物理不确定性——传感器噪声、外界扰动、硬件参数漂移、时延抖动。应对方式很直接:留鲁棒裕度、做硬件冗余、按最坏情况设计,就是硬保障。
到了中层的机器学习,面对的是数据不确定性——采样有偏差、分布会偏移、数据里有噪声。核心是保证泛化能力,靠正则化、数据增强、泛化理论来应对,是统计层面的兜底。
再往上到大模型,面对的就是认知不确定性——会产生幻觉、输出不符合人的预期、推理会跳步出错。这时候没法靠硬规则卡死了,只能靠对齐、检索增强、思维链这些方式去引导,往人类想要的方向修正。
越往底层,越依赖数学证明和物理约束;越往高层,越依赖统计规律和人的引导。
第三条:优化目标的升级
每一层其实都在做优化,但优化的目标越来越复杂,约束也越来越多元。
控制理论层的优化目标很纯粹,就是稳定性和稳态误差,约束全来自系统本身的物理极限;
到控制算法层,目标变成了二次型性能指标最小化,多了状态和输入的约束;
嵌入式层的优化就更务实了,要在实时性、可靠性、低功耗之间权衡,约束全是硬件资源、成本、环境这些实打实的工程限制;
机器学习层的核心目标是泛化误差最小,约束在模型容量和数据规模;
而大模型层的目标已经变成了通用能力、对齐度、推理效率的综合优化,约束也升级成了算力、数据、安全合规这一套更宏大的命题。
越往上走,问题越接近真实世界的样子——没有单一的最优解,永远是多目标的权衡。
三、一点延伸思考:技术演进里的辩证规律
1. 对立统一:内在矛盾是跃迁的根本动力
每一层都有一对绕不开的核心矛盾,正是这对矛盾的张力,推着技术往下一层走。
- 控制理论:建模必须近似,但近似带来的误差又会威胁稳定性。这对矛盾推着控制从定性判稳,走向了定量处理不确定性的控制算法阶段。
- 控制算法:追求极致最优就对模型误差特别敏感,追求鲁棒保底又会牺牲性能上限。这对矛盾逼着算法走出数学理想国,去直面硬件时延、精度限制这些现实问题,也就落地到了嵌入式工程。
- 嵌入式:硬件资源永远有边界,但对性能的需求一直在涨。这对矛盾最终突破了人工写规则的路子,催生出了靠数据自动学策略的机器学习。
- 机器学习:拟合精度和泛化能力此消彼长,单任务专用模型总有瓶颈。这就推动了大规模预训练+下游适配的大模型范式。
- 大模型:规模越大、能力越强,可控性和对齐难度就越高。这对矛盾到今天也还在推着对齐技术往前走。
矛盾不是坏事,它就是技术往前走的内生动力。
2. 量变质变:规模攒够了,范式就变了
每一次层级跃迁,都不是简单的线性升级,而是量积累到临界值,突然发生的范式质变。我们常说的大模型涌现,就是最典型的例子。
- 从经典控制到现代控制:系统从单输入单输出变成多输入多输出,只是维度规模变了,结果方法论直接从传递函数的黑箱视角,变成了状态空间的白箱视角。
- 从嵌入式到机器学习:传感器数据本来只是控制环的输入,攒得多了就变成了训练模型的原料。数据的规模和用途变了,整个范式就从人工写规则变成了数据学规则。
- 从深度学习到大模型:参数量、数据量、算力一路堆,堆到某个阈值,多步推理、编程、数学解题这些小模型完全没有的能力突然就冒出来了,从专用拟合器直接变成了通用推理引擎。
3. 否定之否定:螺旋上升的闭环迭代
其实贯穿全程的反馈,本质就是一次次的否定修正,螺旋着往目标靠。
- 最底层的PID负反馈,用当前偏差修正输出,就是最朴素的否定之否定。
- 机器学习的反向传播,用损失去修正参数,每一轮迭代都是对上一轮参数的扬弃——留下合理的,修正偏差的。
- 大模型Agent的观察-思考-行动循环,用行动结果修正之前的规划,靠自我反思迭代策略,就是最高阶的辩证否定。
放大到整个范式跃迁也是一样:机器学习否定了控制理论的显式建模范式,但反馈、优化这些核心的东西全保留下来了;大模型否定了传统机器学习单任务专用的路子,但深度学习、梯度下降这些基础全继承了。
每一次否定都不是全盘推翻,而是克服旧的局限,留下核心内核,再抬到更高的层级去。
In the end:关于专栏的一点想法
以上只是本人的个人思考和感悟,在接下来的不断学习中会有新的思想和行动,后面我会慢慢更新每一层的具体内容,欢迎大家评论区指正,一起讨论进步。
更多推荐


 31
 0
- 0


 已为社区贡献2条内容

所有评论(0)