
大模型蒸馏,到底是技术优化还是偷窃?Anthropic的指控,把AI行业最难的边界摆上台面
 同一种技术。
在研究论文里,叫“知识蒸馏”。
在模型厂商的指控里,却可能被叫作“能力窃取”。
真正的分界线,不在“蒸馏”两个字,而在数据怎么来的、协议是否允许、最终拿它做什么。
2026年,Anthropic再次把大模型蒸馏推到行业争论中心。
它公开指控DeepSeek、Moonshot和MiniMax通过大规模异常账号与代理网络获取Claude输出,用于提升自己的模型能力。
Anthropic给出的数字非常大。
超过1600万次Claude交互。
约2.4万个虚假账号。
但Anthropic在同一篇官方文章里,也说得非常清楚:
蒸馏本身是一种广泛使用、而且可以完全合法的训练方法。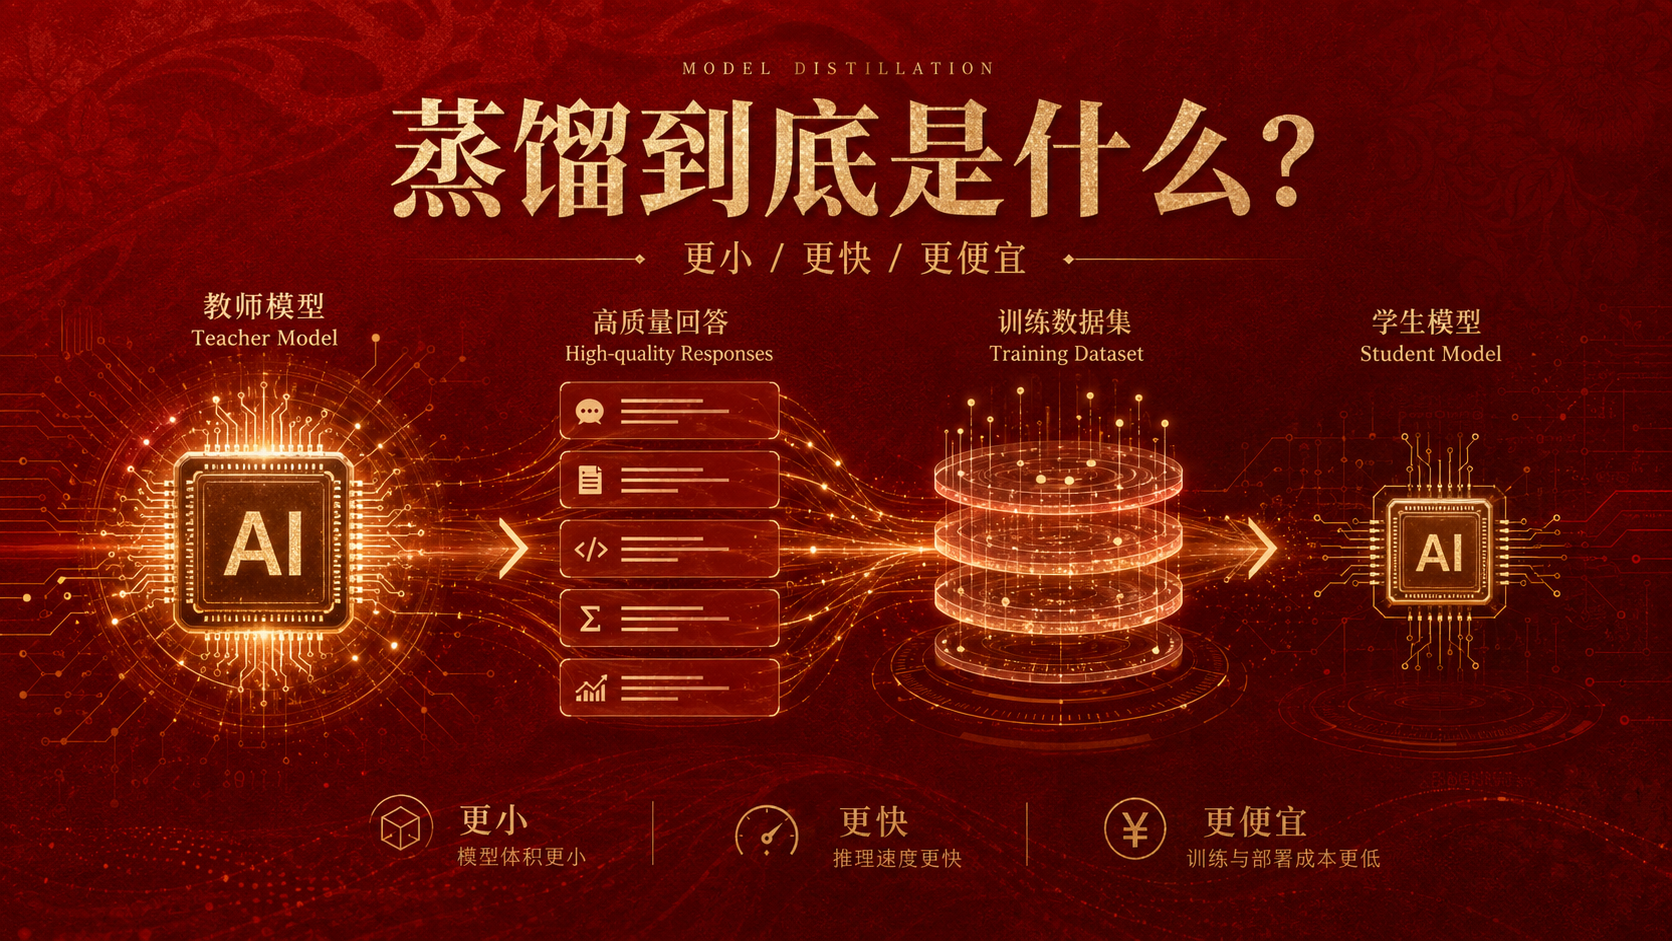
真正发生冲突的,是工业规模提取闭源模型输出、绕过访问限制,以及把这些数据用于训练竞争模型。
先把一个最容易混淆的问题说清楚
“模型蒸馏”不等于“复制模型权重”。
传统知识蒸馏通常让学生模型学习教师模型的软标签、概率分布或中间表示。
而围绕闭源API发生争议的场景,很多更接近“利用教师模型输出构造大规模合成训练数据”。
两者常被统称为Distillation,但在数据来源、访问方式和合规风险上并不完全相同。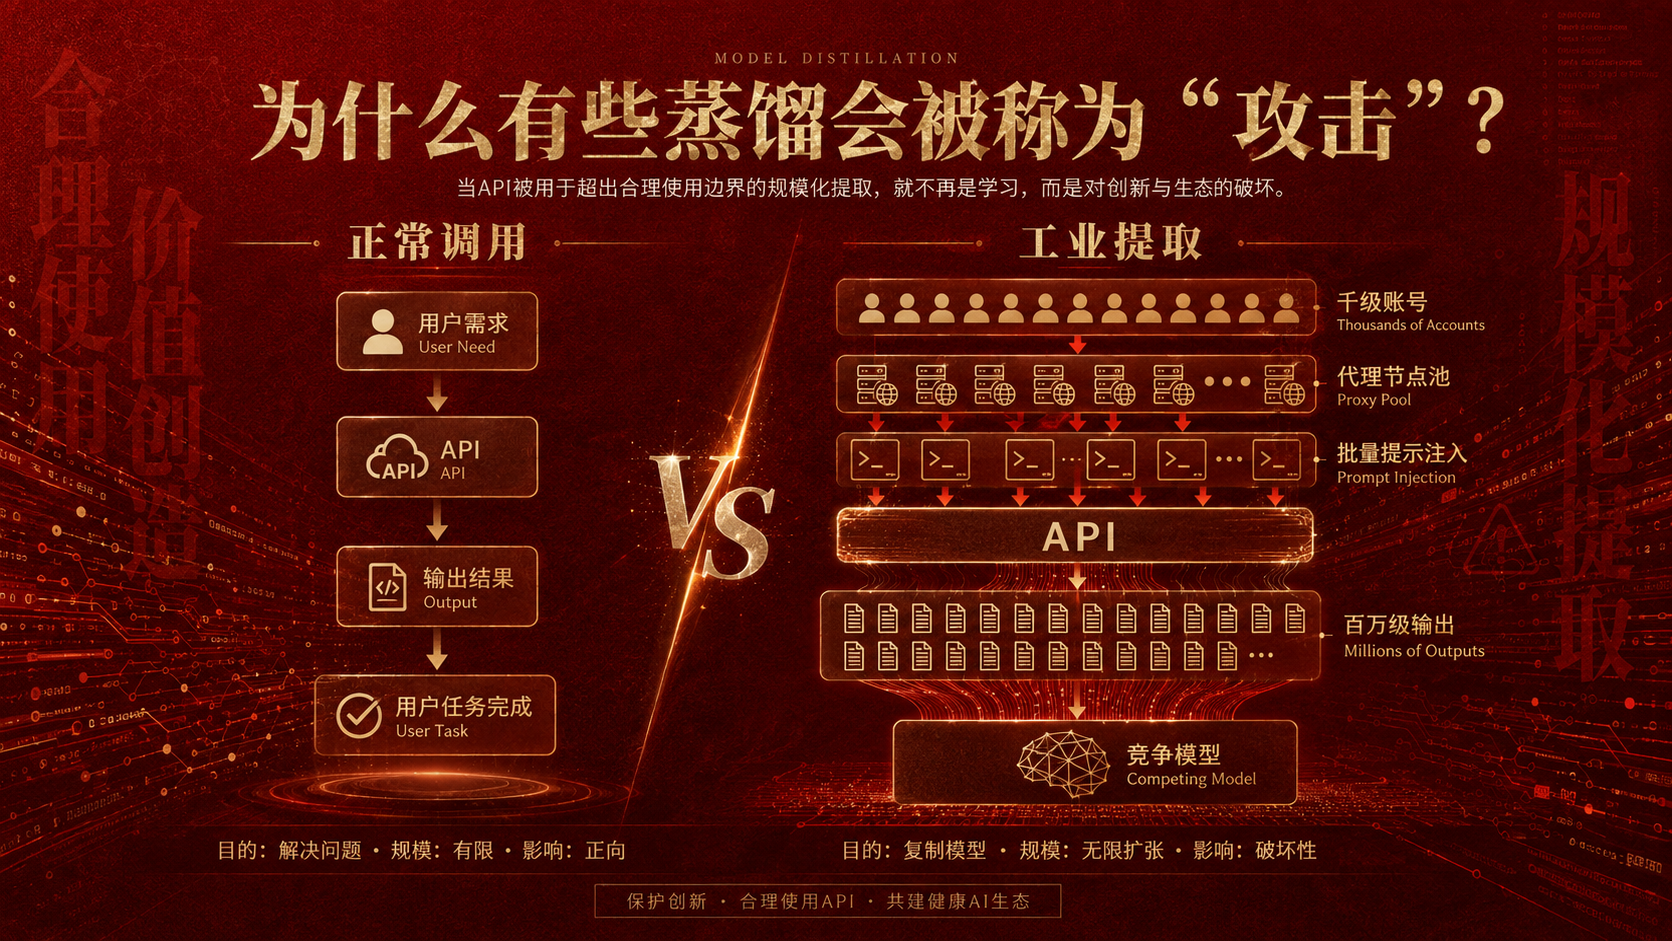
01|蒸馏到底是什么?先别急着谈“偷”
最简单的理解是:一个能力更强的模型当教师,一个更小、更便宜或者更专用的模型当学生。
学生不直接复制教师的参数文件。
它学习的是教师在大量任务上的输出规律。
Teacher Model
      ↓
Questions / Tasks
      ↓
High-quality Responses
      ↓
Training Dataset
      ↓
Student Model
      ↓
Smaller / Faster / Cheaper
这类方法存在很多年了。
它的正常用途也非常广。
把大模型压缩成端侧小模型。
把通用模型变成某个垂直领域模型。
降低推理成本。
提高本地部署效率。
因此,如果只看技术名词,蒸馏本身没有天然的道德属性。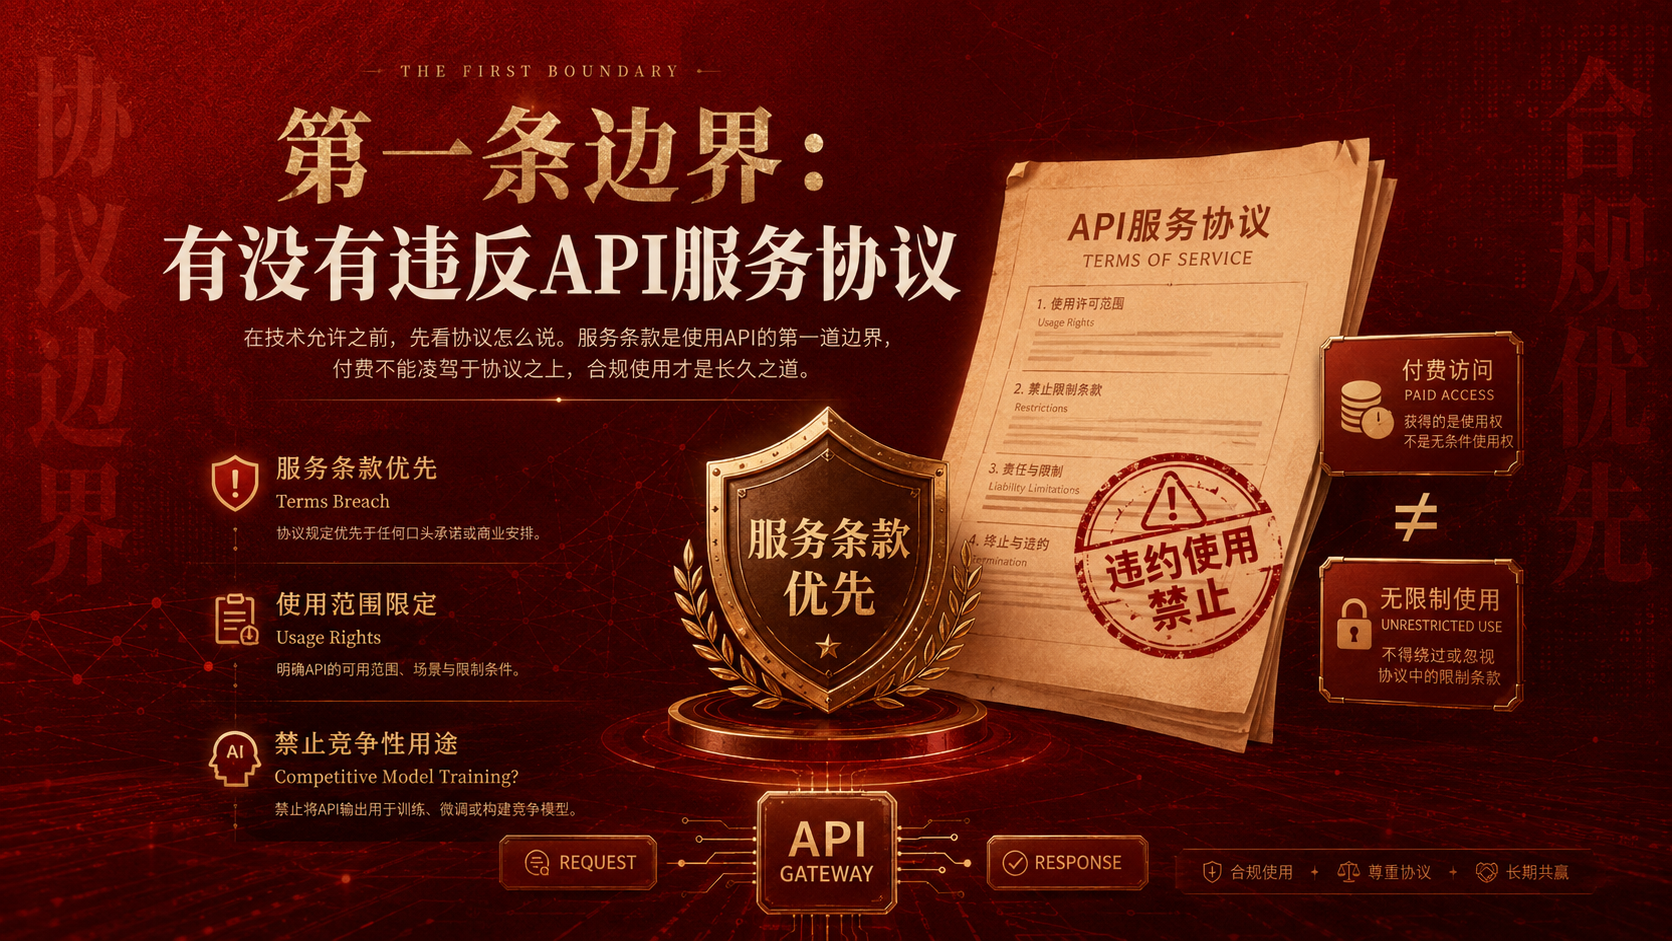
02|为什么Anthropic会把某些蒸馏称为“攻击”?
因为争议根本不在Student Model有没有复制Teacher的权重。
而在训练数据是怎么拿到的。
Anthropic在2026年2月的公开说明中称,它识别到工业规模的Claude能力提取活动。
这些流量通过大量虚假账号和代理服务分散请求。
Anthropic还表示,这些行为违反了它的服务条款和地区访问限制。
Normal API Usage
User Need → API → Output → User Task

Industrial Extraction
Thousands of Accounts
        ↓
Large Prompt Campaign
        ↓
Millions of Outputs
        ↓
Training Dataset
        ↓
Competing Model
这也是“合规蒸馏”和“争议蒸馏”真正开始分开的地方。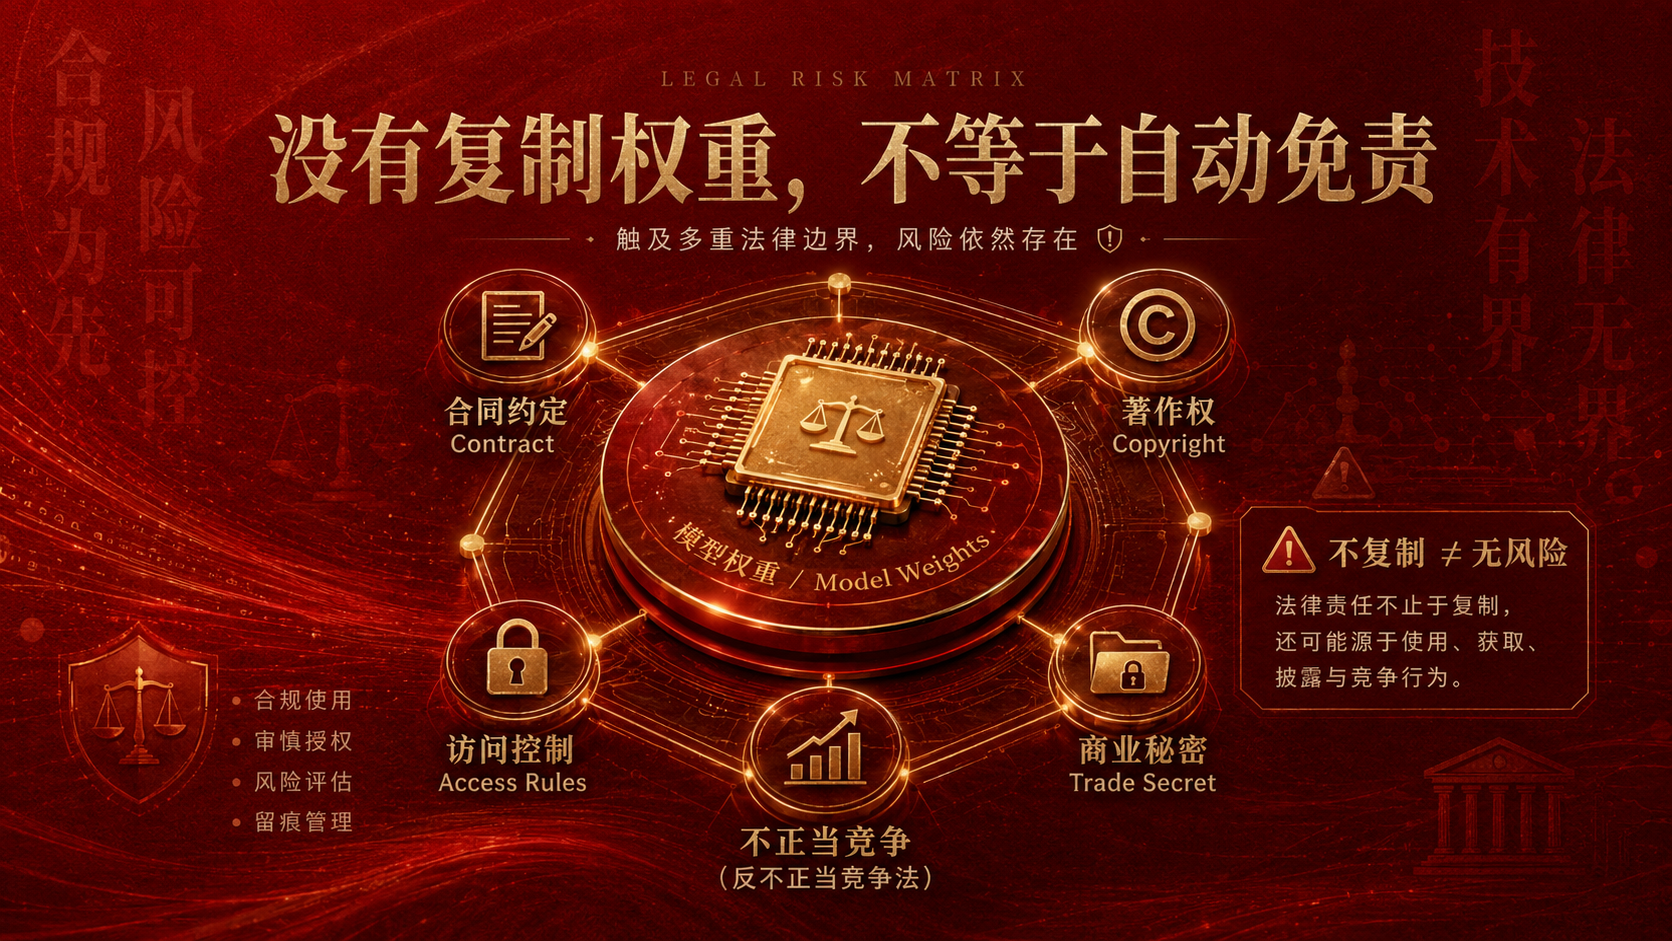
03|第一条边界:有没有违反API服务协议
这是现实中最清晰的一条线。
即使某种技术本身合法,也不代表可以无视服务提供商的合同限制。
Anthropic的商业条款明确限制客户使用Claude去构建竞争产品或训练竞争AI模型,除非得到Anthropic明确批准。
所以,如果一个团队合法购买API,然后违反约定批量生成训练数据,首先出现的可能不是“版权案”。
而是合同、账号滥用、访问限制与商业竞争层面的争议。
DISTILL-101|TERMS_BREACH
教师模型明确禁止将输出用于训练竞争模型,但仍大规模调用API构造训练集,会首先触发服务协议与商业合规风险。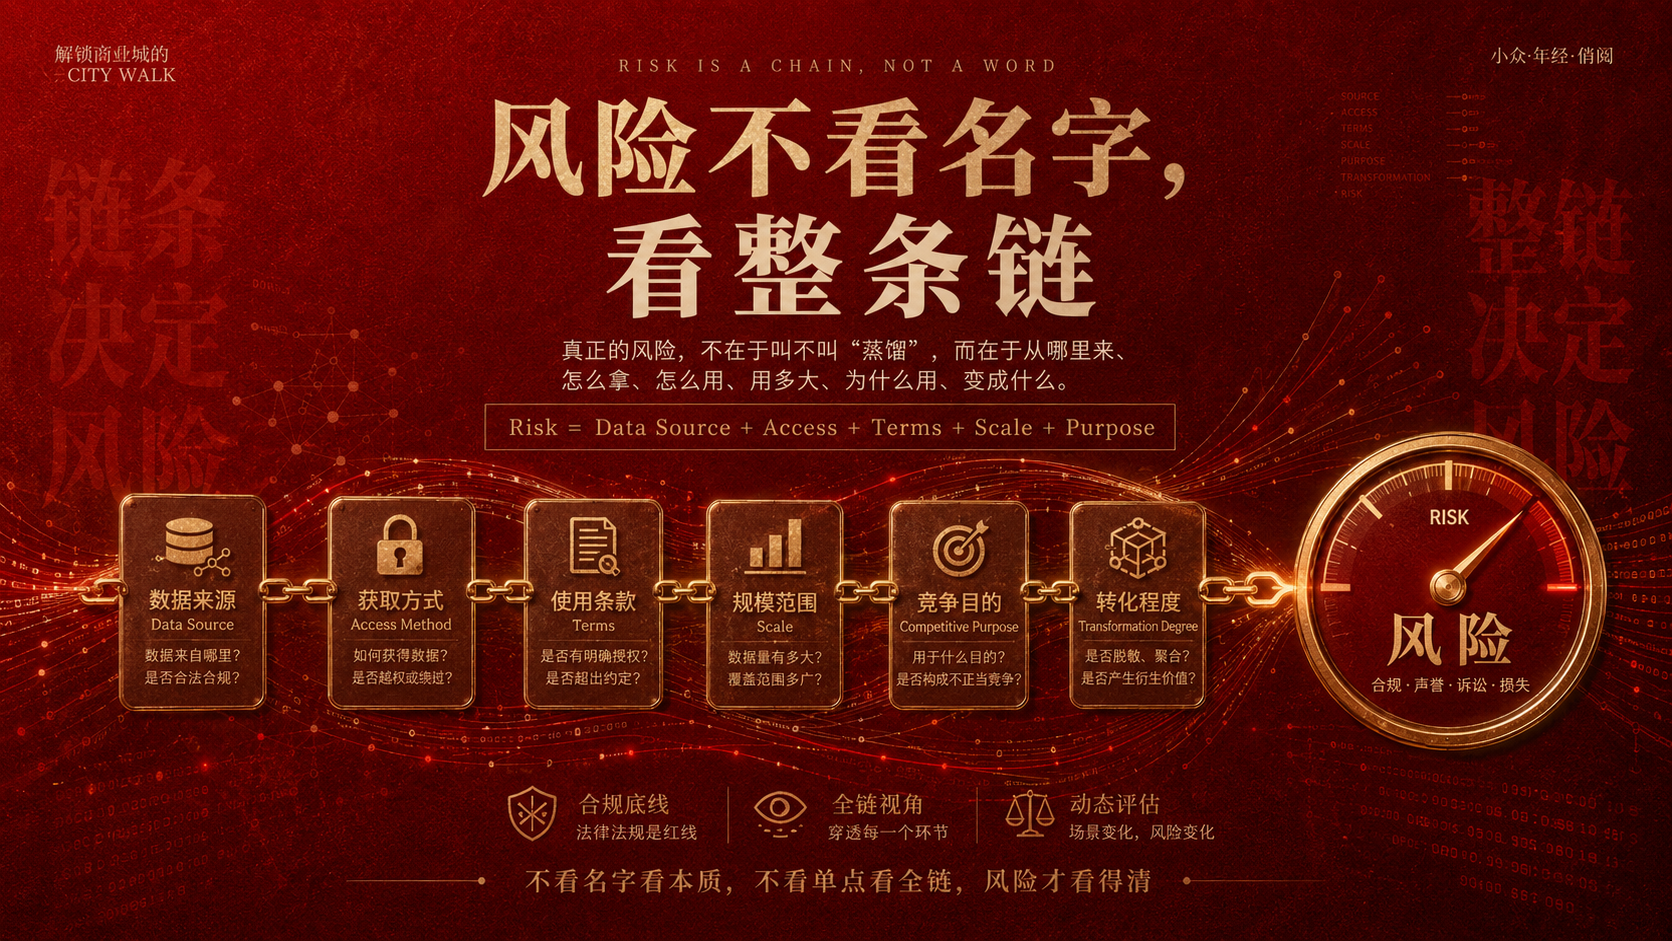
04|第二条边界:没有复制权重,不等于自动免责
网络讨论里经常有一句话:“我又没有拿你的模型权重,怎么算偷?”
这个问题不能只从权重文件回答。
模型权重当然是重要资产。
但现实法律关系还可能涉及合同、版权、数据库权利、商业秘密、反不正当竞争、计算机访问规则以及具体法域的其他制度。
同时,AI输出本身能否获得版权保护,也不能用一句“知识不受版权保护”全部概括。
事实、思想、方法和一般知识通常不能被某一方永久垄断。
但具体表达、受保护内容、数据库选择编排以及合同约定,又可能产生不同问题。
所以“不复制权重”只能回答一个问题,不能回答全部法律问题。
05|第三条边界:你是在做能力迁移,还是在低成本复刻竞品?
这是商业伦理争议最集中的地方。
如果教师模型官方允许蒸馏,使用公开数据集,学生模型还有大量自己的训练数据、结构改造和后训练,最终做出的能力也明显不同,争议通常相对较小。
但如果目标非常明确:批量榨取某闭源模型的高价值输出,专门覆盖它最强的Coding、Reasoning、Agent能力,然后直接训练一个功能高度趋同的商业竞争模型,商业冲突就会非常强。
Risk ≠ Distillation Name

Risk
=
Data Source
+ Access Method
+ Terms
+ Scale
+ Competitive Purpose
+ Transformation Degree
真正需要判断的是整条链,而不是只看技术名词。
06|为什么支持者仍然认为“蒸馏是正常技术”?
因为从机器学习发展史来看,这个判断本身并没有错。
大模型厂商自己也在做蒸馏。
Anthropic在公开说明里同样承认,前沿实验室会把自己的强模型蒸馏成更小、更便宜的模型。
开源社区里也经常使用教师模型生成合成数据,再训练小模型。
尤其是端侧模型、垂直模型、行业模型。
所以把“Distillation”这个技术词整体污名化,并不准确。
07|真正的问题是:教师模型有没有同意
STEP 1|明确授权
教师模型或数据许可证明确允许蒸馏、训练或衍生模型,这是风险最低的路径。
STEP 2|公开数据蒸馏
使用公开数据、开源模型和允许再训练的数据集构造Teacher-Student流程。
STEP 3|授权不明确
模型输出可以正常使用,但条款没有清楚说明能否用于训练竞争模型,需要单独核查。
STEP 4|明确禁止仍批量提取
服务条款明确禁止,却通过批量账号、代理或规避措施持续获取训练数据,风险最高。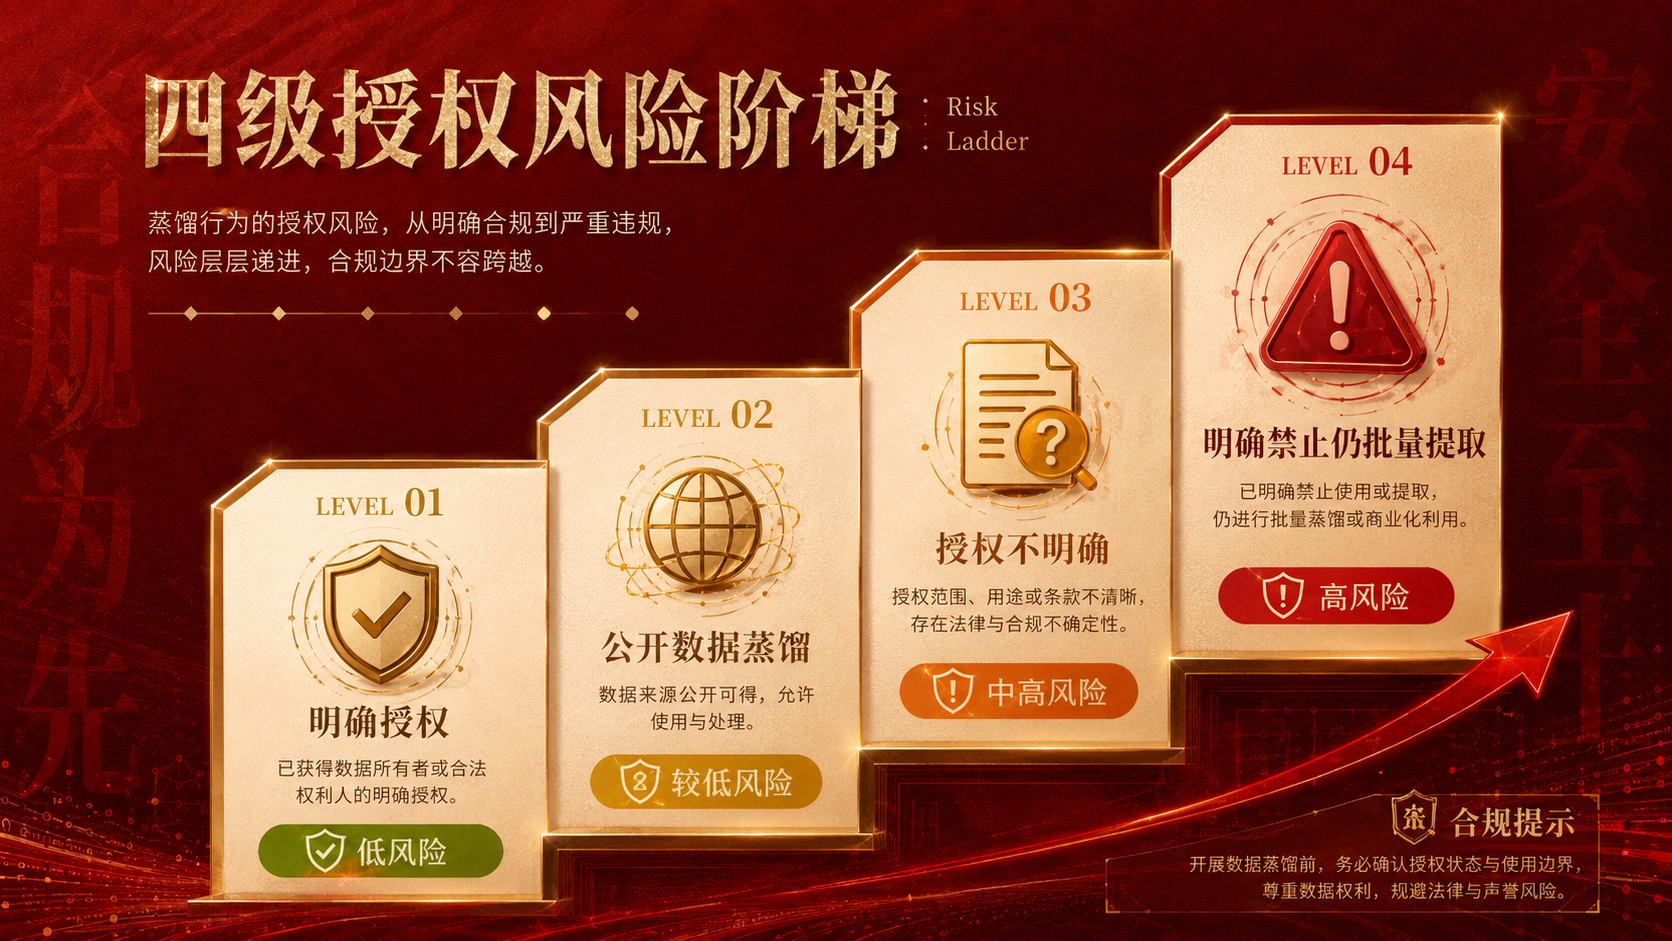
08|为什么“买了API调用量”也不等于“可以买下训练权”
API付费购买的是服务使用权。
它并不自动等于获得所有下游用途的无限授权。
类似云数据库、图库、地图API和金融数据接口。
你可以买调用量,但合同仍然可以限制批量抓取、转售、镜像、训练或建立直接竞争产品。
DISTILL-202|PAID_API_EQUALS_UNLIMITED_RIGHTS
购买API额度只代表获得约定范围内的服务使用权,并不自动包含训练竞争模型、批量镜像或转售数据的权利。
09|法律为什么到现在还没有一个全球统一答案
因为大模型蒸馏同时跨越了太多传统法律概念。
模型参数是软件与数据资产。
模型输出又可能包含事实、表达、代码和推理过程。
API调用同时还是合同关系。
大规模自动访问又可能涉及访问控制。
不同国家对版权、数据库权、合同效力和不正当竞争的制度也不同。
Distillation
≠ Automatically Legal
≠ Automatically Illegal

Need:
Facts + Contract + Data Source + Use Case + Jurisdiction
更现实的判断方式是逐层检查。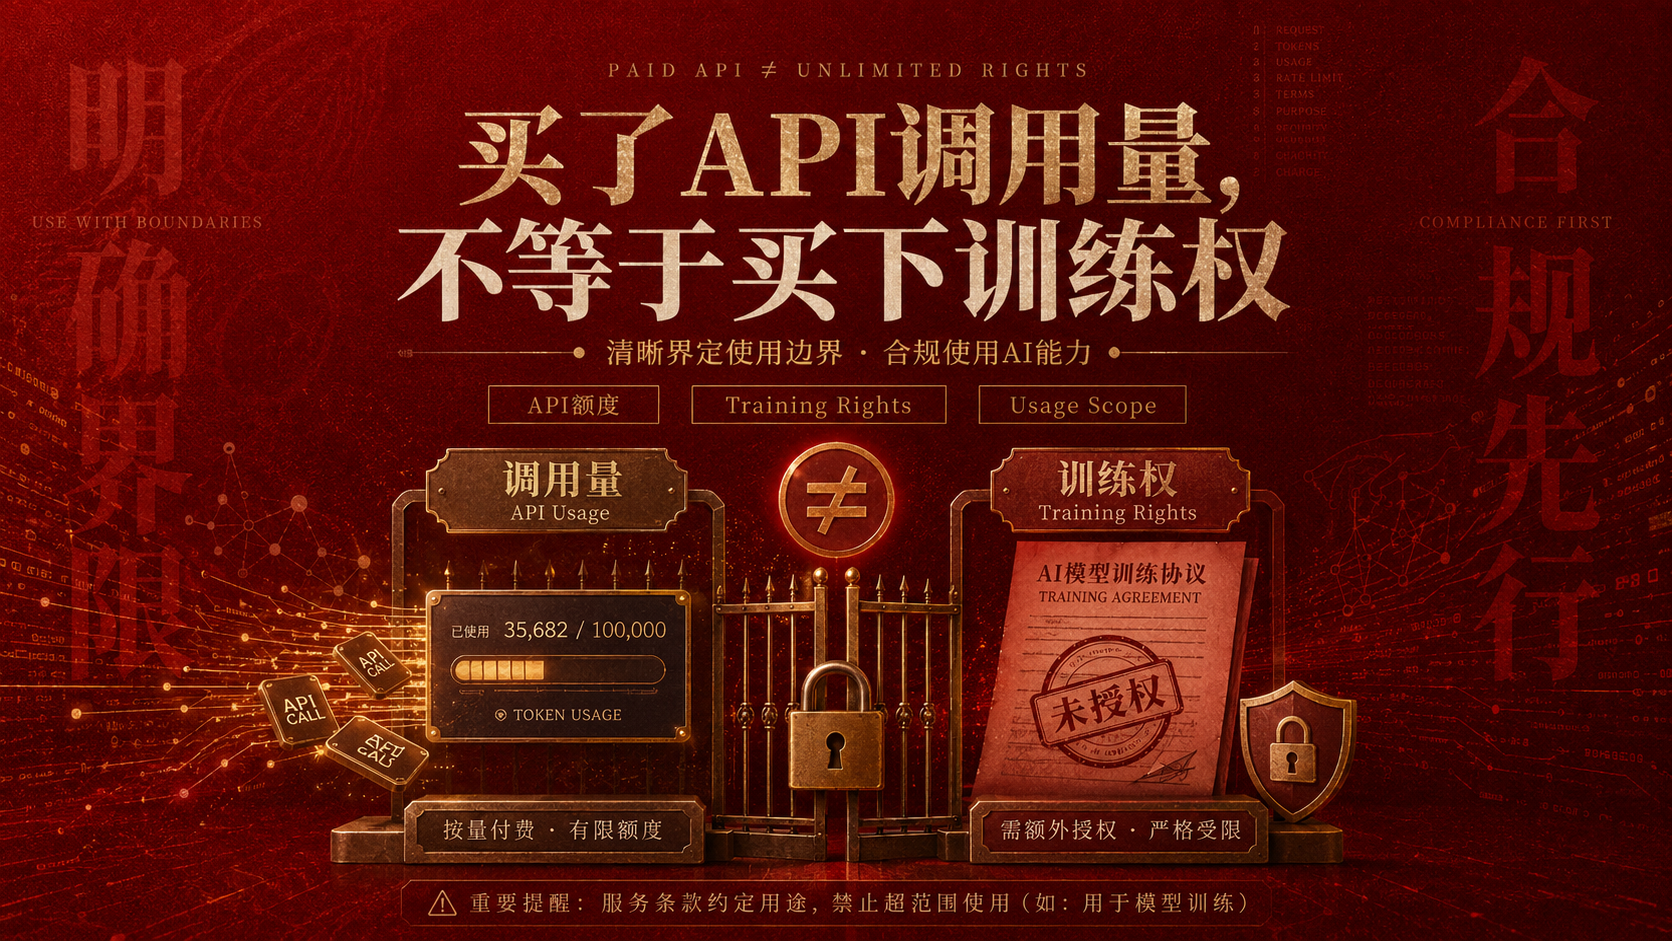
10|一家AI公司如果真的要做蒸馏,应该先检查什么
Distillation Review

1. Teacher License
   ↓
2. API Terms
   ↓
3. Dataset Provenance
   ↓
4. Output Usage Rights
   ↓
5. Competitive Purpose
   ↓
6. Transformation Degree
   ↓
7. Privacy / Personal Data
   ↓
8. Jurisdiction Review
   ↓
9. Audit Log
技术团队最容易犯的错误,是模型已经训练完了,才把法务叫进来。
更合理的方式是训练前就建立Data Provenance。
每一批Teacher Output都应该知道来自哪里、使用什么账号、对应什么许可证或合同、能不能用于训练、能不能商用。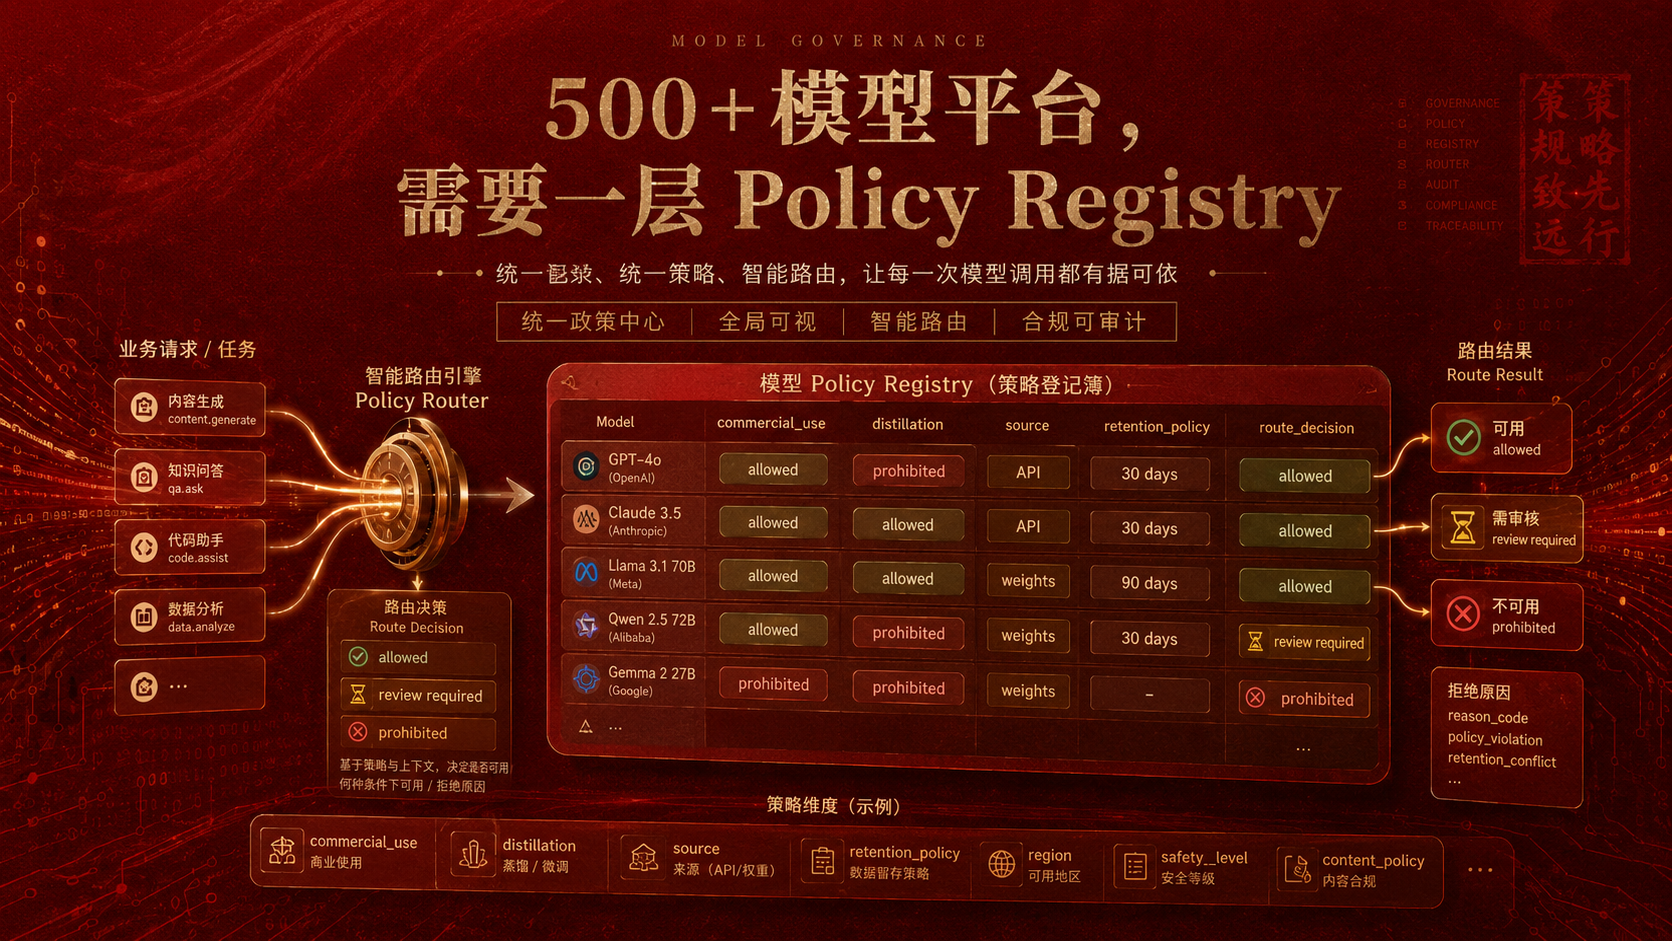
11|对于500+模型平台,这个问题反而更现实
如果一个平台同时聚合500+AI模型,再加上智能体、无限画布、AI漫剧和AI PPT,每天可能同时产生大量文本、图片、视频、音频和代码结果。
这时候最危险的不是“模型数量太多”。
而是不同模型的输出权利和用途限制完全不同。
有的模型允许商业使用。
有的模型允许生成内容,但不允许拿输出训练竞争模型。
有的开源权重允许再训练。
有的API还存在地区、数据留存和二次使用限制。
因此多模型平台真正需要的是一层Model Policy Registry。
Model Registry

Model A
├── commercial_use: yes
├── distillation: allowed
└── source: open_weights

Model B
├── commercial_use: yes
├── distillation: prohibited
├── competing_model_training: prohibited
└── source: closed_api

Model C
├── commercial_use: conditional
├── legal_review: required
└── retention_policy: special
Router不仅要判断哪个模型更强。
还要判断这个任务在合同和合规上能不能交给它。
12|智能体、无限画布和AI漫剧,还要多加一层“用途治理”
智能体会自动调用模型。
无限画布会把多个模型节点串起来。
AI漫剧可能同时调用文案、图像、视频和音频模型。
AI PPT可能把一个模型的输出继续交给另一个模型改写。
如果这些资产未来又被拿去训练自有模型,数据来源链就会变得非常复杂。
所以真正成熟的平台应该保存Asset Lineage。
User Prompt
   ↓
Model A Output
   ↓
Agent Rewrite
   ↓
Model B Image
   ↓
Video Model
   ↓
Final Asset

Every Node:
Model ID
License / Terms Version
Timestamp
Usage Purpose
Training Permission
只有这样,未来真的要构造训练集时,系统才能知道哪些资产可以进入。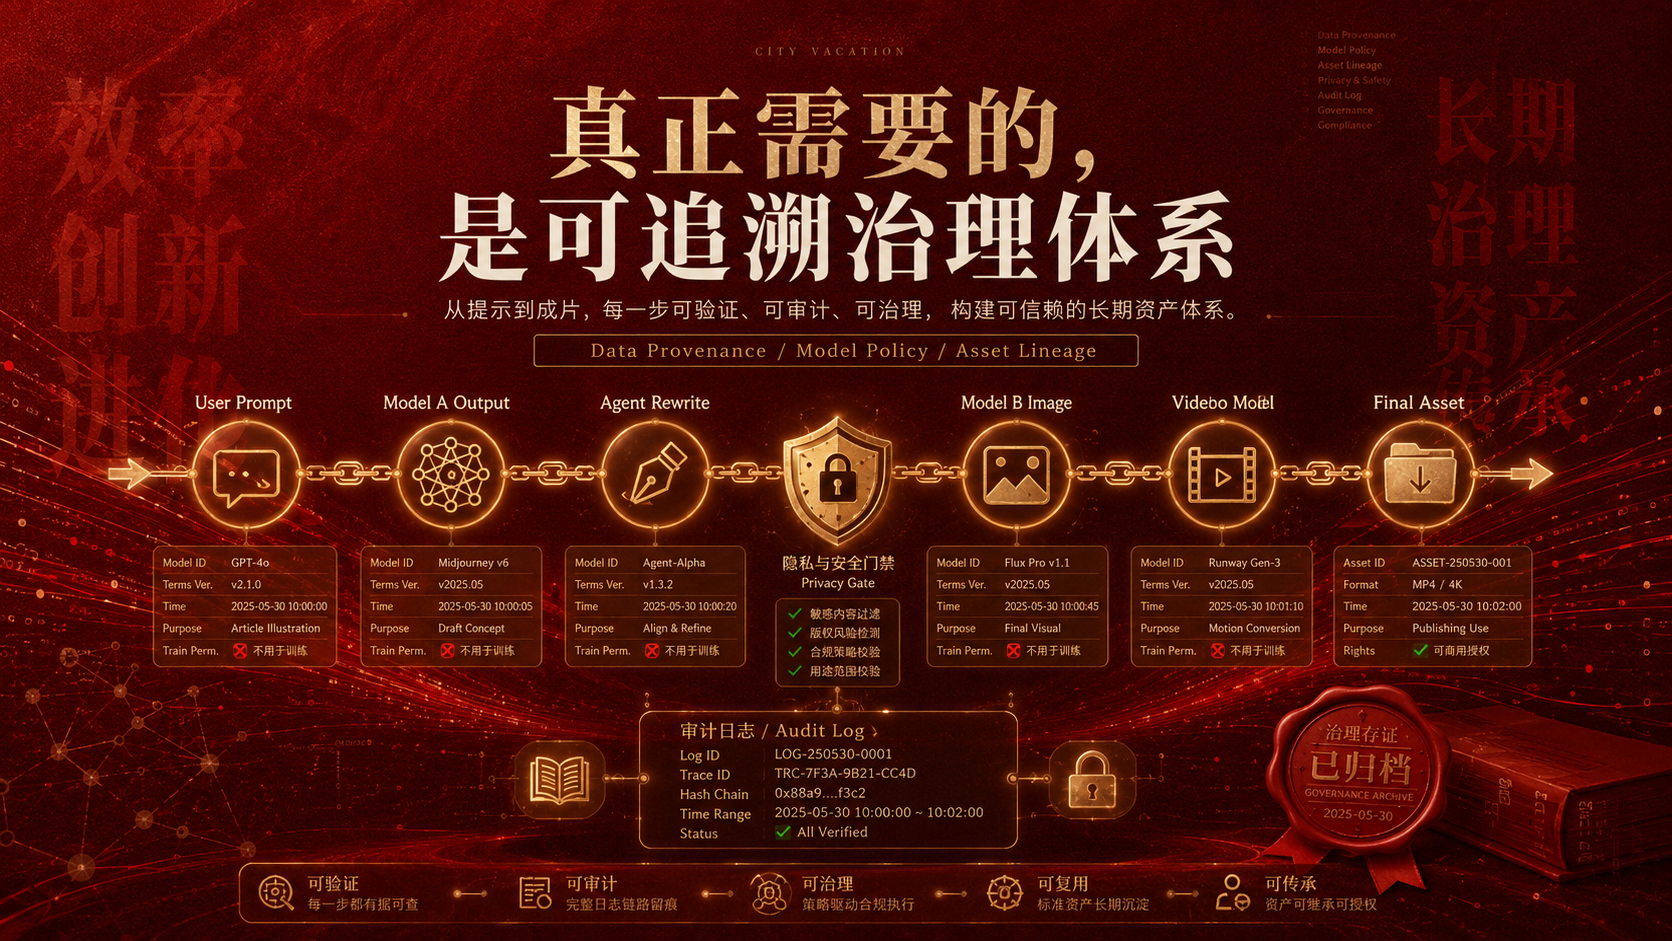
13|五类最常见的高风险做法
DISTILL-301|FRAUDULENT_ACCOUNTS
为了扩大采样规模建立或购买大量虚假账号,绕过正常限流、地区限制或账号控制。
DISTILL-302|PROXY_EVASION
通过代理网络隐藏真实调用主体或规避模型供应商的访问限制。
DISTILL-303|NO_DATA_PROVENANCE
训练集只保存Prompt和Answer,却不知道输出来自哪个模型、什么版本、什么授权条件。
DISTILL-304|COMPETITOR_CLONING
训练目标明确是尽可能复刻闭源竞品核心能力,同时缺少授权和实质差异化。
DISTILL-305|LEGAL_REVIEW_AFTER_TRAINING
模型训练和商业发布完成以后才检查数据来源与服务协议,合规问题已经难以回滚。
14|所以,蒸馏到底是不是“偷窃”?
如果只问技术本身。
答案很简单。
不是。
蒸馏是一种成熟、常用、甚至被主流实验室广泛使用的模型训练方法。
但如果问题变成:能不能通过虚假账号和代理网络,大规模采集一个明确禁止竞争性训练的闭源API输出,再低成本训练同类商业模型?
那讨论的已经不只是“蒸馏技术”。
而是合同、访问控制、数据来源、商业竞争与伦理边界。
反过来,也不能因为某家公司用了蒸馏,就自动推导出它“偷了模型”。
必须拿出数据来源、访问方式、协议约束和训练用途等具体证据。
15|最后
AI行业真正需要的,不是把“蒸馏”两个字妖魔化。
也不是用“技术中立”四个字把所有争议一笔带过。
更成熟的标准应该是:技术可以中立,数据来源必须可追溯,服务协议必须被尊重,训练用途必须说得清楚,竞争行为必须接受规则约束。
法律没有完全定论的地方,也不意味着商业边界不存在。
蒸馏是不是“偷”,最终不该由情绪决定。
而应该看证据、授权、访问方式、规模和用途。
真正值得行业建立的,不是一句统一口号,而是一套能长期运行的数据来源与模型使用治理体系。
资料说明
Anthropic于2026年2月公开表示,其识别到DeepSeek、Moonshot和MiniMax的大规模Claude能力提取活动,并称相关活动涉及超过1600万次交互和约2.4万个虚假账号。
Anthropic在同一份说明中明确承认,模型蒸馏本身是广泛使用且合法的训练方法,争议集中在未经允许的大规模竞争性能力提取。
Anthropic当前商业条款限制客户使用其服务构建竞争产品或训练竞争AI模型,除非获得明确许可。
本文讨论的是技术、合同和行业治理边界,不构成针对任何具体企业或行为的法律结论。
不同国家和地区的版权、合同、数据与竞争法规则不同,实际项目应根据具体法域和协议进行专业审查。
更多推荐


 4
 0
- 0


 已为社区贡献8条内容

所有评论(0)