
从一到无穷大 #84:AWS 收购 DuckLabs——DuckDB 与分析系统正在变化的物理边界
2026 年 8 月 26 日,AWS 与 DuckLabs 签署最终收购协议,预计 9 月初完成交割。交易金额没有披露,30 余人的团队留在阿姆斯特丹,Hannes Mühleisen 与 Mark Raasveldt 继续负责团队及开源项目的技术方向。[1][2]
严格来说,AWS 收购的是 DuckLabs 公司,不是 DuckDB 开源项目。DuckDB、DuckLake、Quack 的核心 IP 与商标仍由独立的 DuckDB Foundation 持有,代码继续使用 MIT 协议。[1][2][3] 标题里写 AWS 收购 DuckDB 是新闻语境下的简写,理解这笔交易则必须把公司、项目、IP 与开发团队拆开。
AWS 首席技术官 Werner Vogels 为这笔收购写了一篇文章,标题是 The changing physics of analytics。文章从系统设计最基本的约束讲起:CPU、Memory、Disk 与 Network 的相对成本会变化,建立在这些成本之上的架构权衡也会跟着移动。很多系统架构只在当时的硬件条件下正确。做基础架构最大的风险,是把上一代硬件条件下的 trade-off 写成永远不变的 invariant。[4]
这个标题也直接解释了 AWS 为什么会在 2026 年买下 DuckLabs。单机的核心数、内存、I/O 与网络能力已经覆盖了更大的工作集,分析任务不再天然从集群开始;DuckDB 又把高效单机执行做成一个可以进入应用、浏览器、Serverless 与长期服务的组件。AWS 买到的是这条变化已经成形后的执行入口。[4]
本文只讨论四个问题。
-
AWS 收购了什么,DuckDB Foundation 与 MotherDuck 留在怎样的位置?
-
分析系统的物理边界发生了什么变化?
-
AWS 收购 DuckLabs 的技术动因是什么?
-
AWS 可能沿哪些产品路径落地,当前证据支持到哪一步?
至于收购金额、AWS 新服务的产品名和发布时间,目前没有可靠材料,正文不会替 AWS 发布 re:Invent 预告。
1. 收购对象、开源治理与 MotherDuck
1.1 公司、项目、IP 与团队
DuckLabs 是 2021 年从荷兰 CWI 孵化出的商业公司。它给 DuckDB 核心开发团队提供雇佣关系,通过商业支持和定向开发合同获得收入;DuckDB Foundation 则负责持有开源项目的 IP 与商标。两套组织从一开始就承担不同职责。[1][3]
这次交易之后,四层边界如下。
| 对象 | 交易后归属 | 已披露状态 |
|---|---|---|
| DuckLabs 公司 | AWS | 预计纳入 AWS |
| DuckLabs 团队 | AWS | 留在阿姆斯特丹 |
| DuckDB / DuckLake / Quack 项目 | DuckDB Foundation 治理 | 继续 MIT 开源 |
| 核心 IP 与商标 | DuckDB Foundation | 不进入收购对象 |
这个安排解决了最敏感的许可证问题。基金会公开说明,DuckDB、DuckLake 与 Quack 将持续以 MIT 分发,基金会持有三者的核心 IP 与商标。[3] 即使 AWS 后续改变产品策略,已经发布的 MIT 代码也不会被收回。
但代码归属和开发能力归属不是同一件事。AWS 获得了两位创始人、核心开发者的全职工作时间、内部优先级与长期协作效率。对一个工程密度很高、核心团队只有 30 余人的数据库项目,这部分资产比再复制一份 GitHub 仓库值钱得多。
1.2 DuckLabs 商业模型的增长上限
DuckLabs 对出售公司的解释很具体。他们没有接受 VC,公司的所有者是创始人与开发团队;这让团队可以把技术放在销售前面。随着 DuckDB 使用量上升,小公司逐渐可能成为项目、合作伙伴与商业用户的瓶颈。若把 DuckLabs 扩成一间更大的销售、支持和运营公司,又会把创始人的精力从数据库与社区转走。[1]
这是一类开源基础软件经常遇到的问题:用户增长不等于收入按同样速度增长,支持合同可以养活一个精干团队,却很难同时覆盖全球交付、行业方案、合规、安全、24×7 支持与大规模基础设施。DuckLabs 还明确说,继续扩大用户范围需要解决更完整、更专业的问题,服务不同产业,并投入更多基础设施。[1]
所以 AWS 也在替 DuckLabs 支付一次组织升级成本。团队可以继续做技术,销售网络、客户入口、合规体系与全球基础设施由 AWS 提供。
1.3 MIT 永续不等于开发资源独立
DuckDB Foundation 提供了很强的法律隔离:基金会持有 IP 与商标,MIT 许可证继续存在,商业公司被收购不会自动改变项目所有权。[3] 团队还计划建立 stakeholder advisory board,让社区和关键利益相关方参与 DuckDB、DuckLake、Quack 的路线讨论。[1] DuckDB v2.0 预览还允许第三方维护自己的签名扩展仓库。[5]
开发资源的集中度仍然上升了。基金会当前董事会只有 Hannes Mühleisen、Mark Raasveldt 与 Peter Boncz 三人;交割后,前两位同时是 AWS 员工,并继续领导项目技术方向。[2][3] 这不证明 AWS 会控制每一个决定,却说明许可证开放性、治理程序和日常开发能力需要分开观察。
我会关注几个比口头承诺更可验证的信号:advisory board 的成员与权限,非 AWS Maintainer 的数量,重大 Roadmap 是否经过公开讨论,CI、扩展签名与发布基础设施能否由基金会独立运作,以及 AWS 之外的公司是否继续贡献核心模块。MIT 给了社区 fork 的最终权利,重建一支同等效率的数据库团队仍然很贵。
1.4 MotherDuck 的合作与竞争关系
MotherDuck 是最直接受到影响的商业伙伴。DuckDB 官方 FAQ 说明,MotherDuck 与 DuckLabs 签有开发服务合同,DuckLabs 持有 MotherDuck 的部分股份;MotherDuck 则经营托管 DuckDB,并贡献大量生产环境发现的修复。[6]
MotherDuck CEO Jordan Tigani 在交易当天的回应很坦率:他预计 Amazon 有一天会发布自己的 DuckDB 服务,同时欢迎竞争;MotherDuck 将继续参与 DuckDB 开发,并开始提供过去刻意避开的企业支持服务。[7] 这至少说明,生态参与者也把 AWS 做托管产品视为高概率路径。
《AWS收购DuckDB:鸭子飞进亚马逊雨林》进一步推断 AWS 会因为收购 DuckLabs 而间接成为 MotherDuck 股东。[8] 现有公开材料还不足以确认这一点。DuckLabs 确实持股,但最终收购协议是否包含、转让或剥离这部分资产,公告都没有写。开发服务合同交割后怎样续签,也没有披露。这里应该保留为空白,而不是用公司法常识替交易文件补条款。
MotherDuck 的存在还提醒了一件事:把 DuckDB 跑成一个可靠的多租户云服务,难度远高于启动一个进程。AWS 买到核心引擎团队后拥有很强的起点,并没有凭空获得 MotherDuck 四年积累的服务运营能力。双方既竞争,也可能继续互相提供对方缺少的生产反馈与生态贡献。
2. 分析系统的物理条件与 scale-out 边界
2.1 分布式分析为什么曾经是默认答案
2000 年代的分析系统面对两个直接约束:数据持续增长,单机磁盘与网卡却无法在可接受时间内把数据读完。一台机器连扫描都做不完,查询优化得再漂亮也没用。MapReduce、Spark 等系统由此把数据与计算拆到大量机器上,先在分区内并行处理,再交换和合并中间结果。[4]
这套架构需要支付固定税负:作业规划、任务调度、序列化、网络交换、跨节点同步、失败重试,以及为了容错保留的冗余。数据足够大时,这笔税非常合理,因为 scale-out 提供的吞吐量远高于协调成本。数据没有越过单机边界时,固定税就会暴露出来。
2015 年的 COST 论文专门量化了这个问题。COST 指一个系统需要多少硬件,才能超过一份合理的单线程实现。论文检查的若干图计算系统需要数百个核心才超过单线程基线,一部分系统在论文报告的全部配置下都没有超过。[9] 这项实验针对特定图计算任务,不能推成单机永远更快;它证明的是另一个更基础的事情:扩展性曲线很好看,不代表绝对性能已经把每个核心用好。
2.2 单机覆盖区间向右移动
Vogels 给了一个很直观的对照。早期 m1.xlarge 有 4 个虚拟核心、15 GB 内存与约 1 Gbps 网络;2026 年的 m8g.48xlarge 有 192 vCPU、768 GiB 内存与 50 Gbps 网络,三个维度都在约 50 倍的量级。[4]
最大的公开数据集当然也在增长,但数据量服从分布。少数公司的尾部负载增长到必须使用上千台机器,大量业务数据仍由客户数、订单量、设备量、银行交易量和日志保留周期这些相对缓慢的变量决定。单机能力与数据集规模没有同步增长,scale-out 的起点自然会右移。[4]
OceanBase 4.0 的 Paetica 是一个更早、也更接近数据库内核的旁证。OceanBase 3.x 已经能从 3 个节点扩到 1557 个节点,但分区与日志流绑定,使单机和小规格部署仍要承担大量日志流、组件交互与 2PC 的固定成本。4.0 将存储分片和事务日志流解耦:单机模式下,每个租户的分区绑定到一个日志流,事务绕开 2PC 与远程 GTS;SQL、事务和存储引擎同机时走函数调用,跨节点时才走 RPC 和分布式并行。论文在 4—32 vCPU 区间报告了接近线性的单机扩展,64 vCPU 后受物理核限制开始偏离线性。[10][11] 这条路线保留了在线迁移、高可用和横向扩容,把 scale-out 从默认执行路径改成越过单机容量或故障域之后才启用的路径。OceanBase 与 DuckDB 的负载、事务和高可用目标差得很远,从 Vogels 的框架看,二者仍落在同一个判断上:先把一台机器吃干净,再为第二台机器付协调成本。
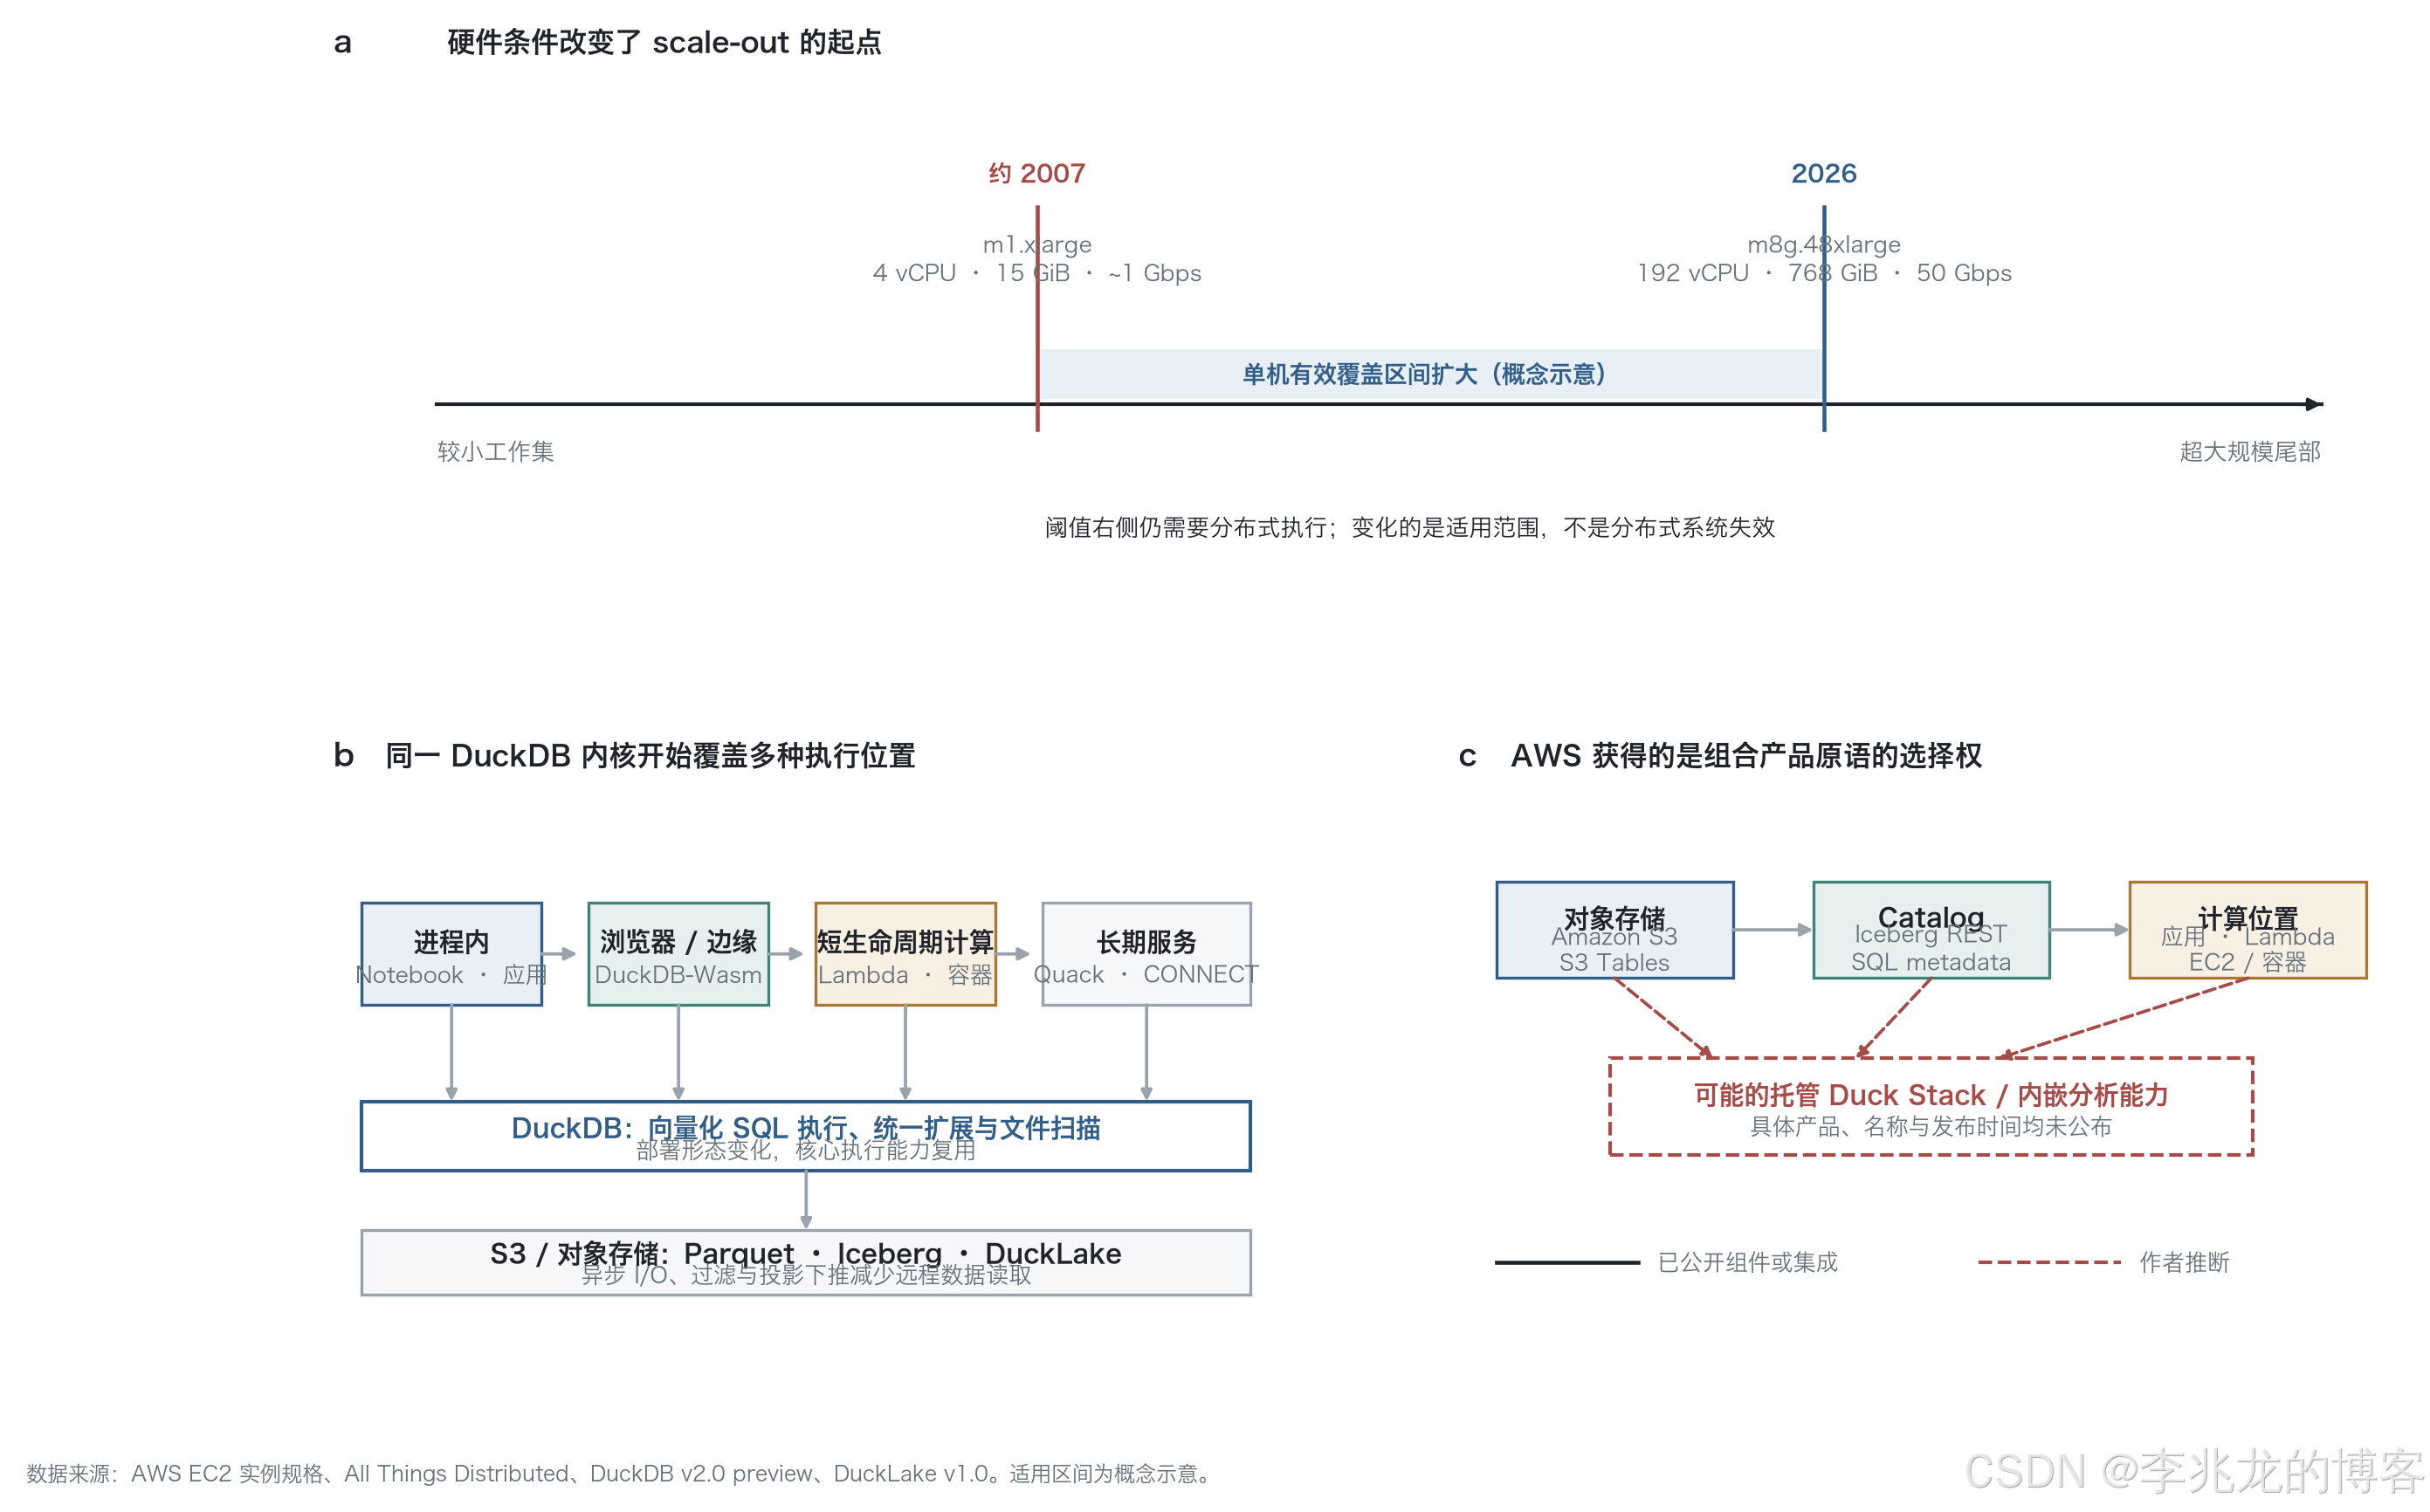
图 1:上图的阈值移动是概念示意,不是公开 benchmark。实线表示已公开的组件与集成,红色虚线表示基于 AWS 现有产品原语的作者推断。
我理解 Vogels 这篇文章的重点,就在图 1a。架构是物理条件的函数。以前一台机器不够,于是先想到 distributed;今天仍然先把每个分析任务送进集群,相当于默认昨天的网卡、内存和磁盘从未变过。
这也不意味着分布式分析已经过时。以下负载仍然会越过单机边界:工作集确实大于单机内存与可接受扫描时间,大量租户需要同时运行隔离查询,任务必须跨故障域恢复,或者组织需要统一的安全、资源治理与审计。变化发生在中间区域。原本因为单机太弱被迫分布式的很多任务,现在可以留在一台服务器、一个应用进程,甚至一个浏览器标签页里完成。
基础架构的判断顺序也应该随之变化:先测一台机器能不能解决问题,再决定是否购买第二台。反过来做,集群会把自身的固定开销伪装成业务本来就有的复杂度。
2.3 DuckDB 把单机效率做成了库
DuckDB 在 2018 年选择了一条与主流云数仓不同的路径。2019 年的 SIGMOD 论文把它定义为面向分析负载的嵌入式数据库:像 SQLite 一样进入宿主进程,同时提供列式、向量化的 OLAP 执行能力。[12]
这条路线最极端的版本是 DuckDB-Wasm:数据库引擎编译成 WebAssembly,完整运行在一个浏览器标签页里。DuckDB Web Shell 就是可以直接操作的实例。[4][13]
进程内运行省掉了客户端到数据库服务的网络往返、数据序列化和独立服务部署。DuckDB 的执行算子以固定大小的 Vector 和 DataChunk 交换数据,默认向量包含 2048 个 tuple,在解释执行开销、CPU cache 与批处理效率之间做权衡。[14] 对 Parquet,DuckDB 会自动进行列裁剪、过滤下推,并利用 zonemap 跳过无关 Row Group;查询远程文件时,少读一列、少发一个 range request 都会直接减少 S3 流量和等待时间。[15]
这里的组合很重要。高效单机引擎解决每个核心做了多少有效工作,嵌入式形态解决引擎放在哪里,Parquet/S3 扫描解决数据不用先搬进专用仓库。三者合在一起,DuckDB 才能从一个数据库变成应用中的通用分析组件。
3. AWS 收购 DuckLabs 的技术动因
3.1 S3 需要一个到处都能运行的查询消费者
AWS 与 DuckLabs 从 2024 年开始接触,最早的明确连接来自 S3 Tables。S3 团队观察到客户正在把 DuckDB 直接嵌进应用,于是在设计基于 Iceberg 的 S3 Tables 时,希望 DuckDB 用户也能直接使用这项存储能力。[2][4]
2025 年 3 月,双方共同完成 DuckDB 对 S3 Tables 与 SageMaker Lakehouse Iceberg REST Catalog 的支持。用户可以用一个 ATTACH 把 S3 Table Bucket 接进本地 DuckDB,通过 Lake Formation 权限查询数据,不需要把整份表复制到另一个查询服务。当时的公开实现只支持只读,但路径已经跑通:Catalog 负责发现和权限,S3 保存 Iceberg 表,DuckDB 在客户端侧执行。[16]
ATTACH 'arn:aws:s3tables:region:account:bucket/example'
AS s3_catalog (
    TYPE iceberg,
    ENDPOINT_TYPE s3_tables
);

SELECT count(*)
FROM s3_catalog.namespace.events;
对 S3 来说,DuckDB 是一个很特殊的消费者。它可以位于数据科学家的笔记本、业务应用、浏览器、容器、EC2,或者按查询启动的 Lambda 中。同一个引擎在更多位置读取 S3,S3 仍然是数据的稳定落点。Vogels 把 DuckDB 称为 structured data 的 glibc:软件栈到处链接它,大多数用户不用意识到它的存在。[4]
这比再做一个只能从控制台进入的分析产品更接近 S3 的利益。对象存储希望成为所有引擎的数据底座,DuckDB 则让查询能力贴近每一个应用。AWS 买下 DuckLabs,相当于把一个已经被 S3 客户主动选择的执行入口变成长期可协同的上游团队。
3.2 Quack 把嵌入式优势扩展到服务端
嵌入式 DuckDB 的效率来自同一个地址空间:应用调用数据库不需要经过网络,数据也不必先转换成独立服务能够理解的格式。这条路径的边界同样明显。数据库状态通常属于一个宿主进程,另一个应用、浏览器或 Lambda 想共享同一份可写状态时,不能靠各自打开同一个 .duckdb 文件解决。Quack 给 DuckDB 增加了一条可选的网络边界:一个实例持有数据库并作为服务端,其他 DuckDB 实例通过 HTTP 连接,多个独立进程的读写请求由服务端实例统一处理。[5][17]
收购公告前九天,DuckDB 发布 v2.0 预览,最醒目的变化是 Quack 与 CONNECT。服务端只需在现有 DuckDB 会话中启动 quack_serve;客户端可以把远端实例 ATTACH 成一个 Catalog,也可以用 CONNECT 把后续 SQL 放到远端执行。[5][17]
ATTACH 'quack:server.example.com'
AS analytics (TOKEN 'my_token');

CONNECT analytics;
SELECT count(*) FROM events;
DISCONNECT;
上面的查询由 analytics 对应的 DuckDB 进程执行,客户端接收聚合结果,不必把 events 全表搬回本地。客户端本身仍然是 DuckDB,远端表以 Catalog 的形式进入同一套 SQL、类型系统和扩展体系。开发者可以让小查询留在浏览器或应用进程,把需要共享状态、并发写入或靠近数据执行的部分放到 EC2 和容器中,不必在两种形态之间再维护一套应用协议。
Quack 的协议层延续了 DuckDB 自己的数据路径。协议建立在 HTTP 上,可以复用反向代理、负载均衡和防火墙;请求与响应使用 application/duckdb,复用 DuckDB 内部的序列化原语,嵌套类型、Decimal 和 Interval 不需要经过 CSV、JSON 等中间格式。连接握手完成后,一次查询通常只需要一次请求—响应,大结果再通过 FETCH 分块返回并支持多线程拉取。DuckDB-Wasm 也可以原生使用这套协议,所以浏览器中的 DuckDB 能直接连接运行在 EC2 上的 DuckDB。[17][18]
同一版本还把异步 I/O 贯穿引擎。DuckDB 以前已经能够并行读取 S3,同步访问仍会限制远程读取的并发度;异步 I/O 让远程读取独立于查询线程扩展,官方明确说主要收益出现在网络存储。[5] Quack 解决应用到执行引擎的网络边界,异步 I/O 解决执行引擎到远程存储的等待,两条路径合起来以后,一个靠近 S3 运行的 DuckDB 服务端才更像完整的远程执行节点。
这里仍然要区分协议和产品。Quack 当前处于活跃开发阶段,协议、函数名与默认配置都可能变化。[18] 它提供远程执行、共享状态和多进程并发写入,没有自动补齐备份恢复、多租户隔离、跨可用区高可用、容量调度与计费。AWS 获得了一条把 DuckDB 放进服务端的低摩擦路径,真正做成托管数据库仍然隔着一层很厚的服务工程。
Quack 发布与收购公告只相隔九天,这个时间点确实扎眼。九天不能证明交易由 Quack 触发,并购谈判显然也不会九天完成。更稳妥的理解是,DuckDB 的产品边界已经在交易发生前扩宽:AWS 获得的团队可以同时建设库、协议、长期服务与远程 I/O,不再局限于一个本地分析工具。
3.3 DuckLake 补齐数据、元数据与计算
DuckLake 把这条路线继续推到了 Lakehouse。它把 Parquet 数据放在对象存储中,把表、Schema、Snapshot、文件列表和统计信息放入支持事务与主键的 SQL 数据库,再由 DuckDB 或其他计算引擎查询。DuckLake v1.0 的参考实现支持 SQLite、PostgreSQL 和 DuckDB 作为 Catalog,并允许多个 DuckDB 实例通过一个中央 PostgreSQL Catalog 协调读写。[19][20]
这个设计直接挑战 Iceberg/Delta 把大量表元数据编码为对象存储文件的路径。DuckLake 认为,Lakehouse 最终还是需要 Catalog 数据库来原子更新当前版本,那么其余元数据也可以回到关系表和 SQL 事务中;对象存储继续承担容量大、成本低、格式开放的数据文件。[20]
AWS 现有产品刚好覆盖这三层:S3 提供对象存储,RDS/Aurora 可以提供 SQL Catalog,Lambda、EC2 与容器服务提供不同生命周期的计算。这里是架构映射,不是产品公告。AWS 当前的 S3 Tables 仍以 Iceberg 为正式表格式,官方也没有宣布 Amazon DuckLake 或 Amazon Quack。
收购真正带来的,是选择权。AWS 可以继续让 DuckDB 成为 S3 Tables 的高效客户端,也可以把 DuckDB 嵌进现有分析与 AI 服务,或者组合出托管 Duck Stack。这些路径可以同时存在。DuckDB 的库形态甚至允许 AWS 在用户看不到数据库名字的地方使用它,这与 DuckLabs 公告中“用户每天依赖 Duck Stack,却未必直接接触它”的说法一致。[1]
3.4 数据库团队与路线图协同
AWS 公告专门强调了 DuckLabs 的数据库工程深度和交付速度。[2] 这部分容易被开源许可证遮住:MIT 让任何人都能拿到代码,却不会自动复制开发它的人、性能回归体系、扩展兼容工作、Issue 处理经验,以及从 MonetDB/X100 一路延伸过来的执行引擎研究。
DuckDB v1.5 到 v2.0 之间超过 10000 次提交,范围包括新 Parser、异步 I/O、存储格式、远程协议、VARIANT、扩展 ABI 与大量优化。[5] 对一个想把同一内核放进多个产品的云厂商,内部拥有这支团队会减少跨公司合同、优先级排期与版本协调的摩擦。
所以我不太认同把这笔交易简化成 AWS 想补一个 Redshift 的轻量版本。AWS 当然可能推出托管 DuckDB 服务,MotherDuck 也公开预期这件事会发生;更大的价值是把 DuckDB 变成跨 AWS 数据产品复用的执行底座。一个独立数仓只影响自己的客户,一个被大量软件链接的库会影响 S3 的访问路径、开发者入口和上层产品成本。
4. AWS 可能落地的产品路径与证据边界
官方目前只确认双方会用 DuckDB、DuckLake 和 Quack 构建新一代数据服务,交割完成后再说明具体方案。[1][2] 基于已经公开的技术路径,可以把可能方向按证据强度排成下面几层。
| 产品路径 | 当前证据 | 判断强度 |
|---|---|---|
| 加深 S3 Tables / SageMaker Lakehouse 集成 | 已有联合实现 | 高 |
| 在 AWS 服务内部嵌入 DuckDB | AWS 明确谈到间接使用 | 中高 |
| Lambda 上的短查询与按需分析 | 已有联合探索 | 中 |
| 托管 Quack / Duck Stack | 组件已经具备 | 推断 |
| 替代 Redshift 或 Athena | 没有公开证据 | 不判断 |
S3 Tables 路径最确定。Iceberg REST Catalog、Lake Formation 与 DuckDB 已经公开运行,后续可以继续补写入、性能、凭据、治理和更完整的服务集成。[16]
内嵌路径更符合 DuckDB 的库形态。AWS 可以在数据库、AI、数据准备、日志分析或开发工具中链接 DuckDB,用户得到更快、更便宜的局部分析,却不一定看到一个单独的 DuckDB 产品。DuckLabs 和 Vogels 都把这种安静地存在于其他产品内部的形态写进了收购叙事。[1][4]
托管服务也很自然,但目前只能写成推断。Quack 解决远程协议,不等于解决账号体系、备份恢复、多租户隔离、容量调度、跨可用区高可用、计费与支持。MotherDuck 已经为这些问题投入四年,AWS 真正做产品仍然需要补齐数据库之外的大量工程。[7]
至于今年 re:Invent 会不会出现 Amazon DuckDB,资料不够。把一个合理猜想写成发布计划,正是分析并购时最容易犯的错误。
5. 结束语
AWS 这次没有买走 DuckDB 的 MIT 代码和 IP,却买走了最能决定其未来形态的一组人。公开材料给出的理由已经足够完整:DuckLabs 原有商业模型接近组织上限;S3 客户正在主动嵌入 DuckDB;双方已经打通 S3 Tables 与 SageMaker Lakehouse;Quack、异步 I/O 和 DuckLake 又把一个进程内引擎扩成了可服务、可共享、可围绕对象存储组合的 Duck Stack。
我的重点仍然是那句 Architecture is a function of physics。MapReduce 与 Spark 在单机 I/O 明显不足的年代给出了正确答案,DuckDB 在单机核心、内存、网络和本地带宽重新变得充裕时,把大量分析任务收回一个进程。两边解决的是不同物理条件下的问题。
分布式系统当然还在。真正需要一千台机器的任务,一台也少不了。危险的是另一种惯性:业务只有一台机器的规模,架构却先继承了一千台机器的协调成本,再用更多机器掩盖这笔开销。
我更愿意把这笔交易理解为 AWS 对计算下沉的一次主动适配。MIT 与 DuckDB Foundation 让 AWS 无法获得代码独占权,收购 DuckLabs 给它的是核心团队的全职工作时间,以及把 S3 Tables、Quack 和 DuckLake 做成一等路径的协同效率。分析执行正在离开固定数仓,进入浏览器、应用进程、Lambda 与 EC2。AWS 可以接受计算位置继续分散,把 S3 留在持久数据层,再用 Quack、DuckLake 和现有数据库与计算服务承接共享状态、Catalog 与远程执行。
真正的竞争已经从性能排行榜转向默认值:查询在哪里执行,什么时候跨网络,元数据放在哪里,持久数据最终落在哪里。DuckDB、Quack 与 DuckLake 已经进入这些决定。只要持久数据仍落在 S3,查询跑在浏览器、Lambda 还是 EC2,反而不是 AWS 必须控制的变量。AWS 买下的,是在下一代分析栈成形时参与设置默认值的能力。让计算自由移动、让持久数据继续留在 S3,才是这笔交易最 AWS 的地方。
2026 年 1 月 ClickHouse 收购 Langfuse,是一个很近的参照。Langfuse v3 已经把 Cloud 和自托管版本的核心数据层迁到 ClickHouse,Langfuse Cloud 本身又是 ClickHouse Cloud 的大客户;从 v2 升级到 v3,还顺手把数千个自托管团队带给了 ClickHouse。收购后许可证、自托管路径和底层依赖都不需要改变。[21][22] 这恰恰是交易最值钱的地方:Langfuse 继续扩散,每一个新部署天然就是一个 ClickHouse workload。其他 OLAP 引擎当然可以自己适配,但很难再进入 Langfuse 官方路径的默认 backend。ClickHouse 买下的是一条已经成立的 workload 分发链,并且堵住了竞争对手从 LLM observability 这一层向下切入的入口。
AWS 收购 DuckLabs 的同一层价值更大。对象存储市场早已把 S3 compatibility 当成通行证,Cloudflare R2 直接实现 S3-compatible API,Google Cloud Storage 也允许 S3 工具更换 endpoint 后接入。[23][24] AWS 现在又把 S3 从 GET、PUT、LIST 扩成新的资源与 API 家族:table bucket 在对象存储里管理 Iceberg 表,vector bucket 直接提供向量索引与相似度查询。[25][26] DuckDB 已经接通 S3 Tables。[16] 我认为 DuckLabs 进入 AWS 以后,更值得警惕的是这种首发顺序会固化下来:S3 定义新的 bucket 类型或数据协议,DuckDB 第一时间支持,再由其他公有云和对象存储补兼容。它们需要追赶的兼容面会从基础 S3 API 扩到 table、vector 以及尚未出现的下一种数据语义。S3 先发,DuckDB 把先发能力带进应用,其他产品排队适配。等兼容补完,默认值早已写进生态。
6. 参考资料
[1] DuckLabs to Join AWS, Projects to Remain Open Source
[2] AWS to acquire DuckLabs, the Amsterdam-based company behind DuckDB
[4] DuckDB and the changing physics of analytics
[6] DuckDB Frequently Asked Questions
[9] Scalability! But at what COST?
[11] Thoughts on the Integrated Architecture of OceanBase Database for Standalone and Distributed Modes
[12] DuckDB: an Embeddable Analytical Database
[13] DuckDB Web Shell
[15] Reading and Writing Parquet Files
[16] Streamlining access to tabular datasets stored in Amazon S3 Tables with DuckDB
[17] Quack: The DuckDB Client-Server Protocol
[19] DuckLake v1.0: The Lakehouse Format Built on SQL Reaches Production-Readiness
[20] The DuckLake Manifesto: SQL as a Lakehouse Format
[21] ClickHouse welcomes Langfuse: The future of open-source LLM observability
[22] Langfuse joins ClickHouse
[23] S3-compatible API — Cloudflare R2
[24] Interoperability with other storage providers — Google Cloud Storage
更多推荐
 4
 0
- 0


 已为社区贡献5条内容

所有评论(0)