
模型部署实战(二):4GB 显存硬跑 Qwen2.5-VL-3B!vLLM 极限部署指南
本文定位:低显存设备「从 0 到 1 跑通 vLLM + 多模态模型」的实测记录
- 核心目标:在 GTX 1650(4GB 显存)上成功部署 Qwen2.5-VL-3B;
操作指引:每一步均标注执行终端(PowerShell / WSL / Docker),照抄即可复现。- 适用环境:Win10 22H2 + WSL2 + Ubuntu 24.04 + Docker + vLLM
- 记录时间:2026-08-09(本机实测,全部命令已验证)
💡 为什么要这么做?
- 目前 DeepSeek API 逻辑推理能力极强,但原生不支持图片输入。本教程旨在构建一种混合推理架构:
- 利用本机 GTX 1650 运行 Qwen2.5-VL 充当 “视觉前端”,负责处理图片并生成描述;再将结果传递给 DeepSeek API 充当 “逻辑后端”,负责深度思考与问答。
这意味着,只需一张入门级显卡,就能让 DeepSeek 瞬间拥有识图能力。
目录
- ⚡ 快速上手(三步走)
- 第 1 部分:前置准备(适用环境 + WSL2 + 显卡驱动)
- 第 2 部分:安装 vLLM 运行环境
- 第 3 部分:下载模型(AWQ 量化版)
- 第 4 部分:启动并验证 vLLM 服务
- 第 5 部分:从 Windows 调用测试
- 第 6 部分:踩坑全记录(重点)
- 第 7 部分:已知限制
- 第 8 部分:命令速查
⚡ 快速上手(三步走)
整篇文档其实就是这三件事,其余都是补充。① ② 只做一次,③ 每次使用都做。
| 步骤 | 干什么 | 命令(在哪个终端) | 详见 |
|---|---|---|---|
| ① 装 vLLM | 建虚拟环境 + 装 vllm | /home/vllm_serve/venv/bin/pip install vllm==0.26.0 (WSL) | 第 2 部分 |
| ② 下模型 | 下 AWQ 量化版,复制进 WSL | 先跑 download_model.ps1(PowerShell)→ 再 cp 进 /home/vllm_serve/models/(WSL) | 第 3 部分 |
| ③ 起服务 + 验证 | 启动 OpenAI 兼容 API,确认在线 | bash /home/vllm_serve/start_vllm.sh(WSL)→ curl.exe http://localhost:8000/v1/models(PowerShell) | 第 4 部分 |
唯一前置:显卡驱动 ≥ 610.88(第 1 部分),否则 torch 起不来。
卡住时先看:第 6 部分踩坑全记录——4GB 显存的所有坑都在那里。
全文路径约定(每条命令处另有就地注释,按命令旁的注释改即可):本文命令统一放在
/home/vllm_serve/(部署目录,不污染/root);/root/是 root 用户家目录,非 root 用户运行系统命令时换成echo $HOME的结果;WSL 侧部署路径别放/mnt/...(那是 Windows 盘,走 9P 桥接,模型会加载不动)。
你会得到什么(成果速览)
| 项目 | 结果 |
|---|---|
| 模型 | Qwen2.5-VL-3B-Instruct(AWQ Q4 量化,权重 3.32 GiB) |
| 服务 | vLLM 0.26.0,监听 http://localhost:8000(OpenAI 兼容 API) |
| 硬件 | GTX 1650 4GB 显存(实际可用 ~3.2 GiB,Windows 桌面占 ~0.8 GiB) |
| 能力 | 中文 OCR、图片描述、图表理解、文档识别 |
| 实测 | 图片识别 ✅ 文字 OCR ✅ 中文回答 ✅ |
| 限制 | 单次请求图片+文字总 token ≤ 512(图需 ≤ 448px),并发 1 |
Windows 侧直接访问 http://localhost:8000 即可调用(WSL2 自动转发端口),无需任何额外配置。
第 1 部分:前置准备(适用环境 + WSL2 + 显卡驱动)
这部分的活只干一次:确认机器达标 → 装好 WSL2 和 Ubuntu → 升级显卡驱动。
1.1 适用环境
- Windows 10 22H2(19045)或 Windows 11,已开启 WSL2
- NVIDIA 独显:本文实测为 GTX 1650(Turing,compute capability 7.5,4GB 显存)
- 显卡驱动:610.88 及以上(支持 CUDA 14,torch cu130 需要)
- 磁盘:模型权重 ~3.4 GB + 虚拟环境 ~6 GB,建议放非 C 盘
⚠️ 4GB 显存是本文最大的坑:AWQ 权重 3.32 GiB 几乎占满整张卡,全靠第 6.7 节的技巧才塞进去。显存 ≥ 6GB 的机器可跳过极限压榨部分,直接加大
--max-model-len。
1.2 WSL2 + Ubuntu 24.04
详细安装流程见同目录《WSL-Ubuntu-Docker-安装全流程.md》,这里只列结论:
- Ubuntu 虚拟磁盘在
E:\WSL\Ubuntu\ext4.vhdx(Linux 的"物理存储",/根目录) - Windows 的 D 盘在 Linux 里挂在
/mnt/d,C 盘在/mnt/c - 打开 Ubuntu:PowerShell 里敲
wsl回车
[PowerShell]
wsl --status          # 确认默认分发是 Ubuntu、版本 2
wsl                   # 进入 Ubuntu
1.3 显卡驱动(关键前提)
vLLM 的 torch 2.11+cu130 需要较新驱动。旧驱动(如 526.56)会报:
RuntimeError: The NVIDIA driver on your system is too old (found version 12000)
升级到 610.88(实测通过):
- 下载驱动(需完整浏览器 UA + Referer,否则 403):
[PowerShell] curl.exe -L -A "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36" -e "https://www.nvidia.com/" -o "E:\WSL\downloads\drivers\610.88.exe" "https://us.download.nvidia.cn/Windows/610.88/610.88-notebook-win10-win11-64bit-international-dch-whql.exe" # 上面 -o 后面的保存目录可改:换成你想要的任意 Windows 路径即可(只影响驱动安装包放哪) - 双击 exe 安装(会弹 UAC,点"是";装完可能需要重启)
- 验证:
[PowerShell]
nvidia-smi        # 显示 Driver Version: 610.88 即成功
1.4 确认 WSL 里 CUDA 可用
[WSL]
nvidia-smi          # 应显示和 Windows 一样的 610.88
第 2 部分:安装 vLLM 运行环境
2.1 创建虚拟环境
[WSL]
sudo apt update && sudo apt install -y python3-venv python3-pip

python3 -m venv /home/vllm_serve/venv   # 虚拟环境路径可改:换成 ~/venv-vllm 等任意 WSL 目录,但下文所有 /home/vllm_serve/venv/ 前缀要同步改

/home/vllm_serve/venv/bin/pip install --upgrade pip
💡 想让命令短写?激活 venv 即可:执行
source /home/vllm_serve/venv/bin/activate后,pip/python直接可用(不用再写/home/vllm_serve/venv/bin/前缀)。但激活只对当前终端窗口有效,换窗口要重新激活;想自动激活就执行echo 'source /home/vllm_serve/venv/bin/activate' >> ~/.bashrc。
本文后续命令仍写全路径,是为了不依赖激活状态、保证一定装进 venv(直接pip install会调用系统 pip,可能装错地方)。你激活后把/home/vllm_serve/venv/bin/前缀去掉即可。
2.2 安装 vLLM
[WSL]
/home/vllm_serve/venv/bin/pip install vllm==0.26.0
# 已激活 venv 的话直接: pip install vllm==0.26.0
会自动装 torch 2.11.0+cu130。装完验证:
/home/vllm_serve/venv/bin/python -c "import torch; print(torch.__version__, torch.cuda.is_available())"
# 期望: 2.11.0+cu130 True
若
cuda.is_available()是 False,几乎都是驱动问题,回 1.3。
第 3 部分:下载模型(AWQ 量化版)
3.1 为什么选 AWQ 版
| 模型版本 | 权重大小 | 说明 |
|---|---|---|
| 官方原版(FP16) | 7.5 GB | 4GB 显存直接出局 |
| Qwen2.5-VL-3B-Instruct-AWQ(本文选用) | 3.4 GB | Q4 量化,4GB 显存的极限选择 |
| GGUF(Q4_K_M) | ~2.3 GB | 最小,但 vLLM 0.26 不支持多模态 GGUF,放弃 |
3.2 下载(本机实测:hf-mirror + curl 逐个下载)
模型仓库:Qwen/Qwen2.5-VL-3B-Instruct-AWQ(HF 镜像:hf-mirror.com)
需要下载 14 个文件(含 model.safetensors 3.17 GB 主权重),共 ~3.4 GB:
.gitattributes  LICENSE  README.md  added_tokens.json  chat_template.json
config.json  generation_config.json  merges.txt  model.safetensors (3.17 GB)
preprocessor_config.json  special_tokens_map.json  tokenizer.json (11 MB)
tokenizer_config.json  vocab.json (2.7 MB)
下载脚本(Windows 侧执行,存到 E:\WSL\downloads\models\):
# download_model.ps1
$files = @(
  ".gitattributes", "LICENSE", "README.md", "added_tokens.json",
  "chat_template.json", "config.json", "generation_config.json",
  "merges.txt", "model.safetensors", "preprocessor_config.json",
  "special_tokens_map.json", "tokenizer.json", "tokenizer_config.json", "vocab.json"
)
$dest = "E:\WSL\downloads\models\Qwen2.5-VL-3B-Instruct-AWQ"   # 下载目录可改:任意 Windows 目录,但 3.3 的 cp 源路径要跟着改
New-Item -ItemType Directory -Path $dest -Force | Out-Null
$base = "https://hf-mirror.com/Qwen/Qwen2.5-VL-3B-Instruct-AWQ/resolve/main/"
foreach ($f in $files) {
  $out = Join-Path $dest $f
  if ((Test-Path $out) -and ((Get-Item $out).Length -gt 0)) { Write-Host "SKIP $f"; continue }
  curl.exe -sL -C - -A "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36" -o $out "$base$f"
  Write-Host "$f -> $((Get-Item $out -ErrorAction SilentlyContinue).Length) bytes"
}
Write-Host "ALL DONE"
[PowerShell]
powershell -ExecutionPolicy Bypass -File .\download_model.ps1
⚠️
model.safetensors下载完后必须确认后 5 个小文件也下载成功(本机曾因流程提前报完成漏掉 tokenizer 等 5 个文件,导致启动报vocab and merges must be both be from memory or both filenames)。检查:[PowerShell] Get-ChildItem "E:\WSL\downloads\models\Qwen2.5-VL-3B-Instruct-AWQ" | Select Name, Length # 路径随上面脚本的 $dest
3.3 复制进 WSL
WSL 直接读 /mnt/e(9P 桥接)极慢,必须复制到 Linux 原生目录:
[WSL]
# 源路径 = 你在 3.2 下载脚本里设的 $dest(Windows 盘,经 /mnt 访问)
# 目标路径 = 你选的模型运行目录:任意 WSL 原生路径都行(如 ~/models/...),但 4.1 启动脚本里的模型路径要同步改
mkdir -p /home/vllm_serve/models/Qwen2.5-VL-3B-Instruct-AWQ
cp /mnt/e/WSL/downloads/models/Qwen2.5-VL-3B-Instruct-AWQ/* /home/vllm_serve/models/Qwen2.5-VL-3B-Instruct-AWQ/
ls -la /home/vllm_serve/models/Qwen2.5-VL-3B-Instruct-AWQ/
3.4 GB 复制约需 5 分钟。复制期间 WSL 可能报资源不足崩溃(见 6.8),崩溃后
wsl --shutdown重启再继续。
第 4 部分:启动并验证 vLLM 服务
起服务 → 确认在线 → 跑两个测试(OCR + 真实图片),一气呵成。
4.1 启动脚本(最终版,已调通)
把下面内容存为 /home/vllm_serve/start_vllm.sh:
#!/bin/bash
export VLLM_WSL2_ENABLE_PIN_MEMORY=1
# GTX 1650 4GB 极限压榨: AWQ 权重 3.32GiB 用 weights 专用池加载
# KV cache 手动指定 128MiB 绕过 vLLM 的显存计算 bug (free-weights 为负)
# 路径可改: venv 随 2.1, 模型目录随 3.3, 日志重定向路径见下方 > /home/vllm_serve/vllm.log 处
source /home/vllm_serve/venv/bin/activate
cd /home/vllm_serve/models

echo "=============================================="
echo " vLLM 启动中... 日志实时显示在下面 (同时写入 /home/vllm_serve/vllm.log)"
echo " 出现 'Application startup complete.' = 就绪"
echo " 就绪后访问: http://localhost:8000   Ctrl+C 停止服务"
echo " 启动约需 1.5~2 分钟,请耐心等待..."
echo "=============================================="

# 模型路径换成你在 3.3 复制到的目录;--port / --served-model-name 也可自定义
exec vllm serve /home/vllm_serve/models/Qwen2.5-VL-3B-Instruct-AWQ \
  --served-model-name qwen2.5-vl-3b \
  --quantization awq \
  --gpu-memory-utilization 0.80 \
  --kv-cache-memory-bytes 134217728 \
  --max-model-len 512 \
  --max-num-seqs 1 \
  --limit-mm-per-prompt '{"image": 1}' \
  --enforce-eager \
  --host 0.0.0.0 \
  --port 8000 \
  2>&1 | tee /home/vllm_serve/vllm.log  # 日志路径可改,4.3/4.4 的查看命令要同步改
4.2 启动
[WSL]
chmod +x /home/vllm_serve/start_vllm.sh
bash /home/vllm_serve/start_vllm.sh   # 脚本路径可改:若你在 4.1 另存了位置,这里和速查表都要跟着改
启动耗时约 1.5~2 分钟(权重加载 17s + 编译/profile 10s + API 就绪)。
4.3 常用配套命令
[WSL]
tail -f /home/vllm_serve/vllm.log          # 实时看日志(路径随 4.1 的重定向)
pgrep -af "vllm serve"          # 确认进程活着
若想让服务在 Windows 后台常驻,在 PowerShell 用后台任务启动:
[PowerShell]
wsl -e bash -c "bash /home/vllm_serve/start_vllm.sh"   # 保持这个窗口开着即可;脚本路径同 4.2
4.4 确认 API 就绪
日志出现以下行即成功:
[WSL]
grep -E "Application startup complete|Uvicorn" /home/vllm_serve/vllm.log
# 期望输出: Application startup complete.
4.5 查询模型列表
[PowerShell]
curl.exe http://localhost:8000/v1/models
# 期望返回: {"object":"list","data":[{"id":"qwen2.5-vl-3b",...}]}
4.6 OCR 实测(生成本机测试图)
把下面脚本存为 /home/vllm_serve/test_ocr.py 并执行(脚本路径可改,保存位置和下面执行命令保持一致即可):
from PIL import Image, ImageDraw, ImageFont
import base64, io, json, urllib.request

img = Image.new("RGB", (224, 224), "white")
d = ImageDraw.Draw(img)
try:
    font = ImageFont.truetype("/usr/share/fonts/truetype/dejavu/DejaVuSans-Bold.ttf", 28)
except Exception:
    font = ImageFont.load_default()
d.text((20, 40), "HELLO VLLM", fill="black", font=font)
d.text((20, 90), "Qwen2.5-VL-3B", fill="black", font=font)
d.text((20, 140), "GTX 1650 4GB", fill="black", font=font)
d.text((20, 190), "12345", fill="black", font=font)
img.save("/home/vllm_serve/test_ocr.png")

buf = io.BytesIO(); img.save(buf, format="PNG")
b64 = base64.b64encode(buf.getvalue()).decode()
payload = {
    "model": "qwen2.5-vl-3b",
    "messages": [{"role": "user", "content": [
        {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{b64}"}},
        {"type": "text", "text": "请逐行读出图片里的所有文字。"}
    ]}],
    "max_tokens": 200,
}
req = urllib.request.Request("http://127.0.0.1:8000/v1/chat/completions",
    data=json.dumps(payload).encode(), headers={"Content-Type": "application/json"})
with urllib.request.urlopen(req, timeout=180) as resp:
    print(json.loads(resp.read().decode())["choices"][0]["message"]["content"])
[WSL]
/home/vllm_serve/venv/bin/python /home/vllm_serve/test_ocr.py   # 路径随你保存的位置;venv 前缀随 2.1
实测输出(基本全对):
HELLO VLLM
Qwen2.5-VL-1      # "3B" 读成 "1",小图分辨率低所致,可忽略
GTX 1650 4G
12345
4.7 真实图片测试
用任意真实图片(如 D:\数据存储\Pictures\情头\男生.jpeg):
[WSL]
cp "/mnt/d/数据存储/Pictures/情头/男生.jpeg" /home/vllm_serve/real.jpg
注意:原图必须先缩放到 ≤448px 再传(原因见 6.9),缩放用 Windows 侧脚本最方便(见第 5 部分)。
第 5 部分:从 Windows 调用测试
vLLM 在 WSL 里监听 0.0.0.0:8000,WSL2 自动把端口转发到宿主机,所以 Windows 直接访问 http://localhost:8000。
5.1 方式一:一键测试脚本(推荐)
把 test_vllm.ps1(见附录)放在任意目录,PowerShell 进入该目录执行(下面 \.\ 换成你的实际路径):
[PowerShell]
# .\ 表示当前目录:先 cd 到 test_vllm.ps1 所在目录,或直接写完整路径 C:\...\test_vllm.ps1
.\test_vllm.ps1                                              # 纯文本对话
.\test_vllm.ps1 -Image "D:\数据存储\Pictures\情头\男生.jpeg"   # 图片识别(自动缩放 448px)
.\test_vllm.ps1 -Image "...\图.jpg" -Prompt "这张图是什么风格?"  # 图片 + 自定义问题
脚本内置:服务健康检查、图片自动缩放、UTF-8 中文输出修复。实测输出:
== 4. 结果 (用时 1.7s) ==
这张图片的主角是一只棕色的小狗。
5.2 方式二:浏览器 Swagger 调试页
浏览器打开 http://localhost:8000/docs —— vLLM 自带的可视化 API 页面,填参数点按钮即可发请求。
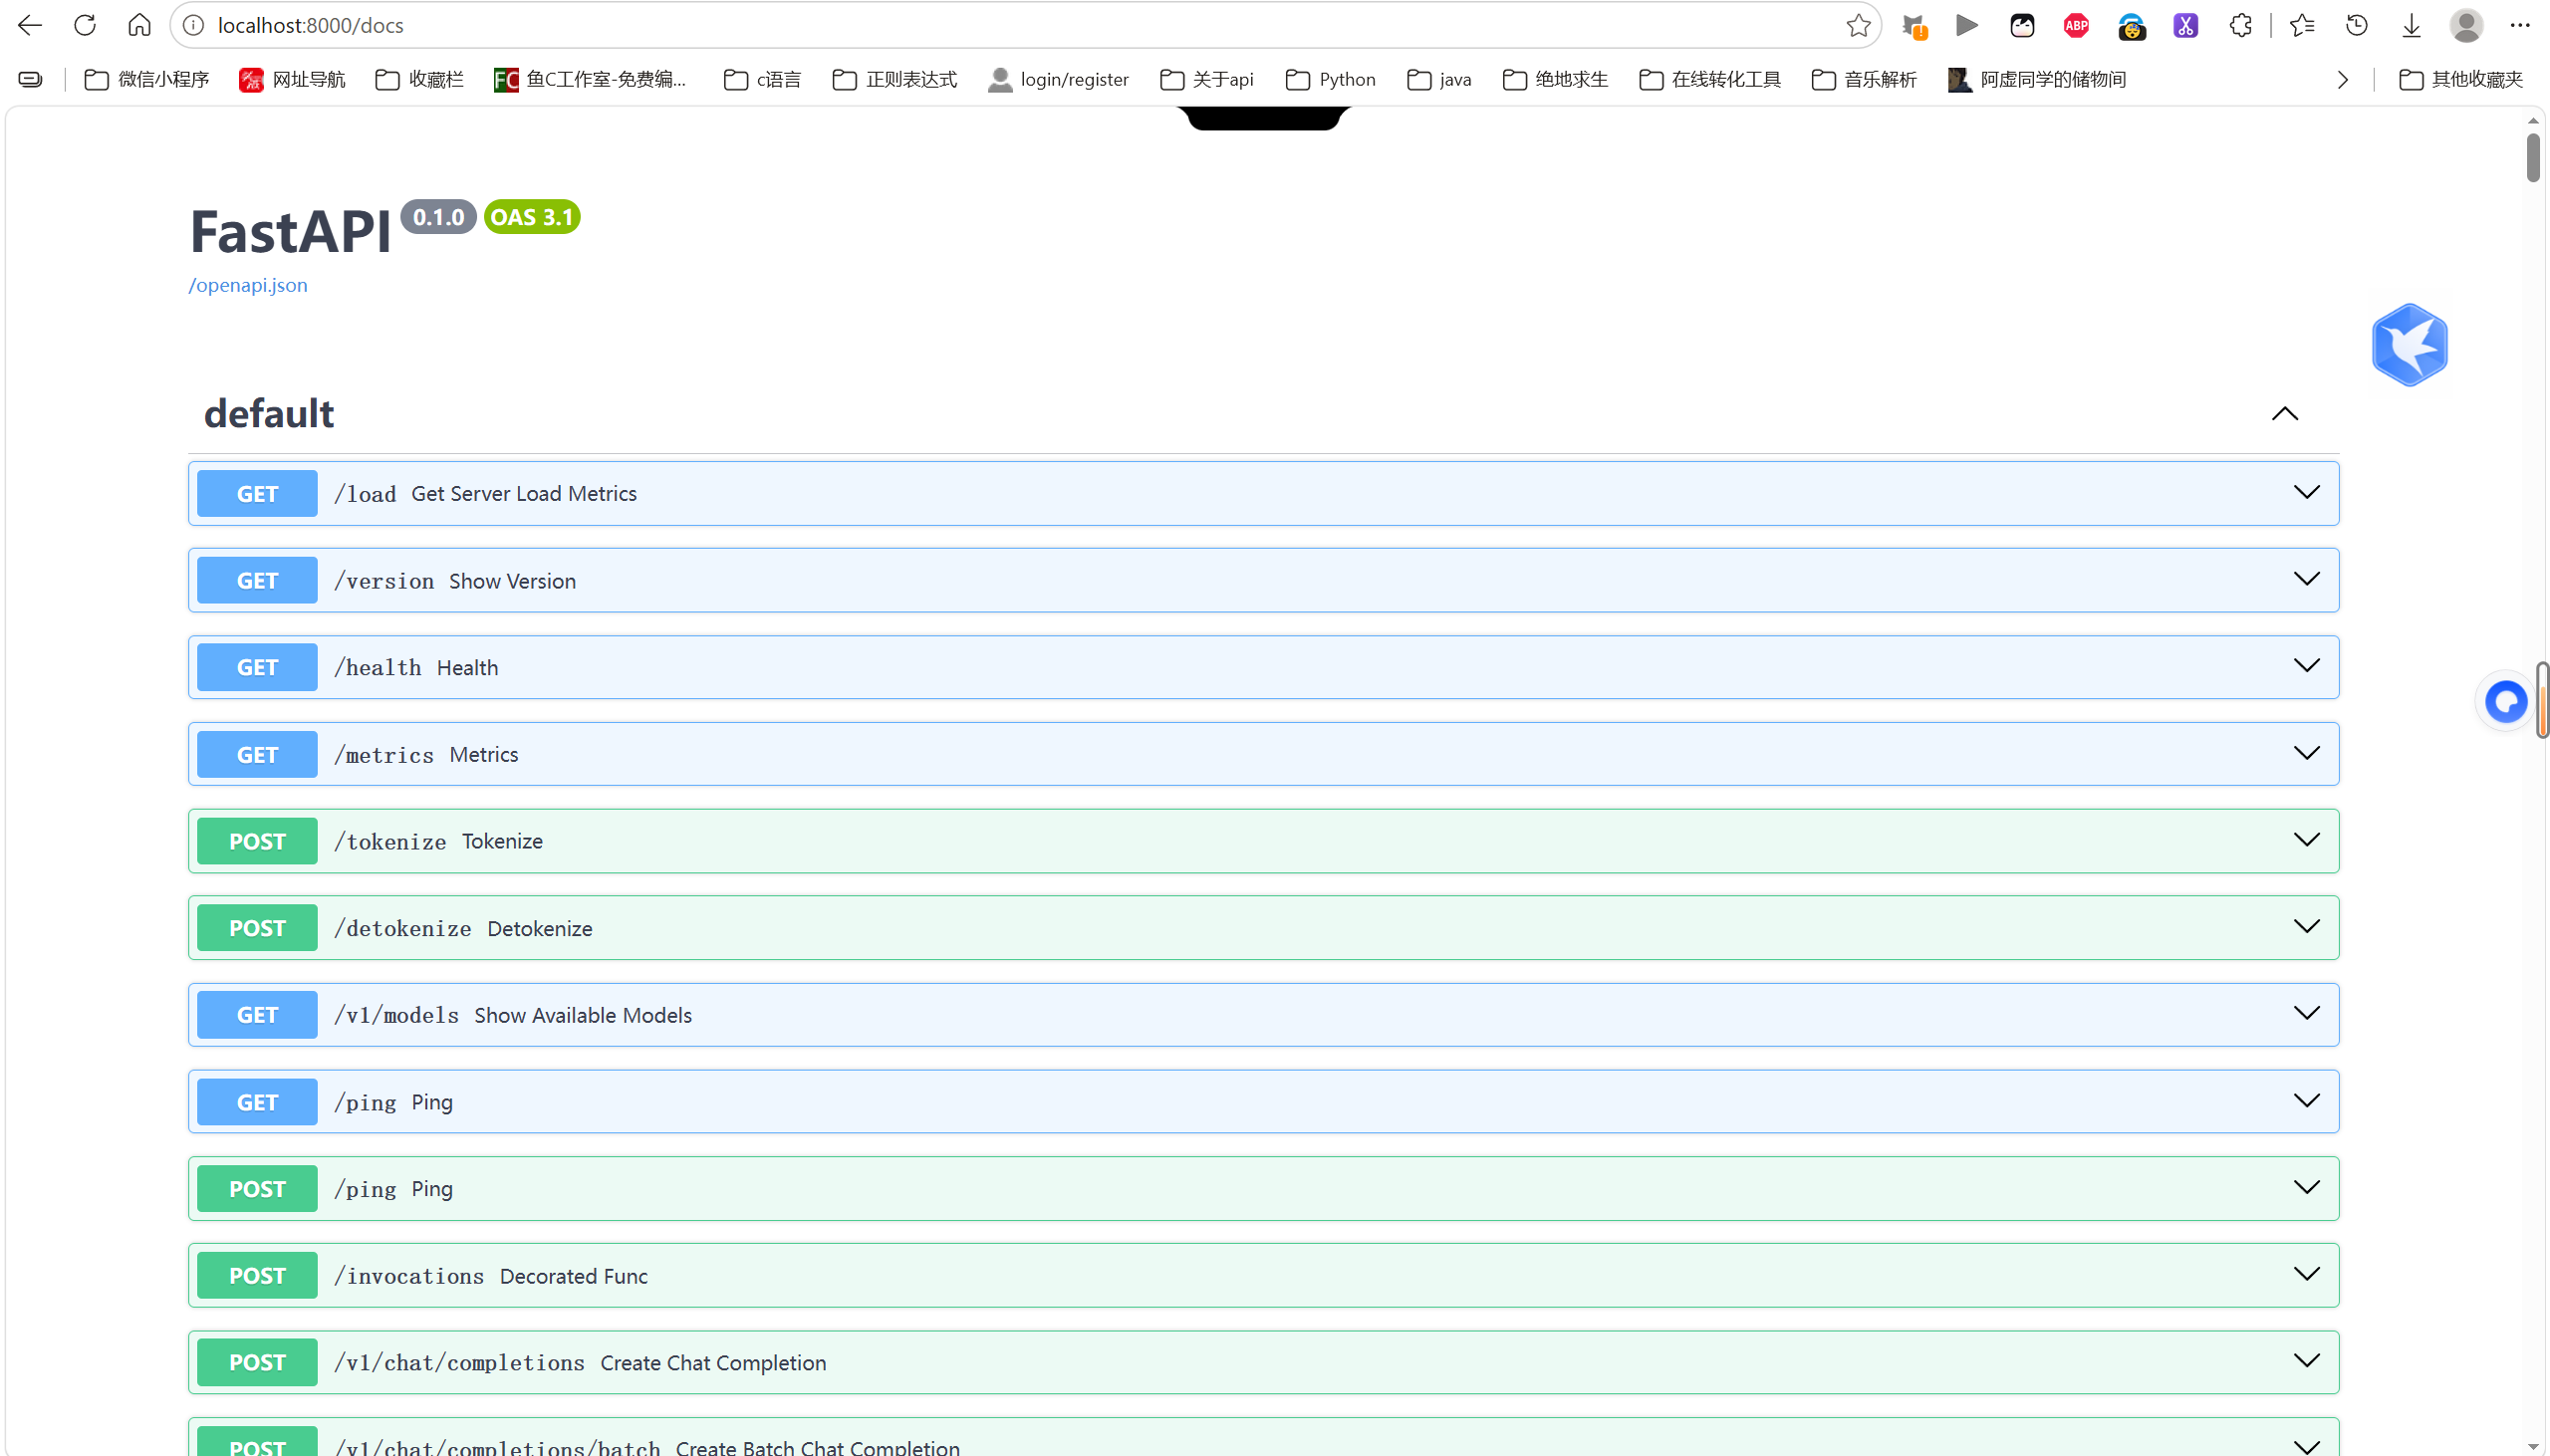
例如调试/v1/chat/completionsate接口
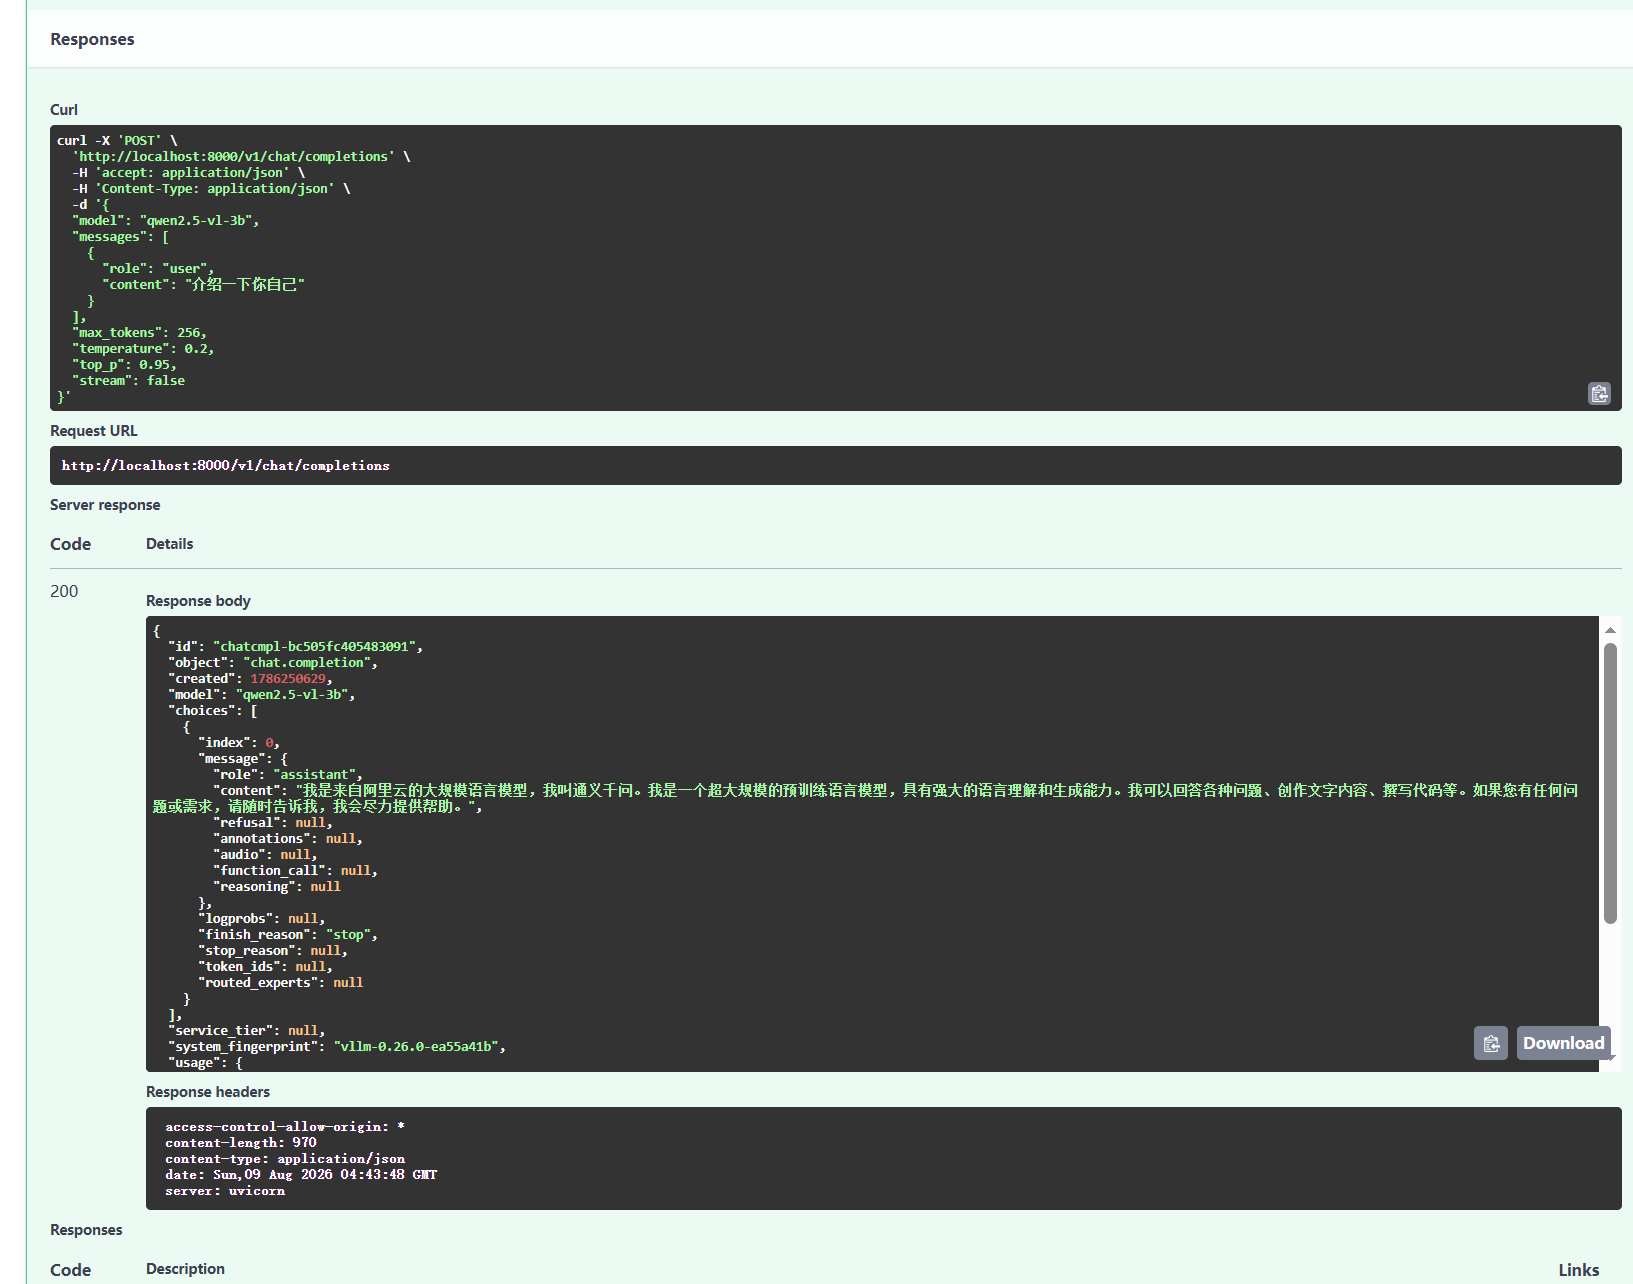
5.3 方式三:curl 命令行
[PowerShell]
# 方式一:内联(单引号包裹,JSON 内部的双引号必须写成 \" 转义形式)
curl.exe http://localhost:8000/v1/chat/completions -H "Content-Type: application/json" -d '{\"model\":\"qwen2.5-vl-3b\",\"messages\":[{\"role\":\"user\",\"content\":\"你好,用一句话介绍自己\"}]}'

# 方式二:文件方式(最稳,绕开所有引号/编码问题)
$body = '{"model":"qwen2.5-vl-3b","messages":[{"role":"user","content":"你好,用一句话介绍自己"}]}'
[IO.File]::WriteAllText("$env:TEMP\vllm_body.json", $body, (New-Object System.Text.UTF8Encoding($false)))
curl.exe http://localhost:8000/v1/chat/completions -H "Content-Type: application/json" -d "@$env:TEMP\vllm_body.json"
⚠️ PowerShell 5.1 引号坑(实测):PowerShell 5.1 调原生程序时不转义参数内部的双引号,
-d '{"model":...}'(纯单引号)会把 JSON 拆碎,vLLM 报JSON decode error / Expecting property name enclosed in double quotes。
- 方式一必须把 JSON 里的
"写成\"(单引号包裹 + 反斜杠转义),curl 会把它还原成正常 JSON。这是本机实测唯一能一行跑通的内联写法。- 方式二文件方式最稳:UTF-8 无 BOM 的 JSON 文件(
WriteAllText+UTF8Encoding($false)),绕开命令行引号与编码的一切问题。- 中文实测正常:curl.exe 按 UTF-8 处理命令行,vLLM 返回干净 UTF-8;若响应中文在 GBK 控制台显示乱码,只是显示问题——改用
.\test_vllm.ps1查看即可。- 如果用的是 PowerShell 7.3+,纯单引号
'{"model":...}'也可以直接工作。
5.4 接口速查
| 接口 | 路径 | 用途 |
|---|---|---|
| 模型列表 | GET /v1/models | 确认服务在线 |
| 对话(OpenAI 格式) | POST /v1/chat/completions | 文本 + 图片(image_url 传 base64) |
| 补全 | POST /v1/completions | 纯文本 |
完全兼容 OpenAI SDK,任何语言/工具(Python、Node、Postman)都能调。
第 6 部分:踩坑全记录(重点)
按遇到顺序排列,每条含:现象 → 原因 → 解决。本部分是最有价值的经验。
6.1 驱动太老:found version 12000
- 现象:
torch.cuda.is_available()返回 False,报驱动太老 - 原因:旧驱动 526.56 只支持 CUDA 12.0,而 torch 2.11+cu130 需要新驱动
- 解决:升级到 610.88(见 1.3)
6.2 FA2 报错:FA2 is only supported on devices with compute capability >= 8
- 现象:日志大量 ERROR,但不影响启动
- 原因:GTX 1650 是 Turing 架构(7.5),vLLM 想用 FlashAttention-2(需 8.0+)失败后自动回退
- 解决:忽略即可
6.3 UVA 不可用:RuntimeError: UVA is not available
- 现象:引擎初始化直接失败
- 原因:vLLM 0.26 的 staged-writes 需要 CUDA pinned memory,而 vLLM 在 WSL2 下默认禁用 pinned memory
- 解决:启动脚本加环境变量:
export VLLM_WSL2_ENABLE_PIN_MEMORY=1
6.4 KV cache 负内存:Available KV cache memory: -0.09 GiB
- 现象:权重加载成功(
Model loading took 3.32 GiB),但 KV cache 内存为负数,启动失败 - 原因:vLLM 用
初始化后剩余显存(3.22GiB) - 权重(3.32GiB)计算 KV cache 空间——4GB 卡上权重本身就超了"初始化后可用",公式结果为负 - 解决:见 6.7(
--kv-cache-memory-bytes绕过)
6.5 --cpu-offload-gb 无效(AWQ 模型)
- 现象:加
--cpu-offload-gb 1.2后,Model loading took 3.32 GiB不变,KV cache 依旧负数 - 原因:vLLM 0.26 的 offloader 在模型构建时(
make_layers)wrap 模块,此时参数还在 CPU 上直接被跳过;真正的权重在后续load_weights阶段直接进显存,offload 根本没机会生效。实测对 AWQ/多模态模型无效 - 解决:放弃 offload,改用 6.7 的方案
6.6 GGUF 方案否决
- 现象:
Qwen2.5-VL-3B-Instruct-GGUF的 Q4 版最小(~2.3GB) - 原因:vLLM 0.26 不支持多模态模型的 GGUF(
--quantization gguf对 VL 模型直接报错);hf-mirror 也没有该仓库的 GGUF 文件 - 解决:回到 AWQ 路线,用 6.7 极限压榨
6.7 ⭐ 最终突破:--kv-cache-memory-bytes 手动指定
- 原理:vLLM 0.26 加载权重用的是专用 weights 内存池(
_maybe_get_memory_pool_context),能用到接近 4GB 全部;加载后实际剩余 ~143 MB。但 KV cache 计算仍用初始化后free - 权重的错误公式 → 负数 - 解决:手动指定 KV cache 大小,跳过这个公式:
同时把--kv-cache-memory-bytes 134217728 # 128 MiB--max-model-len降到 512、--max-num-seqs 1、--enforce-eager(省 CUDA graph 显存),把显存全部让给权重 - 效果:
init engine (profile, create kv cache, warmup model) took 23.50 s成功,API 正常服务
6.8 WSL 崩溃:0x800705aa(系统资源不足)
- 现象:复制 3.4GB 模型文件或服务运行时,WSL 突然挂掉,所有
wsl命令报Wsl/Service/CreateInstance/CreateVm/HCS/0x800705aa - 原因:WSL2 虚拟机瞬时资源不足(大文件复制 + 多进程同时进行)
- 解决:
等 10 秒后再用[PowerShell] wsl --shutdown # 彻底重启 WSL 虚拟机wsl即恢复。注意:这会杀掉 WSL 里所有进程(包括 vLLM),需要重新启动服务
6.9 图片 token 超限:Input length (767) exceeds model's maximum context length (512)
- 现象:传真实图片(1000×968)报 400 Bad Request
- 原因:Qwen2.5-VL 把图切成 28×28 的 patch,每 patch = 1 token。1000×968 的图缩放 768px 后 = ~760 token,超 512 上限
- 解决:图片缩放 ≤448px(448/28 = 16 列 × 16 行 = 256 token,留足文本余量)。
test_vllm.ps1已内置自动缩放
6.10 PowerShell 脚本中文乱码(两个坑)
- 坑 1:
.ps1文件里有中文注释,直接运行报语法错误- 原因:Windows PowerShell 5.1 按 GBK 解析无 BOM 的 UTF-8 文件,中文乱码导致引号配对错乱
- 解决:文件存为 UTF-8 with BOM(VSCode 右下角编码选"UTF-8 with BOM")
- 坑 2:脚本里
Invoke-RestMethod拿到的中文回答变乱码- 原因:PowerShell 5.1 对无 charset 的 JSON 响应默认按 Latin-1 解码
- 解决:改用
Invoke-WebRequest拿原始字节手动按 UTF-8 解码:$rawResp = Invoke-WebRequest -Uri $url -Method Post -ContentType "application/json; charset=utf-8" -Body $body $resp = [System.Text.Encoding]::UTF8.GetString($rawResp.RawContentStream.ToArray()) | ConvertFrom-Json
6.11 漏下载小文件:vocab and merges must be both be from memory or both filenames
- 现象:启动时 tokenizer 加载报错
- 原因:下载流程在
model.safetensors完成后提前报"完成",漏了最后 5 个小文件(tokenizer.json、vocab.json等) - 解决:检查 Windows 侧文件清单(3.2),缺哪个补哪个,再复制进 WSL
第 7 部分:已知限制
| 限制 | 说明 |
|---|---|
| 上下文长度 | 固定 512 token(图片+文字总长),长文档识别不支持 |
| 图片大小 | 需 ≤448px(28×28=1 token 折算),大图自动缩放会丢细节 |
| 并发 | 1 个请求(--max-num-seqs 1) |
| 每请求图片数 | 1 张(--limit-mm-per-prompt '{"image": 1}') |
| 速度 | 生成约 1~5 token/s(受显存极限制约,可用但不算快) |
| 稳定性 | WSL 虚拟机可能因资源不足崩溃,崩溃后需重启服务(见 6.8) |
| 显存 | 已被权重占满(~3.9/4.0 GiB),不能再开其他占用显存的程序 |
第 8 部分:命令速查
| 操作 | 终端 | 命令 |
|---|---|---|
| 启动 vLLM | WSL | bash /home/vllm_serve/start_vllm.sh |
| 后台启动(Windows 侧) | PowerShell | wsl -e bash -c "bash /home/vllm_serve/start_vllm.sh" |
| 看日志 | WSL | tail -f /home/vllm_serve/vllm.log |
| 确认进程 | WSL | pgrep -af "vllm serve" |
| 确认服务 | PowerShell | curl.exe http://localhost:8000/v1/models |
| 文本测试 | PowerShell | .\test_vllm.ps1 |
| 图片测试 | PowerShell | .\test_vllm.ps1 -Image "D:\...\图.jpg" |
| 查显存 | PowerShell/WSL | nvidia-smi |
| WSL 崩了重启 | PowerShell | wsl --shutdown 再 wsl |
| 停服务 | WSL | pkill -9 -f "vllm serve" |
附录:本机文件与脚本清单
| 文件 | 位置 | 用途 |
|---|---|---|
start_vllm.sh | /home/vllm_serve/(WSL) | vLLM 启动脚本(最终版) |
vllm.log | /home/vllm_serve/(WSL) | 服务日志 |
test_ocr.py | /home/vllm_serve/(WSL) | 生成本机 OCR 测试图并调用 |
test_vllm.ps1 | C:\Users\Ameng\Desktop\claude_woker\vllm_windows\ | Windows 一键测试(文本/图片) |
download_model.ps1 | Windows 任意目录 | hf-mirror 下载模型 |
| 模型权重 | E:\WSL\downloads\models\Qwen2.5-VL-3B-Instruct-AWQ\(下载源)→ /home/vllm_serve/models/Qwen2.5-VL-3B-Instruct-AWQ\(运行目录) | 模型文件 |
| 驱动 | E:\WSL\downloads\drivers\610.88-notebook-win10-win11-64bit-international-dch-whql.exe | 显卡驱动安装包 |
虚拟环境:/home/vllm_serve/venv(Python 3.12.3,vllm 0.26.0,torch 2.11.0+cu130)
最终启动参数摘要(一句话记住):AWQ 权重 + VLLM_WSL2_ENABLE_PIN_MEMORY=1 + --kv-cache-memory-bytes 134217728 + --max-model-len 512 + --enforce-eager + --max-num-seqs 1。
番外:Ollama 轻量替代方案实测记录(同一模型)
本篇正文用 vLLM 极限压榨跑通 Qwen2.5-VL-3B;若你需要更大的上下文(如长文档、长截图分析),Ollama 是更省心的轻量替代——同一个模型(
qwen2.5vl:3b,Q4_K_M 量化,~2.7 GB),Windows 原生运行,一条命令常驻。以下为 2026-08-09 本机实测记录。
番外 1:部署概况
| 项目 | 值 |
|---|---|
| Ollama 版本 | 0.32.6(Windows 原生,非 WSL) |
| 模型 | qwen2.5vl:3b(Q4_K_M 量化,权重 ~2.7 GB) |
| 模型库 | E:\model\ollama_model(环境变量 OLLAMA_MODELS 指定) |
| 服务地址 | http://localhost:11434(OpenAI 兼容:/v1/chat/completions) |
| 热启动 | ~6 s(模型已加载时) |
番外 2:Ollama 是常驻服务,不需要每次推理都启动
很多人的误解(包括当时的我):以为 Ollama 每次推理都要"启动"。实际上:
ollama.exe serve      ← 常驻服务,像 vLLM 的进程一样一直挂着(监听 11434)
   └─ llama-server    ← 模型进程,第一次请求时加载(冷启动 ~10~20s),
                        之后 OLLAMA_KEEP_ALIVE(默认 5 分钟)内保持"热",
                        连续请求秒级响应,不会重复加载
[PowerShell]
ollama serve                    # 启动/恢复常驻服务(或用桌面托盘图标)
ollama ps                       # 查看当前加载的模型(还在内存里就是"热"的)
体验要点:模型加载一次后,5 分钟内连续用都很快;隔久了模型自动卸载,下次请求重新加载(1020s)。想模型一直驻留可设
OLLAMA_KEEP_ALIVE=-1(永久驻留,占 ~2.7GB 显存 + RAM)。
番外 3:上下文 vs 速度(实测数据,核心结论)
同一个模型,上下文大小直接决定速度——这是"感觉慢"的真正元凶,不是 Ollama 本身:
| 上下文长度 | 纯文本生成速度 | 说明 |
|---|---|---|
| 8192 | 13.4 token/s | 默认 f16 KV,日常推荐 |
| 16384 | ~5 token/s | 明显变慢,长文档才值得 |
[PowerShell]
# 测速命令(生成 220 token 计时,看响应里 eval_count / 耗时)
curl.exe http://localhost:11434/api/generate -H "Content-Type: application/json" -d '{"model":"qwen2.5vl:3b","prompt":"请写一篇关于夏天的短文,大约200字。","options":{"num_ctx":8192,"num_predict":220},"stream":false}'
番外 4:q8_0 KV 量化实验(踩坑:别设!)
想让 KV cache 减半、提速——实测无效且有害:
- 现象:设置
OLLAMA_KV_CACHE_TYPE=q8_0后,纯文本 12 token/s(与默认 13.4 无本质差异),但图片请求直接把服务卡死(llama-server 进程活着、占着显存不释放,API 不再响应任何请求) - 原因:llama.cpp 的多模态(vision)路径与 KV 量化的兼容问题
- 处理:回退默认配置,恢复正常:
[PowerShell]
# 删除 q8_0 设置(恢复默认 f16 KV)
[Environment]::SetEnvironmentVariable('OLLAMA_KV_CACHE_TYPE', $null, 'User')
# 然后杀干净重启服务(务必连残留的 llama-server 一起杀)
Stop-Process -Name "ollama*","llama-server*" -Force -ErrorAction SilentlyContinue
Start-Sleep -Seconds 3
ollama serve
⚠️ 踩过的坑:残留的 llama-server 进程会导致新 Ollama 实例卡死(监听 11434 但 API 无响应)。重启服务前一定要用
Stop-Process -Name "llama-server*"清干净。
番外 5:Ollama vs vLLM 怎么选(本机 4GB 卡实测)
| 维度 | vLLM(WSL,本篇正文) | Ollama(Windows 原生) |
|---|---|---|
| 上下文上限 | 512(极限压榨后的妥协) | 8192+ 随意设置 |
| 图片上限 | ≤448px | ≤1024px |
| 纯文本速度 | 快(GPU 直算) | 8192 上下文下 ~13 token/s |
| 冷启动 | 1.5~2 分钟 | 1020s |
| 运维复杂度 | 手动启停、日志排查 | 一条命令常驻,托盘管理 |
| 适用场景 | 高频 OCR 短任务(快) | 需要大上下文的长文档/长截图 |
一句话选择:主要是 OCR 识别、追求速度 → vLLM;要看长文档、要省心 → Ollama(上下文设 8192 即可,别贪大)。
番外 6:Ollama 推荐配置(Cherry Studio 侧)
| 配置项 | 推荐值 | 理由 |
|---|---|---|
| 上下文长度 | 8192 | 实测 13.4 token/s;16384 会掉到 ~5 |
| 最大输出 | 2048 | 5 token/s 下 2048 ≈ 7 分钟上限,再大没人等 |
| 温度 | 不动(默认 0.0001) | 对 OCR/文字提取极稳,调高会开始"脑补"错字 |
| 图片尺寸 | ≤1024px(OCR 建议 448~768px) | 768px 图 ≈ 760 token,8192 内绰绰有余 |
Cherry Studio 路径:设置 → 模型服务 → Ollama →
qwen2.5vl:3b→ 上下文长度填8192。
下期预告:我们将基于本篇部署的 vLLM 服务,编写中间件将 Qwen2.5-VL 封装为 API,并与 DeepSeek API 串联,实现真正的“看图说话”智能助手。
更多推荐
 14
 0
- 0


 已为社区贡献5条内容

所有评论(0)