
GPT Image 2 + Seedance 2.0故事板工作流完全指南从分镜到成片的 AI 视频制作教程
适用人群:短视频创作者 · 品牌营销 · 独立游戏开发者 · AI 内容创作者
目录
1. 为什么 GPT Image 2 + Seedance 2.0 是当前最强 AI 视频工作流?
2. 两个模型各自擅长什么?
3. 开始之前你需要准备什么?
4. 核心方法论:先锁画面,再加运动
5. 完整 6 步工作流
6. 实战案例一:时尚穿搭扫描视频
7. 实战案例二:中世纪集市电影短片
8. 实战案例三:3×3 故事板网格动画
9. 可复制的 Prompt 模板
10. Seedance 2.0 @ 引用系统详解
11. 进阶技巧
12. 常见错误与避坑指南
13. 适用场景一览
14. FAQ 常见问题
1. 为什么 GPT Image 2 + Seedance 2.0 是当前最强 AI 视频工作流?
2026 年 AI 视频创作的核心问题已经不是"选哪个模型",而是如何组合多个模型形成工作流。GPT Image 2(OpenAI,2026 年 4 月 21 日发布)和 Seedance 2.0(字节跳动/豆包)是目前最实用的一对组合。
原因很简单:
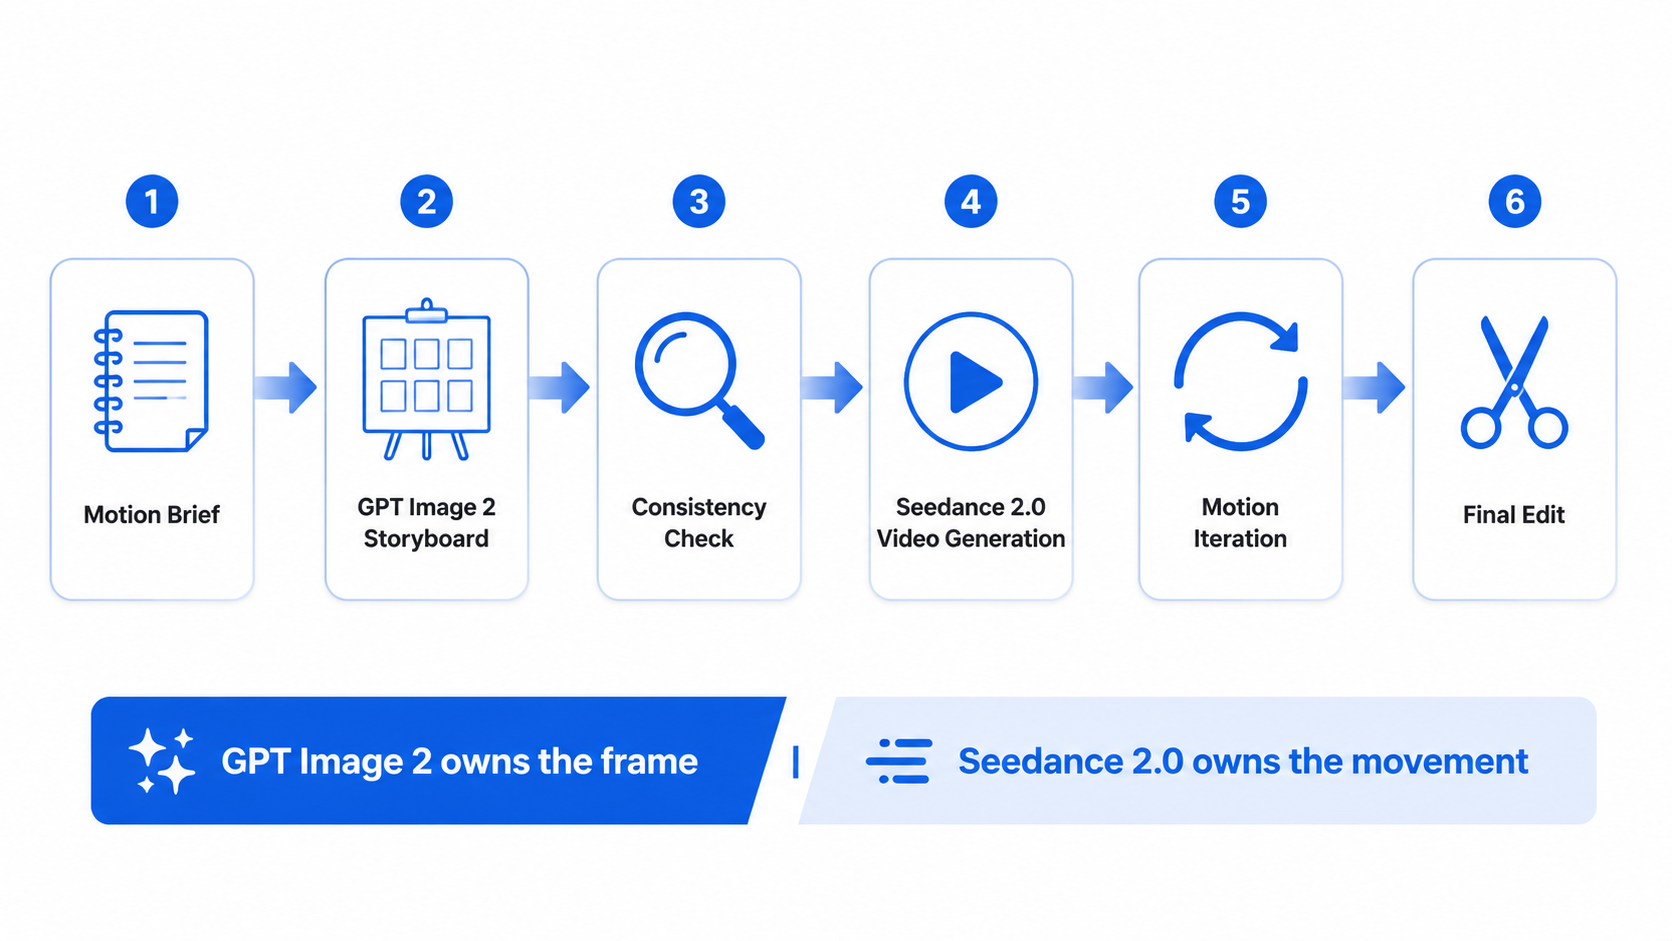
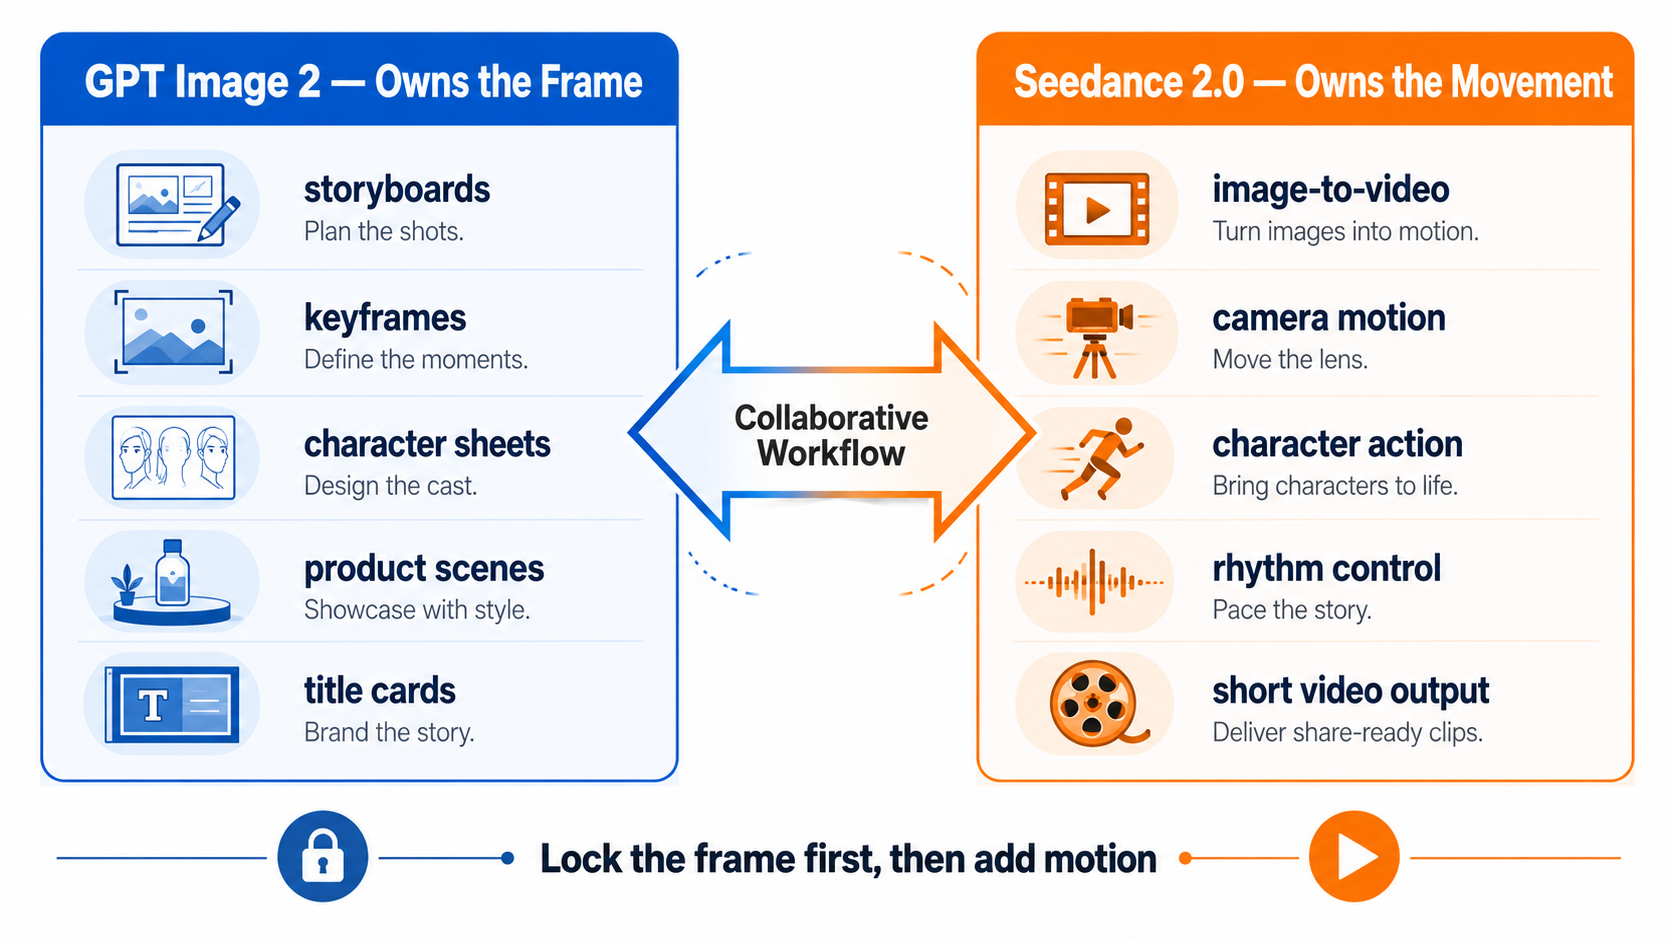
- GPT Image 2 负责视觉设计——故事板、关键帧、角色设定、标题卡
- Seedance 2.0 负责运动执行——图生视频、镜头运动、节奏控制
这种分工比强迫一个模型在单次 prompt 中完成所有事情要稳定得多。核心逻辑是:让 GPT Image 2 画好"是什么样",让 Seedance 2.0 决定"怎么动"。
2. 两个模型各自擅长什么?
理解这两个模型的最佳方式是按生产阶段划分,而不是按"谁更强"来比较:
|
维度 |
GPT Image 2 |
Seedance 2.0 |
|
核心角色 |
前期视觉设计 |
运动与短视频生成 |
|
最佳输入 |
文本 + 可选图片参考 |
文本、图片、音频、视频 |
|
擅长产出 |
故事板网格、关键帧、角色设定、产品场景、标题卡 |
图生视频、镜头运动、角色动作、短片输出 |
|
核心优势 |
99%+ 文字渲染准确率、强构图控制、多风格支持 |
多模态参考控制、角色一致性、电影级运镜 |
|
不擅长 |
生成动态视频 |
从零设计视觉风格 |
一句话总结:GPT Image 2 解决"看起来对不对",Seedance 2.0 解决"动起来对不对"。
3. 开始之前你需要准备什么?
- Viddo AI账号 — 集成了包括GPT Image 2和Seedance 2.0在内的众多AI模型
- 一个清晰的创意方向 — 不需要完整脚本,但需要知道"拍什么"——产品广告、短剧、角色动画等。
4. 核心方法论:先锁画面,再加运动
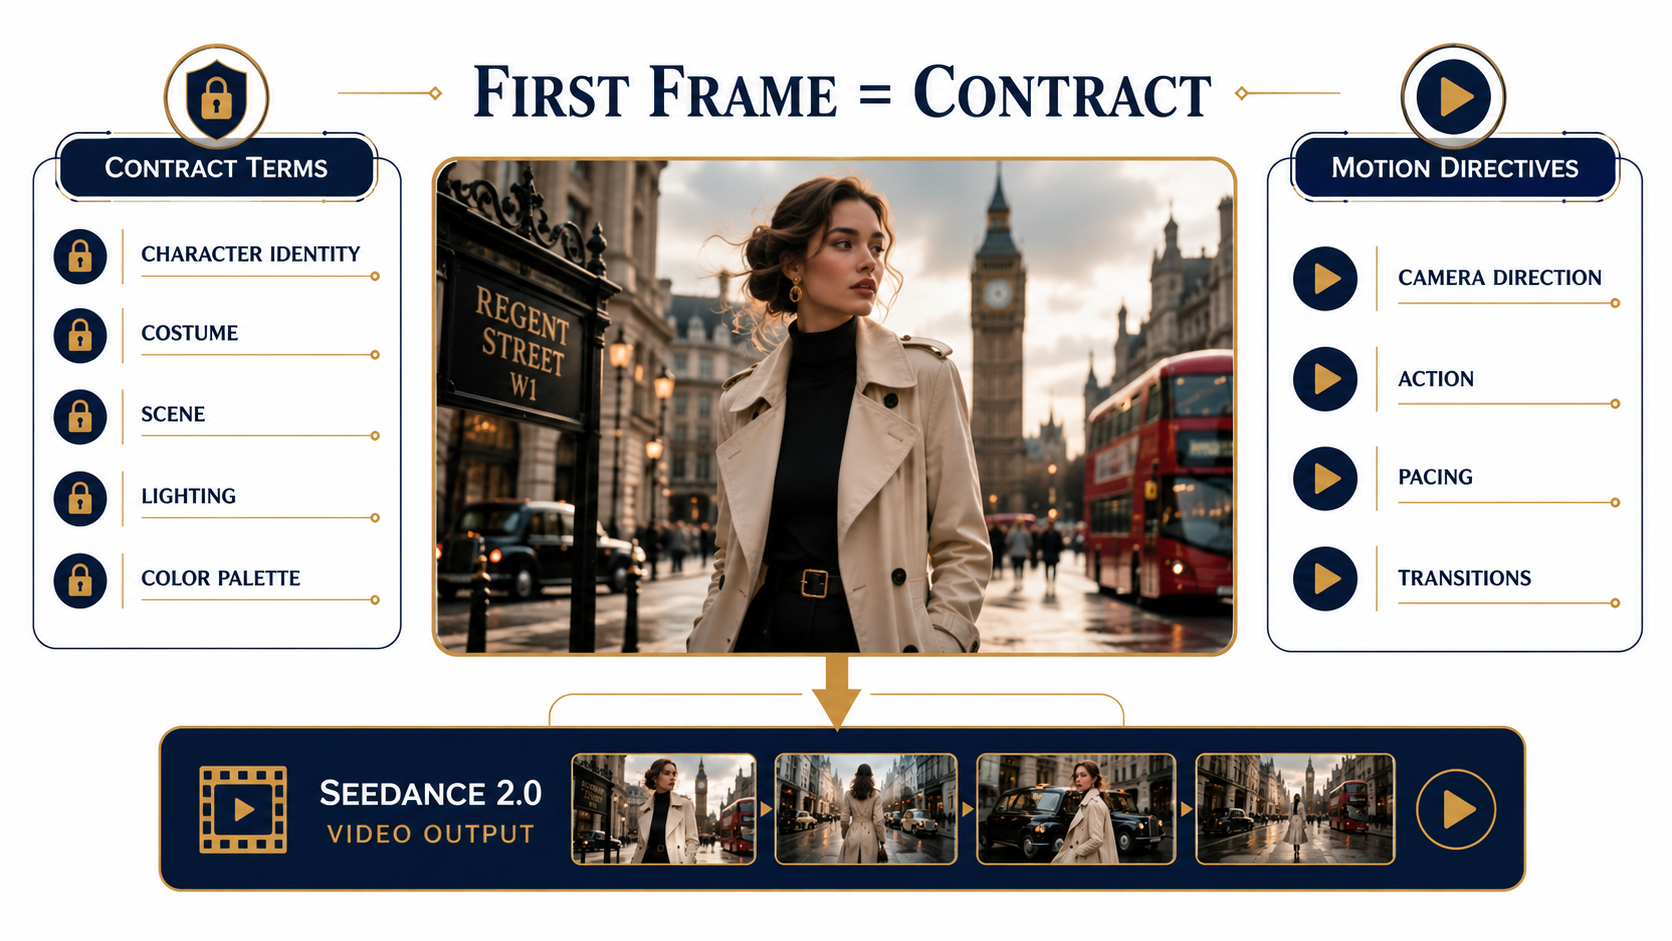
大多数人的错误是把图生视频当作老虎机——扔进去一张图,期待奇迹。更好的生产循环是把第一帧当作一份合同:它定义了视频应该保留什么,而运动 prompt 定义了什么应该变化。
黄金法则:让 GPT Image 2 拥有画面,让 Seedance 2.0 拥有运动。
这意味着:
- 先花时间把故事板做到满意,再进入视频生成
- 不要在 Seedance 里重复描述视觉细节(故事板已经包含了)
- Seedance 的 prompt 只需要关注:怎么动、镜头怎么走、节奏多快
5. 完整 6 步工作流
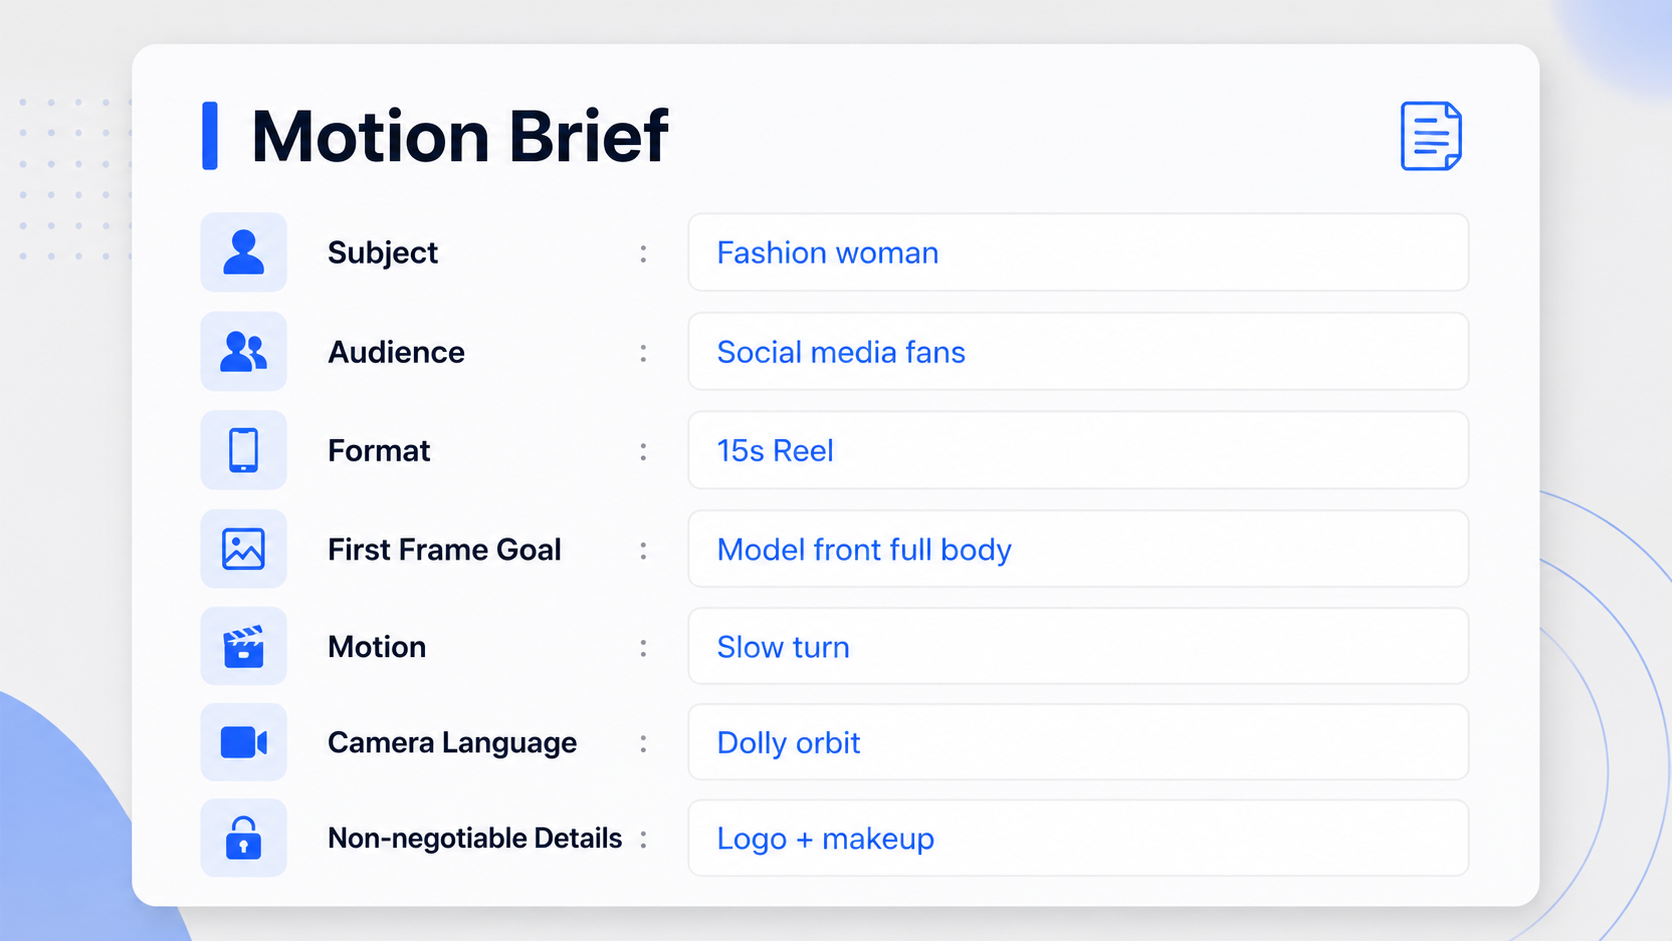
第 1 步:写运动简报(Motion Brief)
在写任何 prompt 之前,先用一段话明确以下要素:
|
要素 |
说明 |
示例 |
|
主题 |
画面主体是什么 |
一位穿黑色西装的女性 |
|
受众 |
给谁看 |
时尚品牌社交媒体粉丝 |
|
格式 |
视频用途 |
15 秒 Instagram Reel |
|
首帧目标 |
视频从什么画面开始 |
模特正面全身,伦敦街头 |
|
运动 |
画面中什么在动 |
模特缓慢转身,镜头环绕 |
|
镜头语言 |
用什么镜头 |
缓慢推轨 + 环绕 |
|
不可妥协的细节 |
必须保留的元素 |
品牌 Logo、服装细节、妆容 |
这个步骤的目的是把视觉设计和运动方向分开,避免 GPT Image 2 去解决运动问题,也避免 Seedance 2.0 重新发明设计。
第 2 步:用 GPT Image 2 生成故事板
根据运动简报,用 GPT Image 2 生成所需的视觉资产。以下提供四种常用方式:
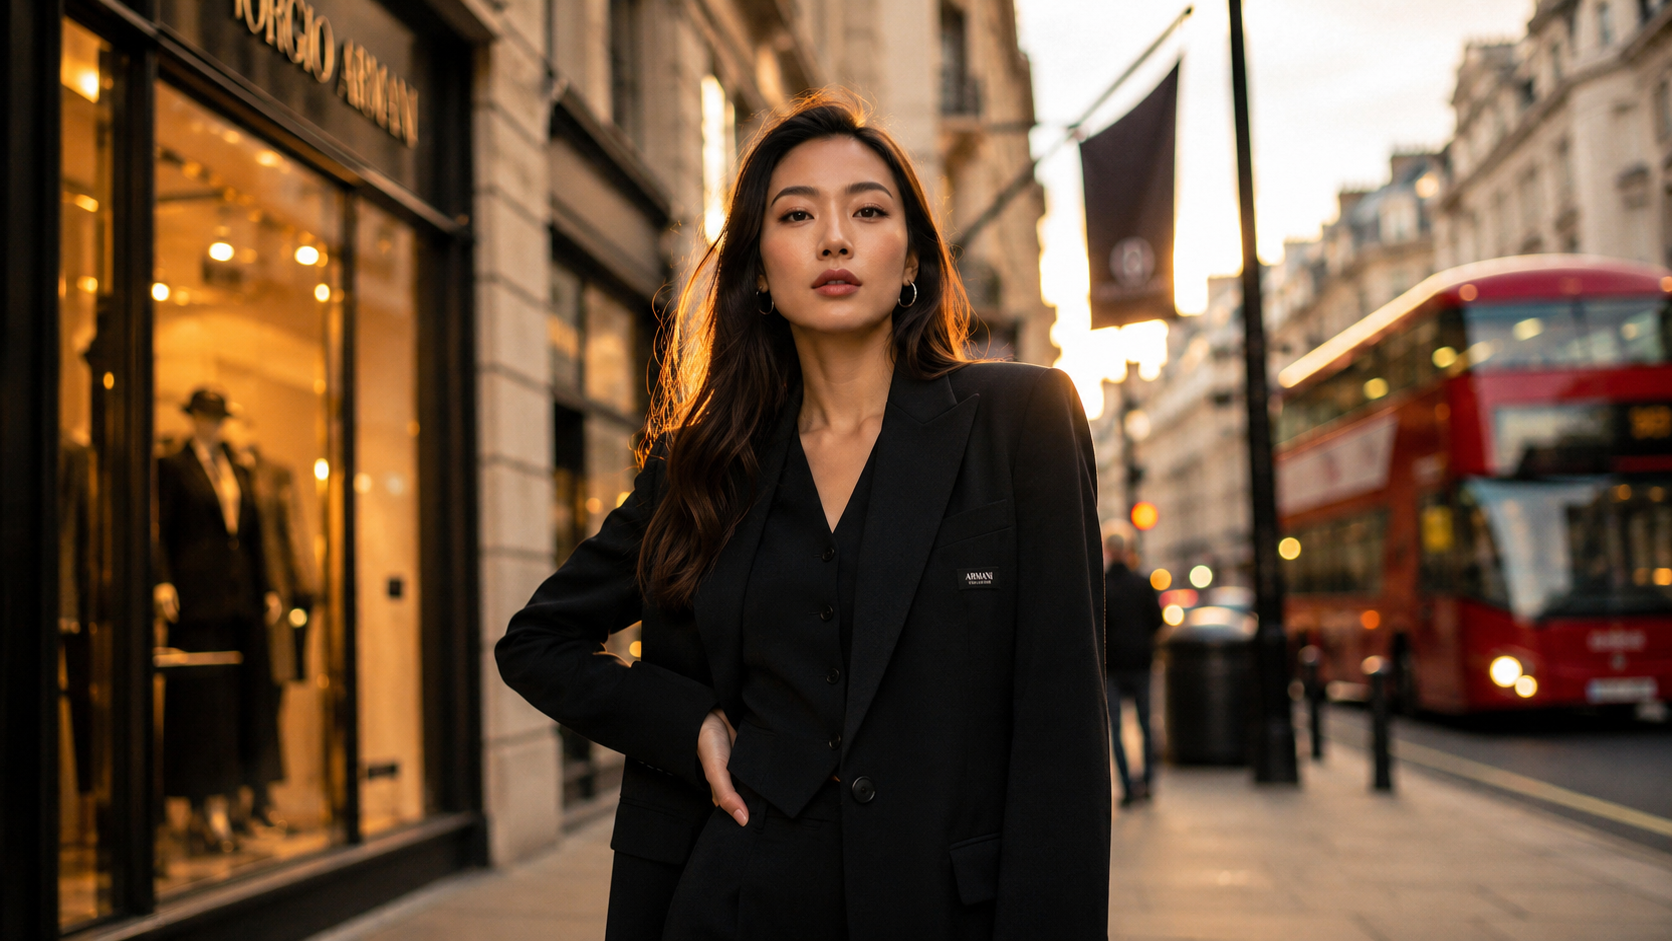
方式 A:单帧关键帧(适合简单场景)
一位穿黑色 Armani 西装的亚洲女性,站在伦敦 Bond Street 街头,
黄昏金色光线,电影质感,35mm 胶片风格,
她正面看向镜头,右手轻搭在腰间,
背景是模糊的奢侈品橱窗和红色双层巴士。
输出为高清单张图片。
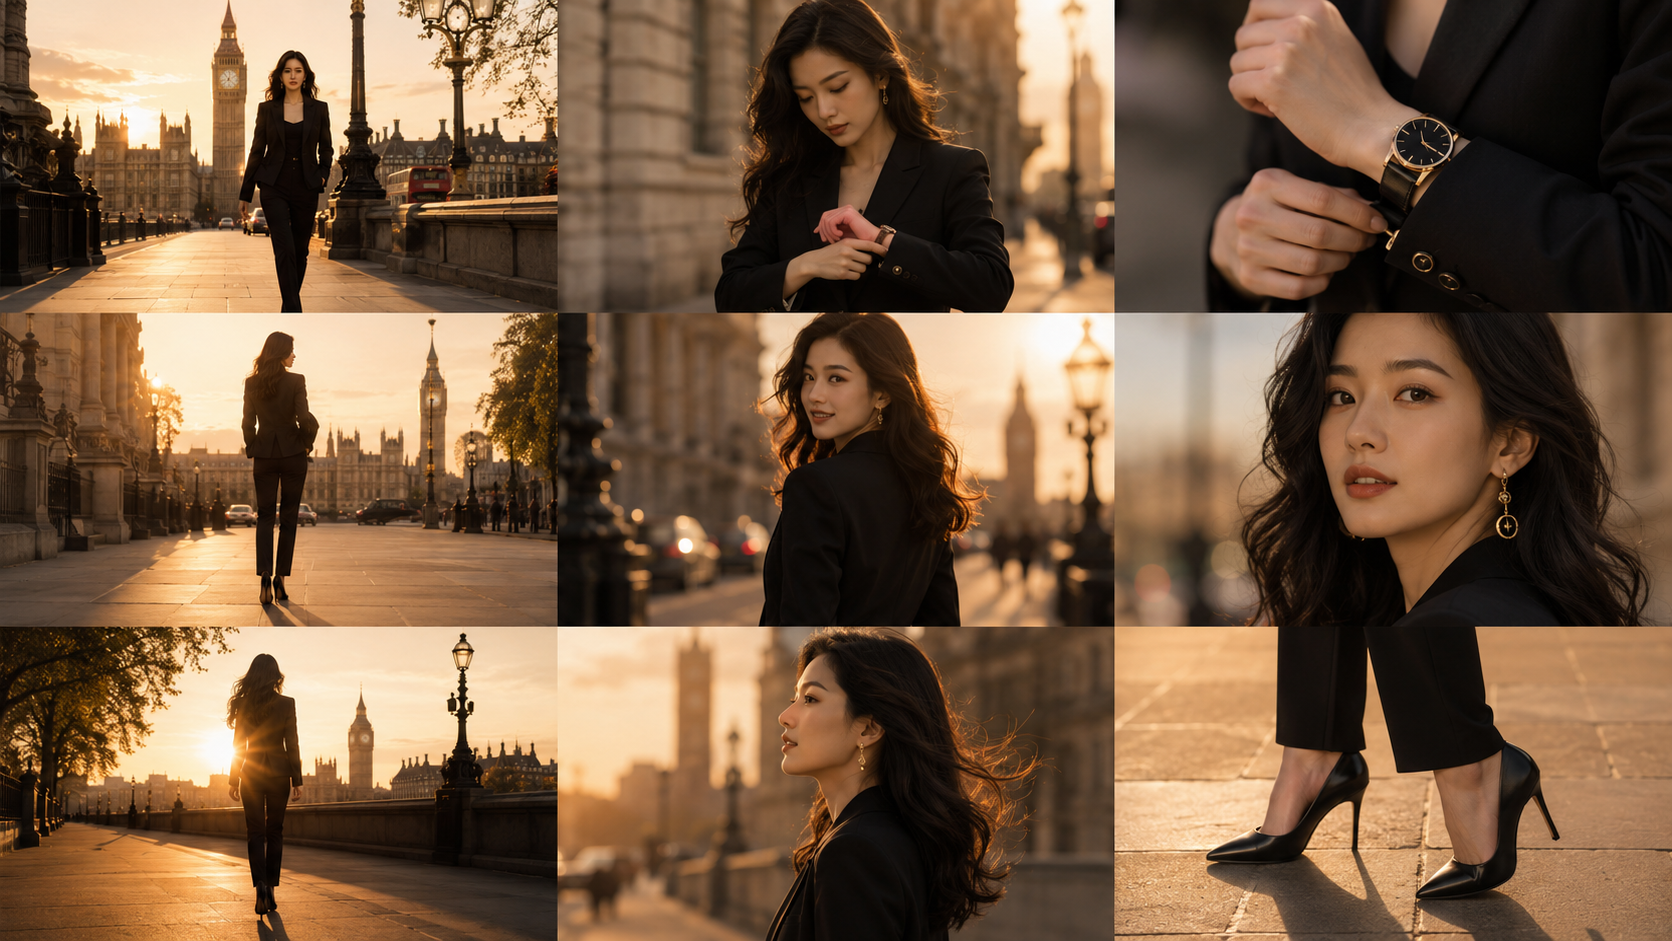
方式 B:3×3 故事板网格(适合多镜头序列)
创建一个 3×3 故事板网格,用于一段 15 秒的时尚穿搭视频:
- 3 列 × 3 行,从左到右、从上到下阅读
- 每格一个清晰镜头,一个动作描述
- 场景:伦敦 Bond Street,黄昏,金色光线
- 镜头序列:
1. 远景建立镜头 - 模特从远处走来
2. 中景 - 模特停下,整理袖口
3. 特写 - 手腕上的手表和袖扣
4. 全身 - 模特转身展示背面剪裁
5. 中景 - 模特回眸微笑
6. 特写 - 面部妆容和耳环
7. 远景 - 模特走入夕阳中
- 保持角色设计、服装、发型、光线在所有格子中一致
- 无文字标签,无格子边框
输出为单张图片。
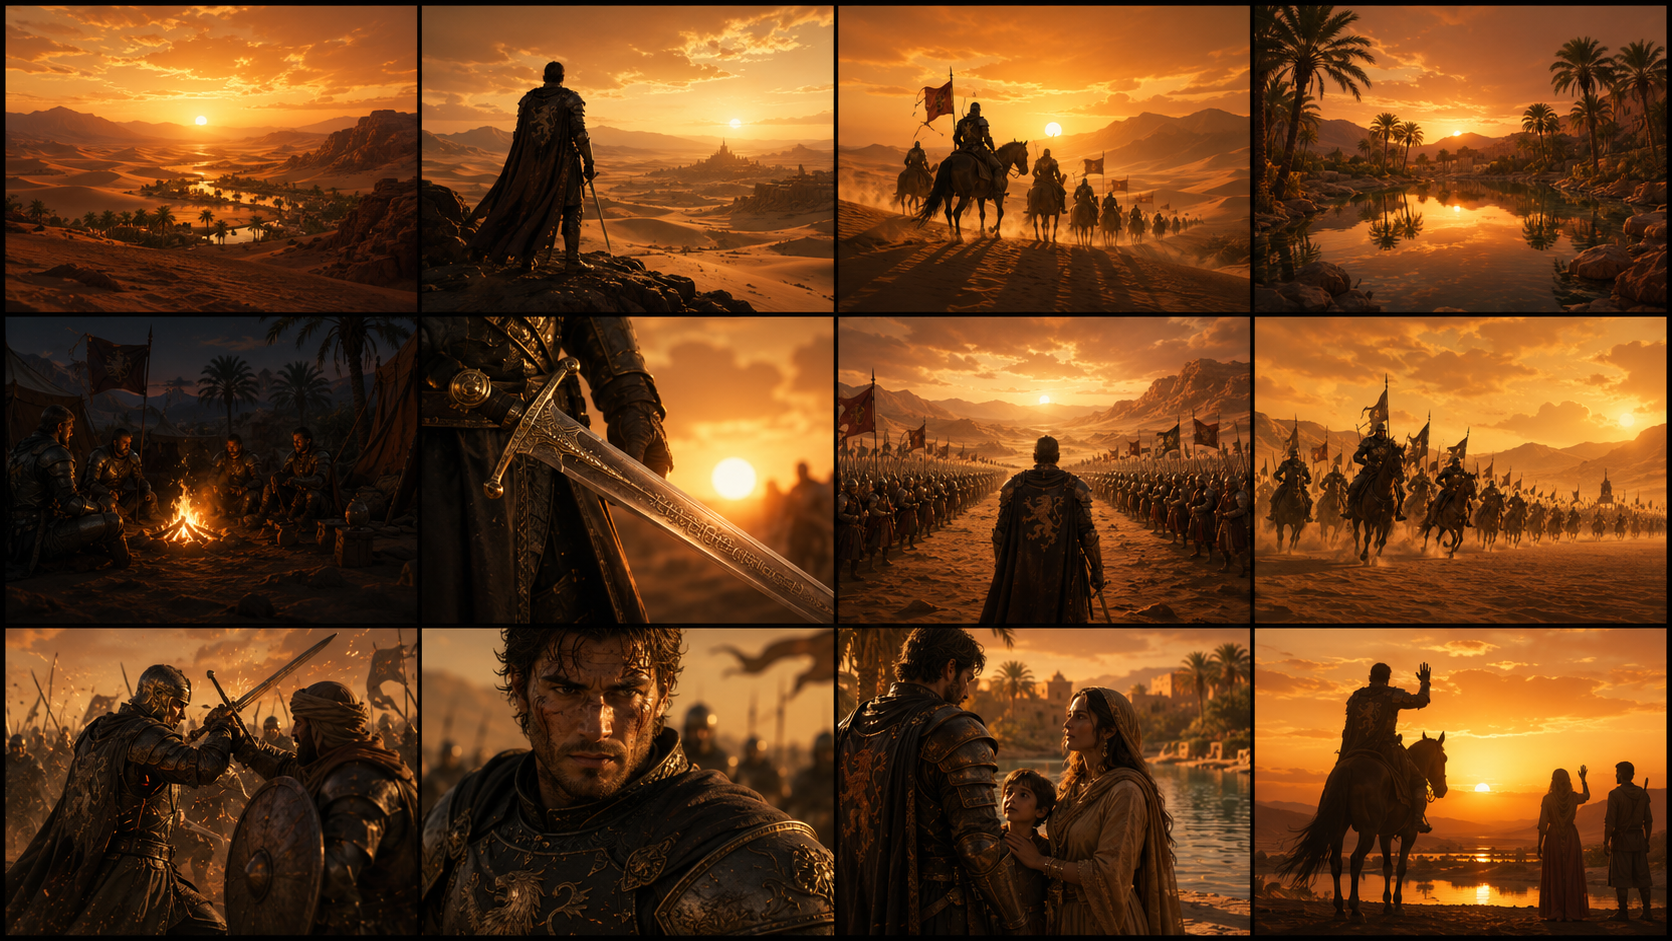
方式 C:12 帧快速剪辑蒙太奇(适合预告片、MV)
为一段 30 秒的电影预告片创建 12 格故事板网格:
- 4 列 × 3 行,从左到右、从上到下阅读
- 每格:一个明确镜头 + 一个动作描述
- 场景:沙漠绿洲,时间:黄昏,氛围:史诗感
- 保持一致的角色设计和场景逻辑
- 无文字标签,无格子边框
输出为单张图片。
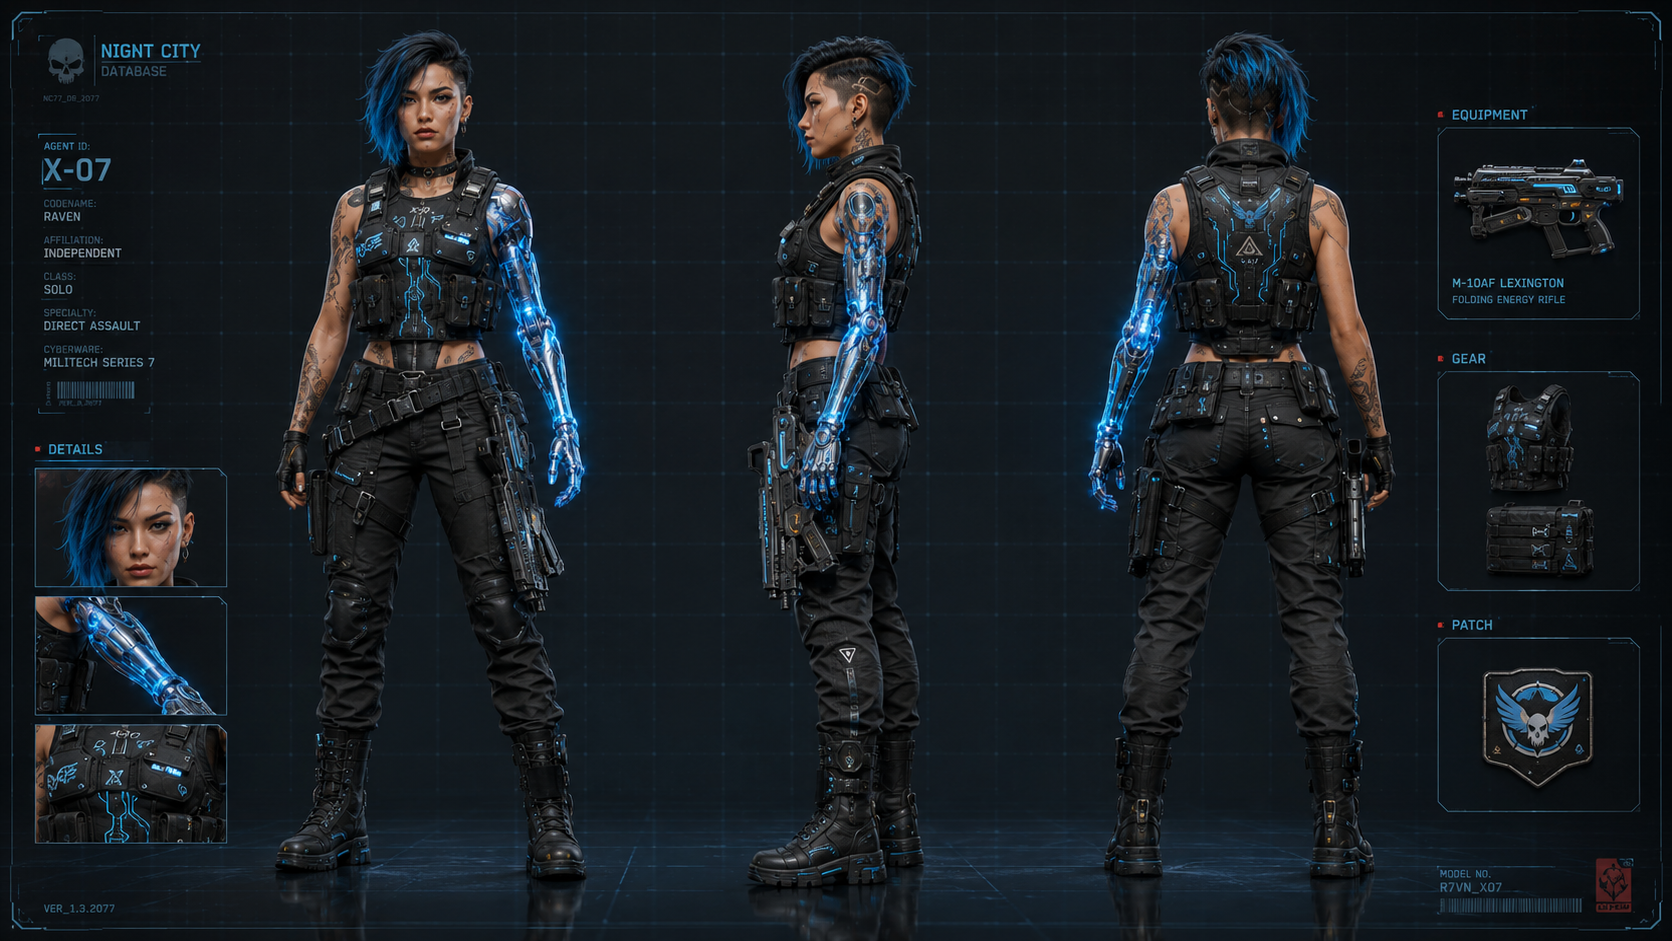
方式 D:角色设定表(适合动画、游戏)
为一位赛博朋克风格的女性战士创建角色设定表:
- 包含正面、侧面、背面三个视角
- 标注服装细节:机械臂、发光纹路、战术背心
- 标注武器:折叠式能量步枪
- 风格:赛博朋克 2077 概念美术风格
- 保持所有视角的服装、发型、体型完全一致
输出为单张图片。
第 3 步:检查一致性,锁定视觉
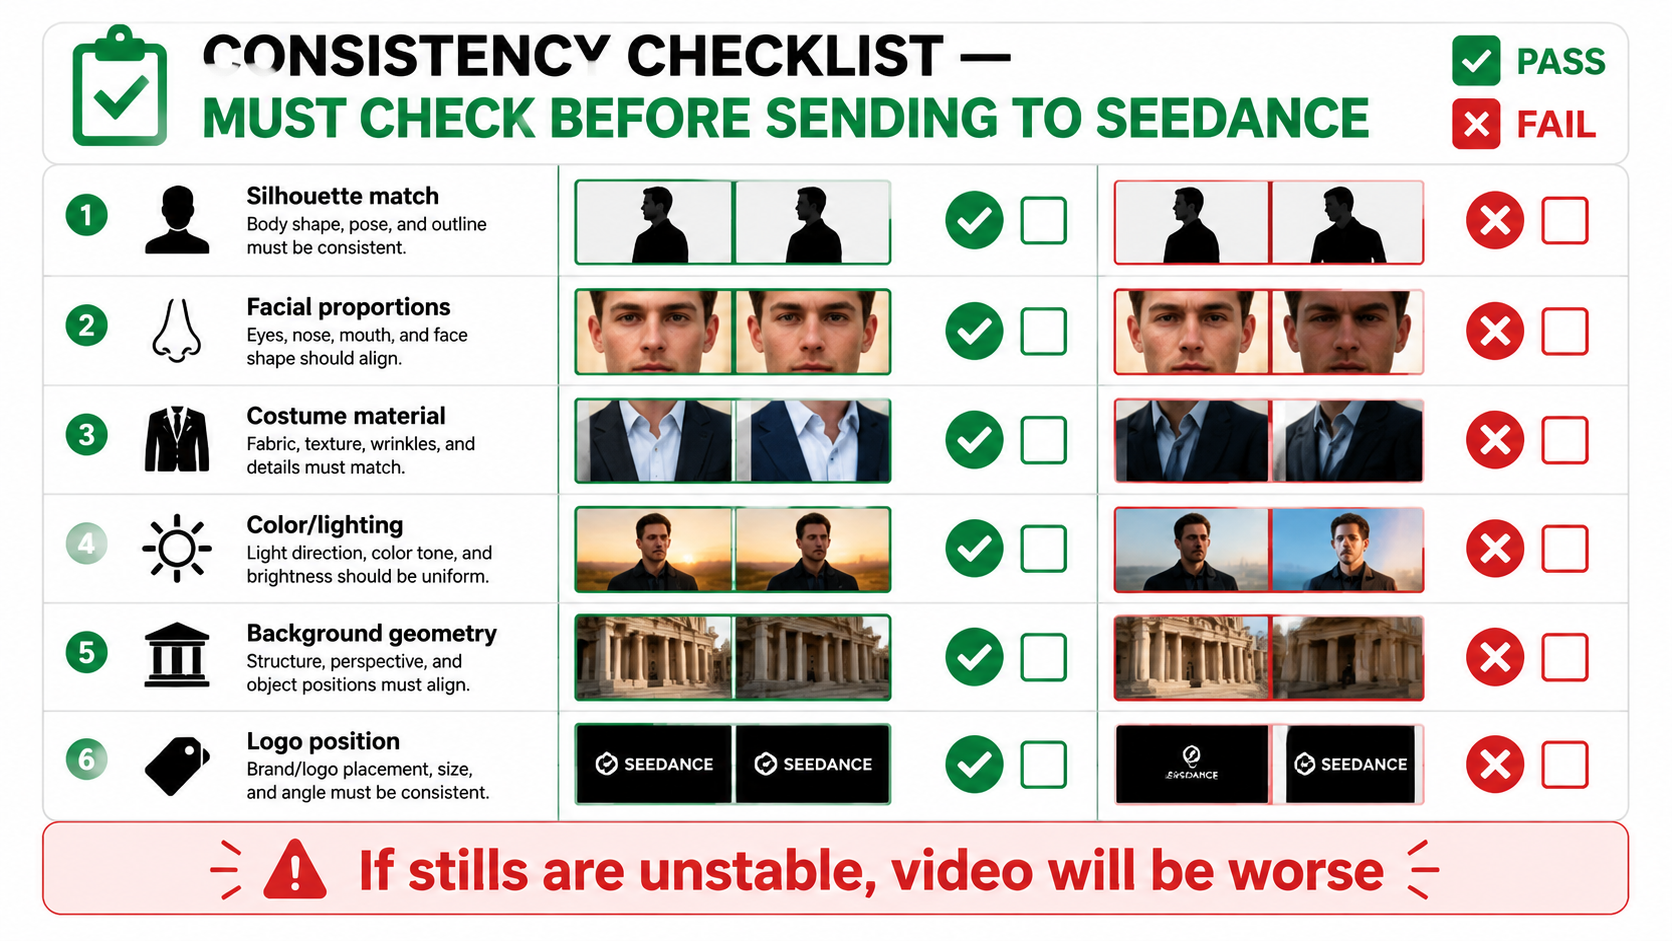
在送去 Seedance 2.0 之前,必须检查故事板的一致性。如果静态图片都不稳定,视频生成会放大漂移。
检查清单:
☐ 轮廓/剪影 — 角色体型在各帧中是否一致?
☐ 面部/产品形状 — 五官比例、产品外形是否稳定?
☐ 服装/材质 — 衣服款式、面料质感是否统一?
☐ 色调/光线 — 色温和光源方向是否一致?
☐ 背景几何 — 建筑、场景元素是否连贯?
☐ 文字/Logo — 品牌标识位置和样式是否正确?
⚠️ 如果静态都不稳定,不要送去生成视频。先修 GPT Image 2 的 prompt,重新生成故事板。
第 4 步:用 Seedance 2.0 生成视频
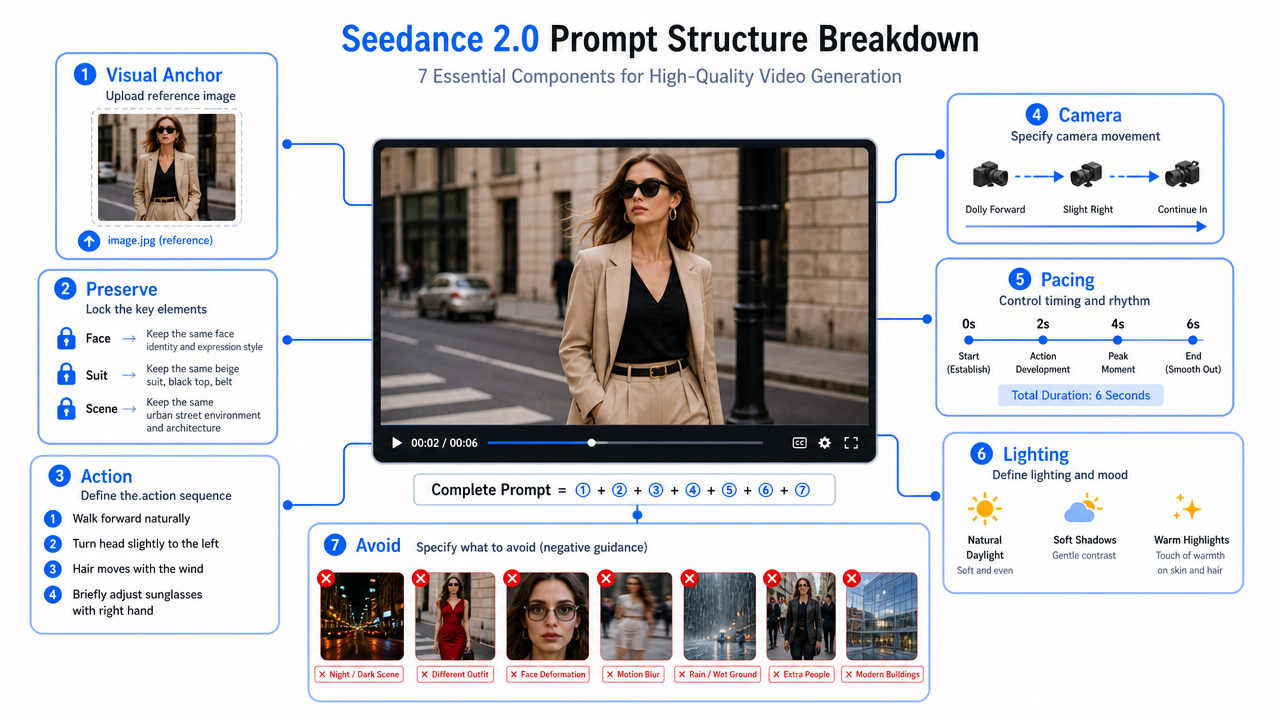
故事板锁定后,上传到 Seedance 2.0,写一个只关注运动的 prompt。
- 核心原则:
- 不要重复描述视觉细节 — 故事板已经包含了
- 只描述变化 — 镜头怎么动、角色做什么、节奏多快
- 明确"保留什么" — 告诉模型哪些元素不能变
Prompt 结构模板
使用上传的图片作为视觉锚点。
保留:[角色身份、产品形状、服装、Logo 位置、光线方向]
动作:[画面中什么在变化]
镜头:[慢推 / 环绕 / 平移 / 手持 / 固定三脚架]
节奏:[安静奢华 / 快速剪辑预告片 / 创作者广告风格]
光线变化:[高光扫过 / 柔光 flare / 黄昏色温偏移]
结尾:[主体应该停在哪里]
避免:新物体出现、身份漂移、产品细节模糊、突兀动作
实际示例
使用上传的故事板作为视觉参考。
按照故事板的镜头顺序,从左到右、从上到下依次执行。
保留:角色面部特征、黑色西装、伦敦街头场景、黄昏光线
动作:模特从远景走来 → 停下整理袖口 → 转身展示背面 → 回眸微笑 → 走入夕阳
镜头:缓慢推轨,从远景逐渐推至中景,最后拉远
节奏:优雅从容,每个镜头 2 秒,总计 15 秒
光线:金色黄昏光线,柔和的镜头 flare
避免:面部变形、服装变化、背景元素消失
第 5 步:迭代运动,而非构图
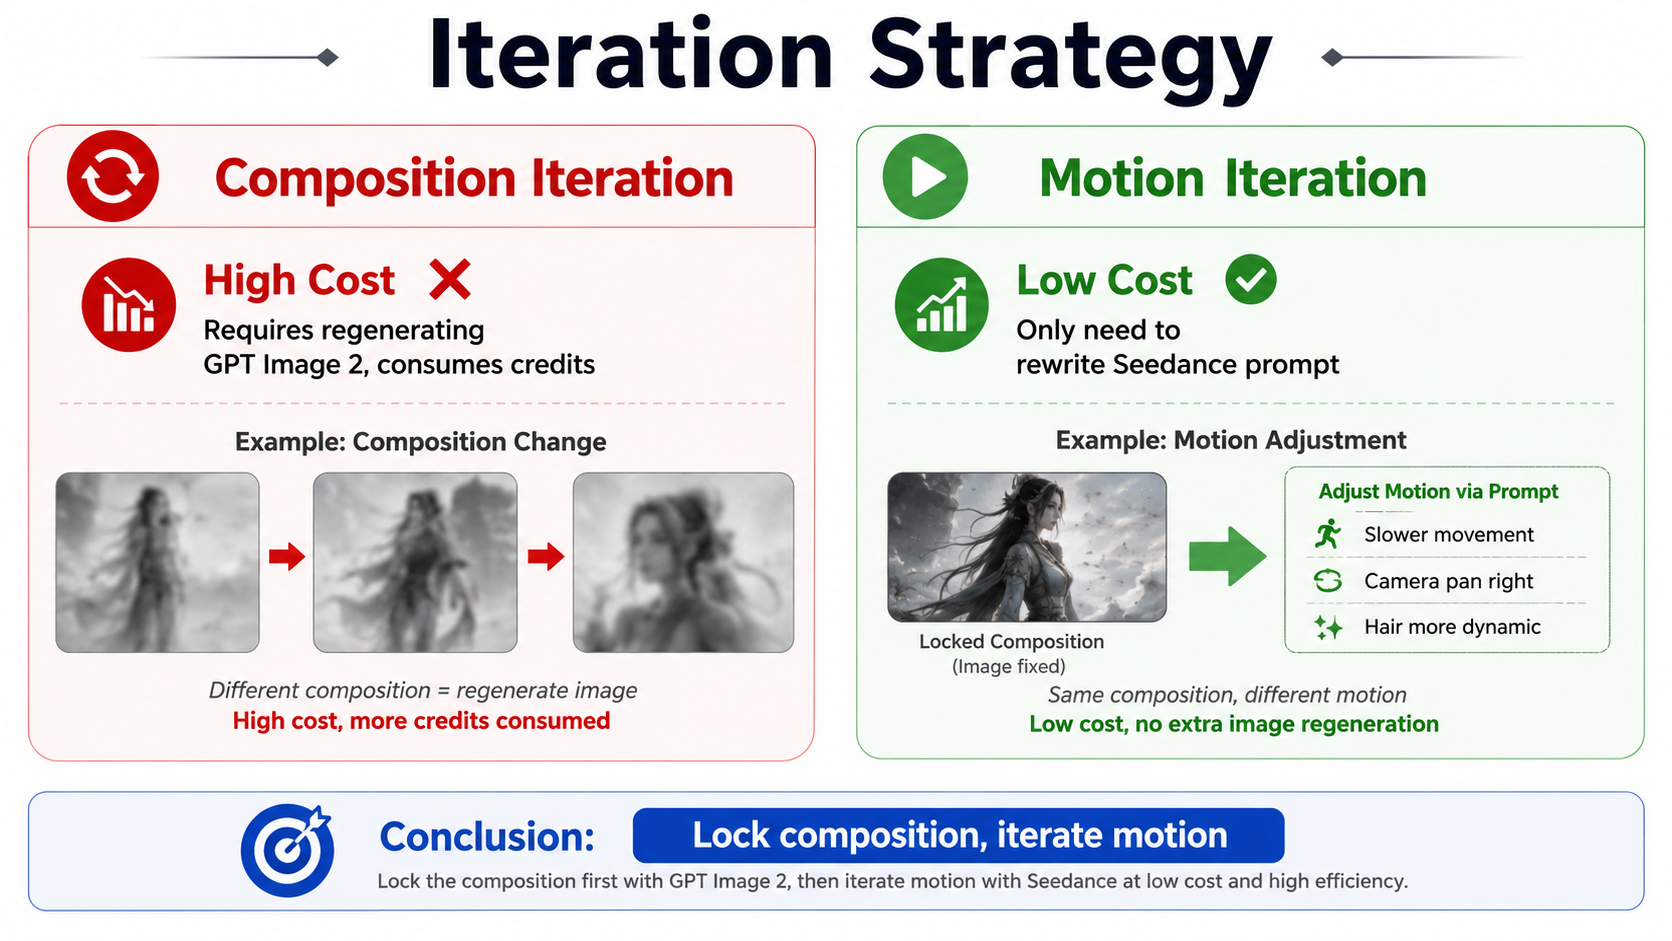
如果视频效果不理想,失败几乎总是运动相关——角色动错了、镜头漂移了、过渡不自然。
不要回去重新生成故事板。 故事板是对的。重写运动 prompt,重新跑视频生成。
构图迭代成本高,运动迭代成本低。 这个工作流之所以高效,正是因为你只需要生成一次故事板,但可以无限次调整运动。
第 6 步:剪辑成片
将 Seedance 2.0 生成的多个片段导入剪辑工具,完成:
- 片段拼接与转场
- 添加背景音乐和音效
- 添加字幕、标题、品牌 Logo
- 调色与最终输出
- 根据平台调整画幅(9:16 / 16:9 / 1:1)
6. 实战案例一:时尚穿搭扫描视频
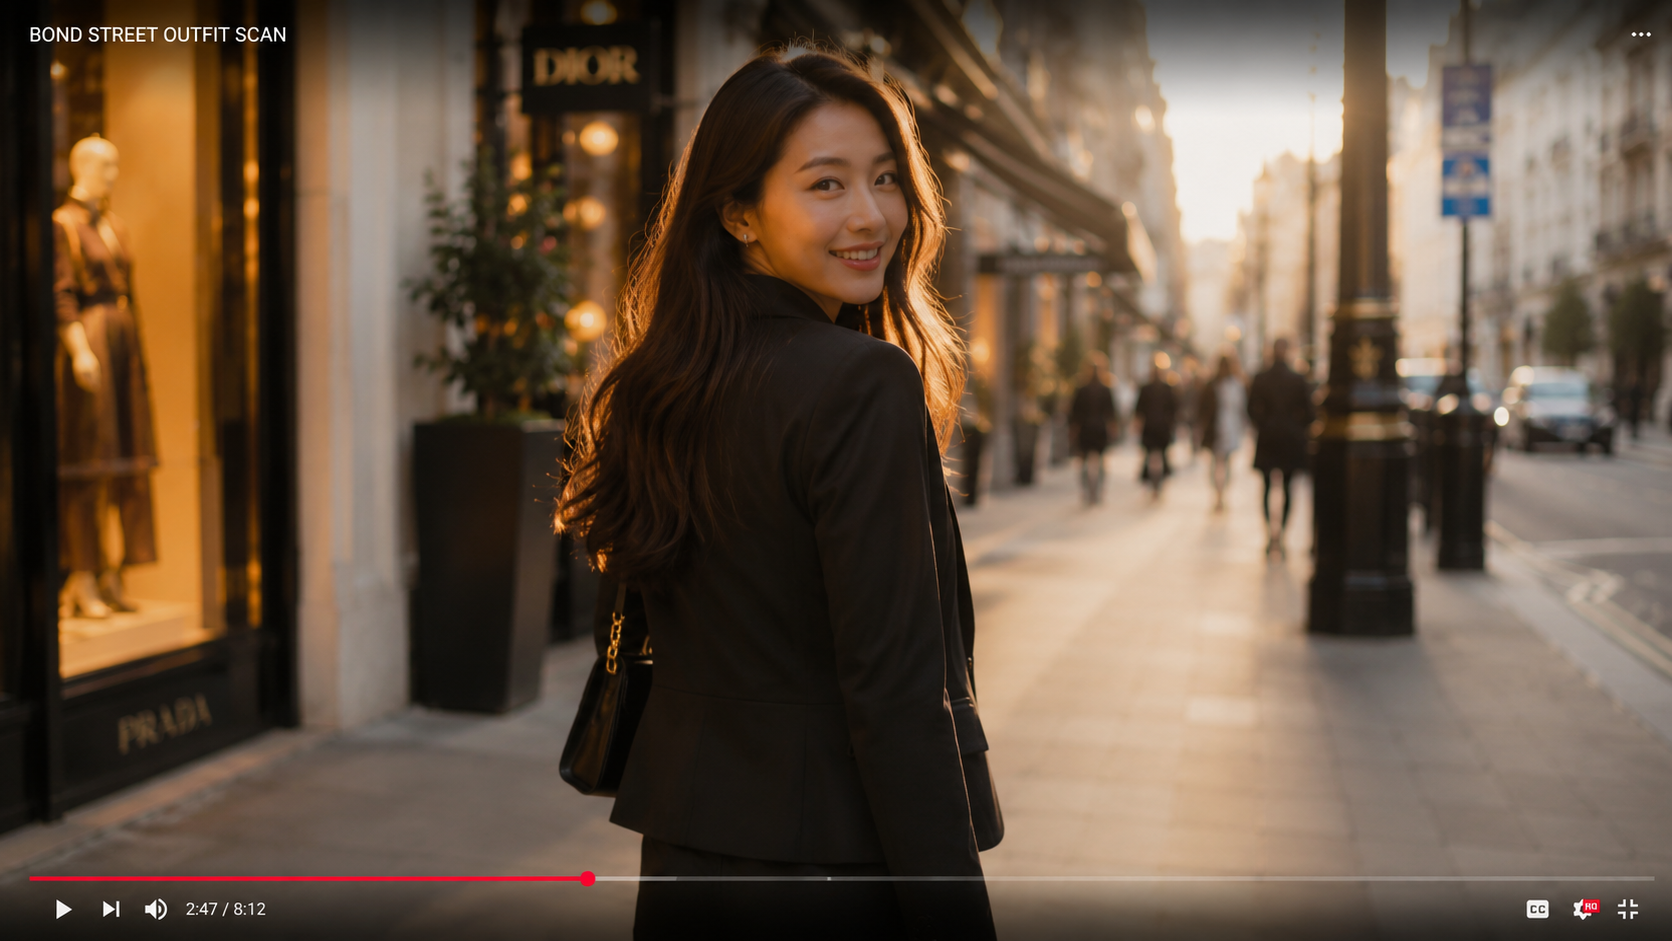
场景:伦敦购物街的奢华穿搭扫描
Step 1:用 GPT Image 2 生成时尚故事板
Prompt 描述了角色身份、服装细节、视觉风格、音频提示和 7 个镜头序列。GPT Image 2 凭借强大的 prompt 理解力,生成了一张完整的时尚故事板。
Step 2:用 Seedance 2.0 生成穿搭扫描视频
将故事板上传至 Seedance 2.0,写入运动 prompt(镜头顺序、节奏、运镜方式),直接生成了一段完整的穿搭扫描视频——这种效果通常需要造型师、模特、场地、摄影师和后期团队才能完成。
结果:从一张故事板到一段完整的时尚短视频,整个流程不到 30 分钟。
7. 实战案例二:中世纪集市电影短片
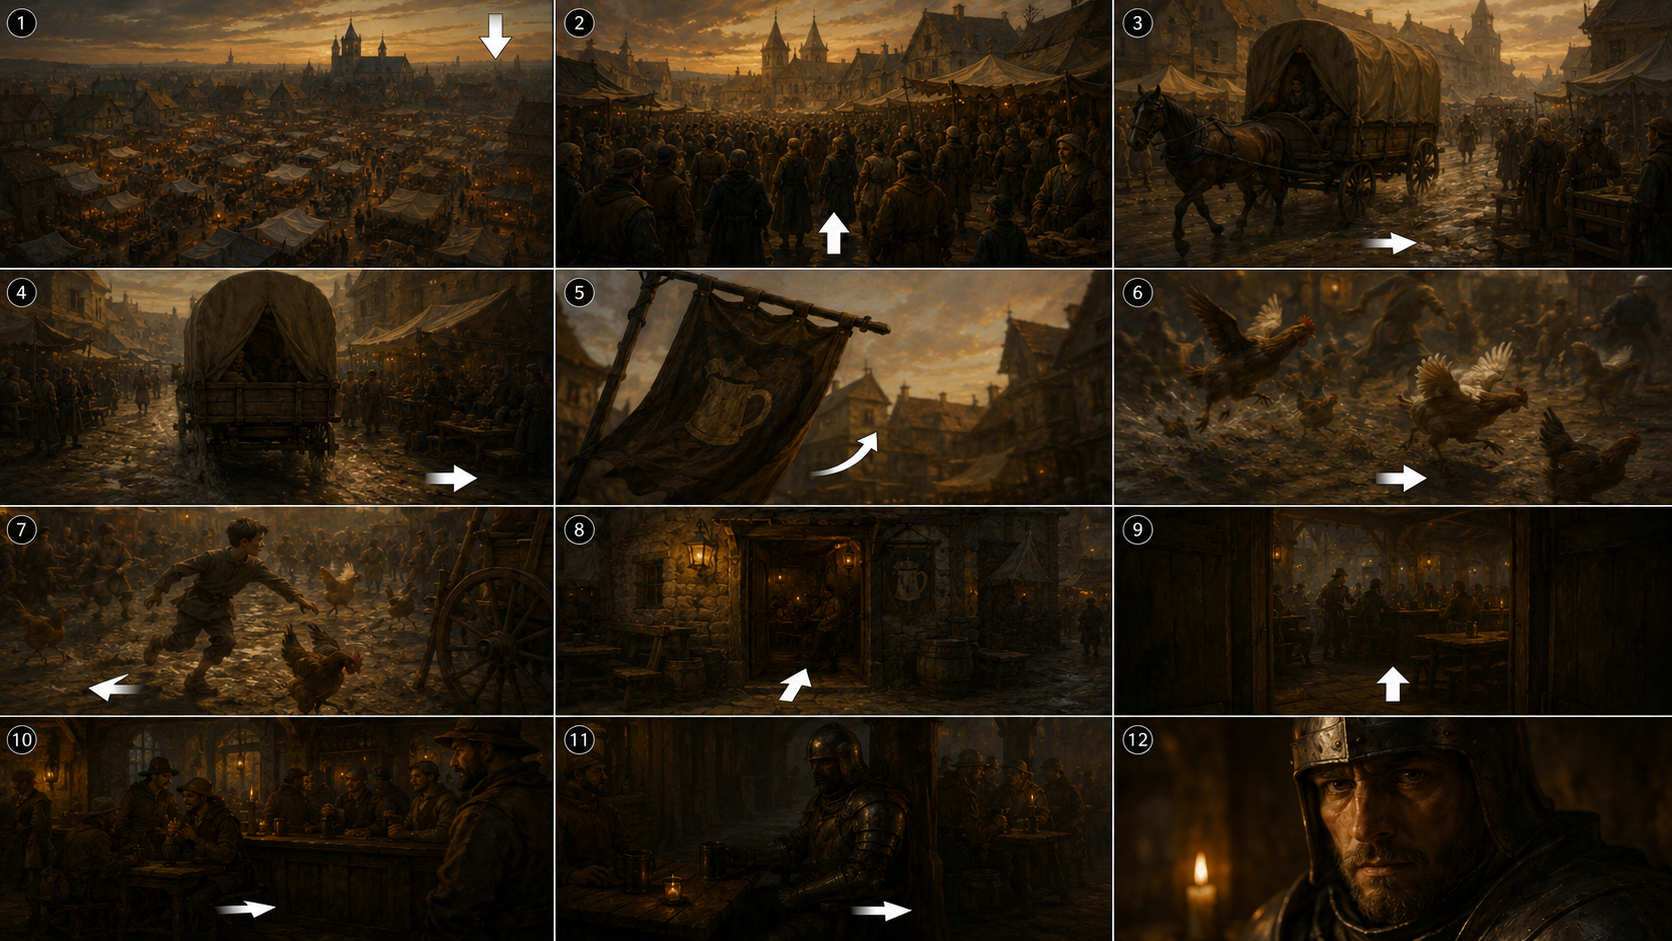
场景:黄昏的中世纪集市,镜头穿过人群,最终滑入酒馆,落在角落一位沉默的铠甲骑士身上。
对比实验
创作者 @aimikoda 做了一个对比:
|
维度 |
第一次尝试(单图直接生成) |
第二次尝试(故事板) |
|
方法 |
单张图片 + 直接 Seedance 2.0 |
GPT Image 2 生成带时间线的故事板 → Seedance 2.0 |
|
尝试次数 |
5+ 次 |
1 次成功 |
|
镜头过渡 |
随机跳切 |
每个过渡都有自然的场景驱动动机 |
|
叙事完整性 |
场景元素丢失 |
全部 12 个镜头完整还原 |
|
镜头连续性 |
镜头随机移动 |
每次运镜都有明确动机 |
核心技术:"动机驱动的连续运镜"
这个技术来自导演斯皮尔伯格的镜头哲学——每次镜头运动都必须有"动机"(Motivated Camera Move)。镜头不是随机移动的,而是自然地跟随场景动作转移注意力:
- 马车穿过画面 → 镜头跟随马车
- 旗帜摆动 → 揭示散开的鸡群
- 男孩跑过酒馆门口 → 镜头自然滑入酒馆
在故事板中标注每个镜头方向和动机,Seedance 2.0 就能精确执行你想要的镜头语言。
8. 实战案例三:3×3 故事板网格动画
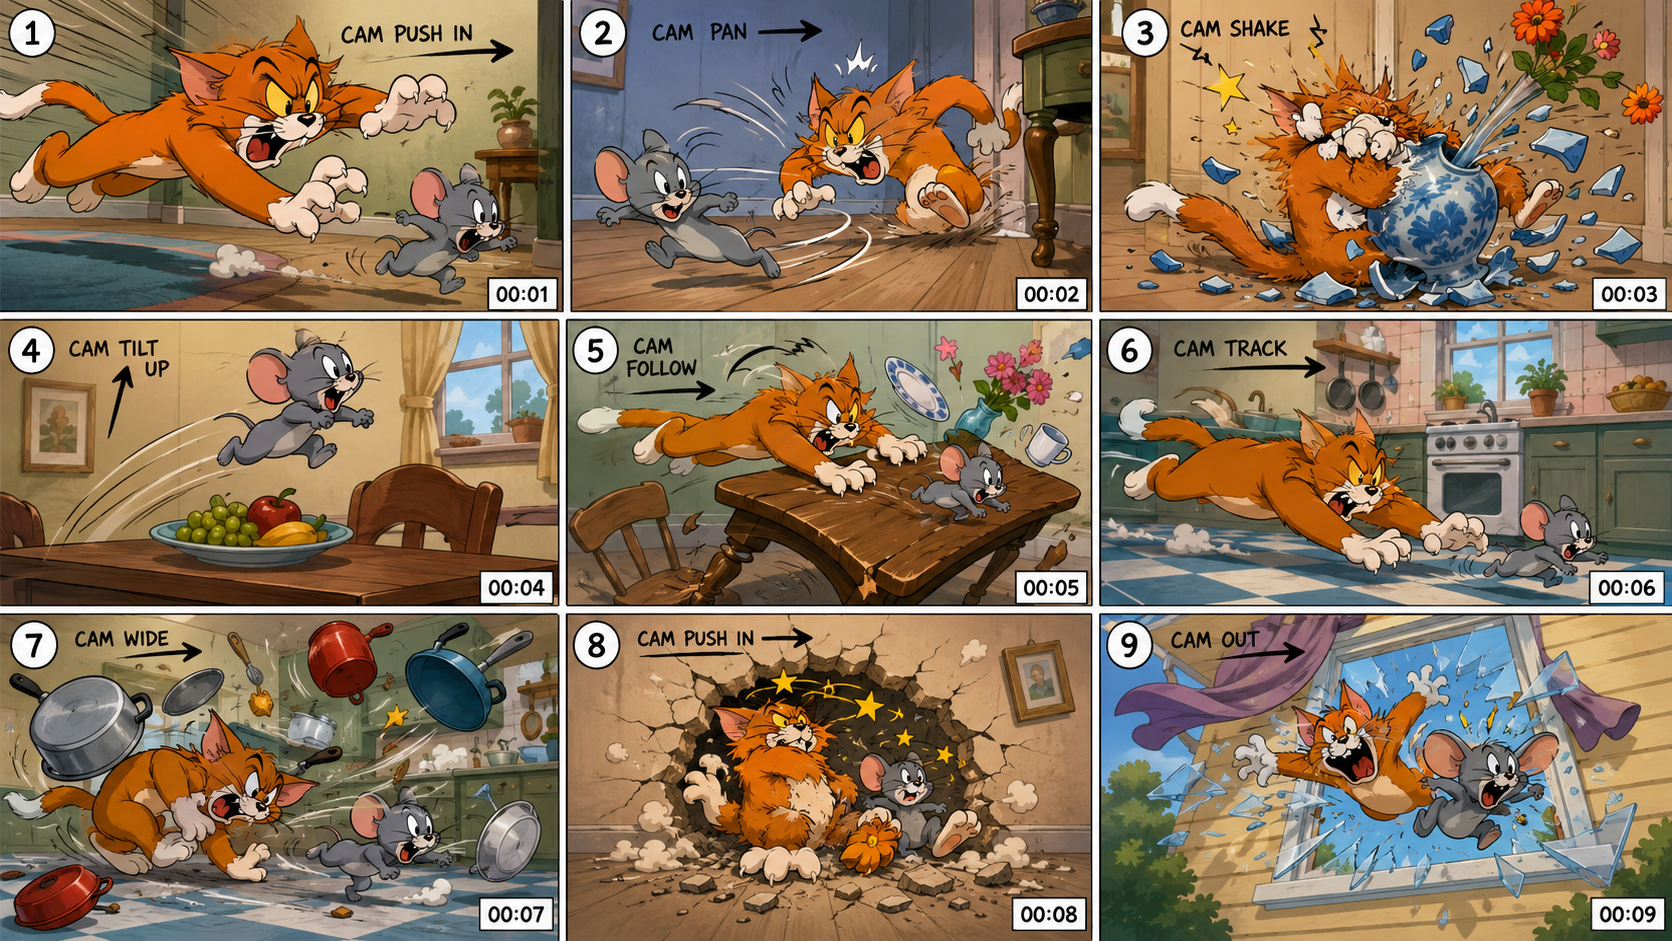
场景:一段 15 秒的卡通追逐动画(猫和老鼠风格)
工作流
1. 用 GPT Image 2 生成一张 3×3 动画故事板网格,包含 9 个画格,每格标注:
- 镜头方向(远景/特写/俯拍)
- 运动提示(猫扑向花瓶、老鼠急转弯)
- 时间标注(0-2s / 2-5s / 5-8s ...)
- 破坏升级线索(花瓶碎 → 桌子翻 → 墙壁裂)
2. 将整张网格上传至 Seedance 2.0
3. Seedance 2.0 读取画格顺序、镜头标注和运动提示,生成一段连续流畅的 15 秒追逐动画
结果:一张图锁定了角色、场景和叙事结构,视频生成只负责"让它动起来"。
9. 可复制的 Prompt 模板
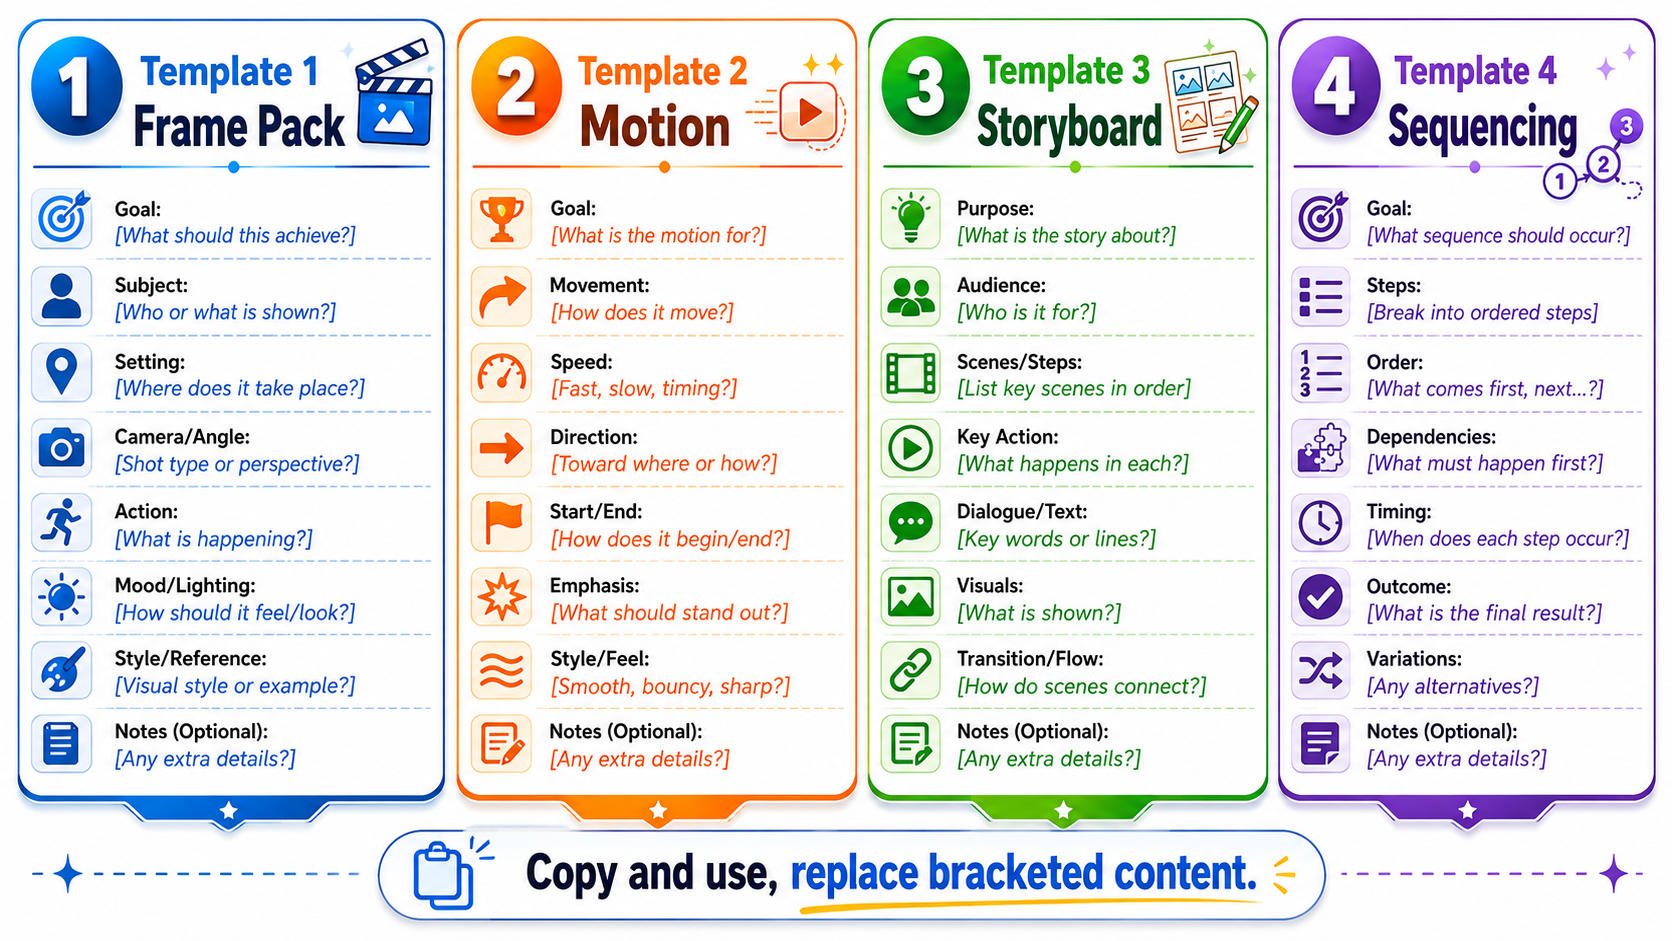
以下模板可直接复制使用,将方括号 [ ] 中的内容替换为你的具体信息即可。
模板 1:GPT Image 2 帧包(Frame Pack)Prompt
为一个 [资产类型] 创建 [格式] 帧包。
目标:这将成为 Seedance 2 图生视频的参考。
主体:[产品 / 角色 / 场景]
受众:[买家 / 观众 / 平台]
视觉方向:[风格、色调、材质、光线]
需要的帧:
1. 主角首帧(Hero First Frame)
2. 细节特写
3. 环境/场景帧
4. 最终落点帧
一致性规则:保持 [Logo / 面部 / 服装 / 剪影 / 道具] 一致。
输出:干净的画面,无意外文字,无多余物体。
模板 2:Seedance 2.0 运动 Prompt
使用上传的图片作为视觉锚点。
保留:[主体身份、产品形状、服装、Logo 位置、光线方向]
动作:[画面中什么在变化]
镜头:[慢推 / 环绕 / 平移 / 手持 / 固定]
节奏:[安静奢华 / 快速剪辑 / 创作者广告能量]
光线变化:[高光扫过 / 柔光 flare / 黄昏色温偏移]
结尾:[主体应该停在哪里]
避免:新物体出现、身份漂移、产品细节模糊、突兀动作
模板 3:故事板网格 Prompt
为一段 [N] 秒的 [类型] 视频创建 12 格故事板网格。
布局:4 列 × 3 行,从左到右、从上到下阅读。
每格:一个清晰镜头,一个动作,主体身份一致。
风格:[电影 / 产品广告 / 动画 / UI 演示]
图片内无文字标签(除非标签是 UI 的一部分)。
保持一致的光线、色调、服装和场景几何。
输出为单张图片,用于图生视频参考。
模板 4:通用故事板排序 Prompt(直接用于 Seedance 2.0)
使用此故事板生成视频。
按照场景顺序执行,保持过渡平滑,
保留电影级光线和节奏。
[添加任何额外的视觉细节]
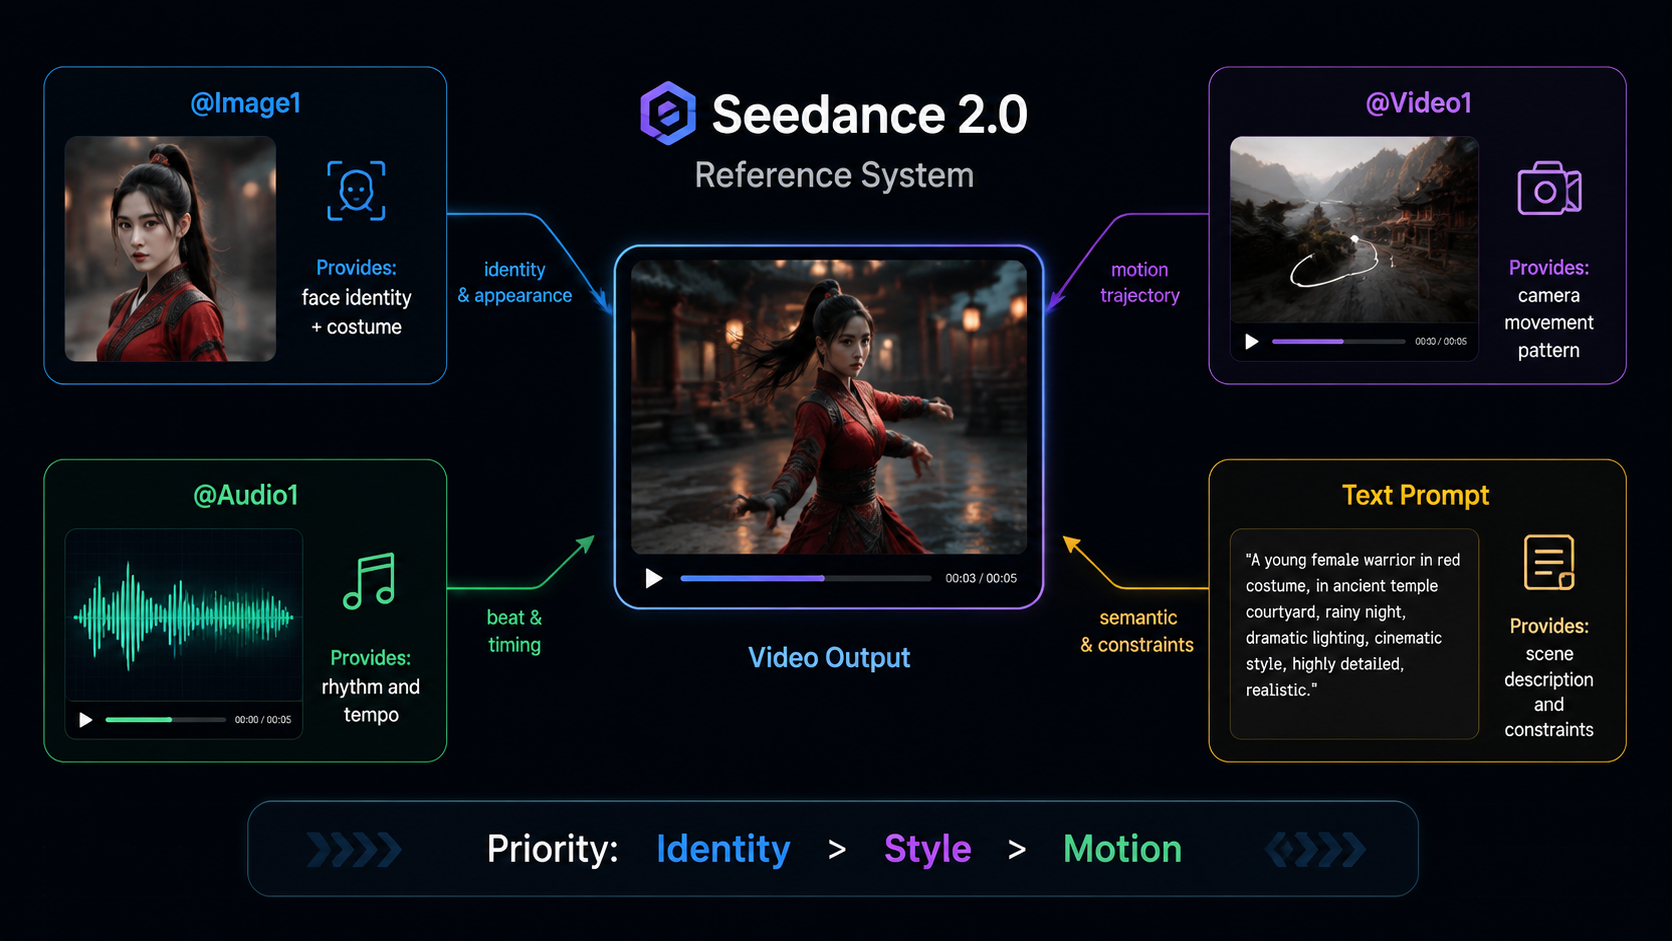
10. Seedance 2.0 @ 引用系统详解
Seedance 2.0 不是简单的"上传图片生成视频"工具。它是一个结构化多模态系统,支持通过 @ 语法显式绑定参考素材的属性。
基本用法
@Image1 作为首帧
@Video1 参考镜头运动
@Audio1 参考背景音乐节奏
11. 进阶技巧
1. 故事板 > 单帧关键帧
案例二证明,带有时间线和镜头动机的故事板远比单张关键帧有效。至少创建 3 格故事板,更好的是 9 格或 12 格。
2. 指定"动机"而非"动作"
❌ 不要说:"平移镜头" ✅ 要说:"马车穿过画面,镜头跟随马车" 场景驱动的镜头运动看起来远比随机运动自然。
3. 先静态后运动
把故事板做到完美,再加动画。视觉质量决定了视频质量的上限。
4. 多次迭代
AI 的优势是快速迭代。不要期望第一次就完美——生成、检查、修改 prompt、再生成。
5. 短片优先
不要一上来就生成 20 秒的序列。先从 3-5 秒的短片开始测试,验证角色稳定性、光线保留、运动准确性,再扩展到完整场景。
6. 运动简报先于一切
在写任何 prompt 之前,先把运动简报写清楚。这能防止 GPT Image 2 去解决运动问题,也能防止 Seedance 2.0 重新发明设计。
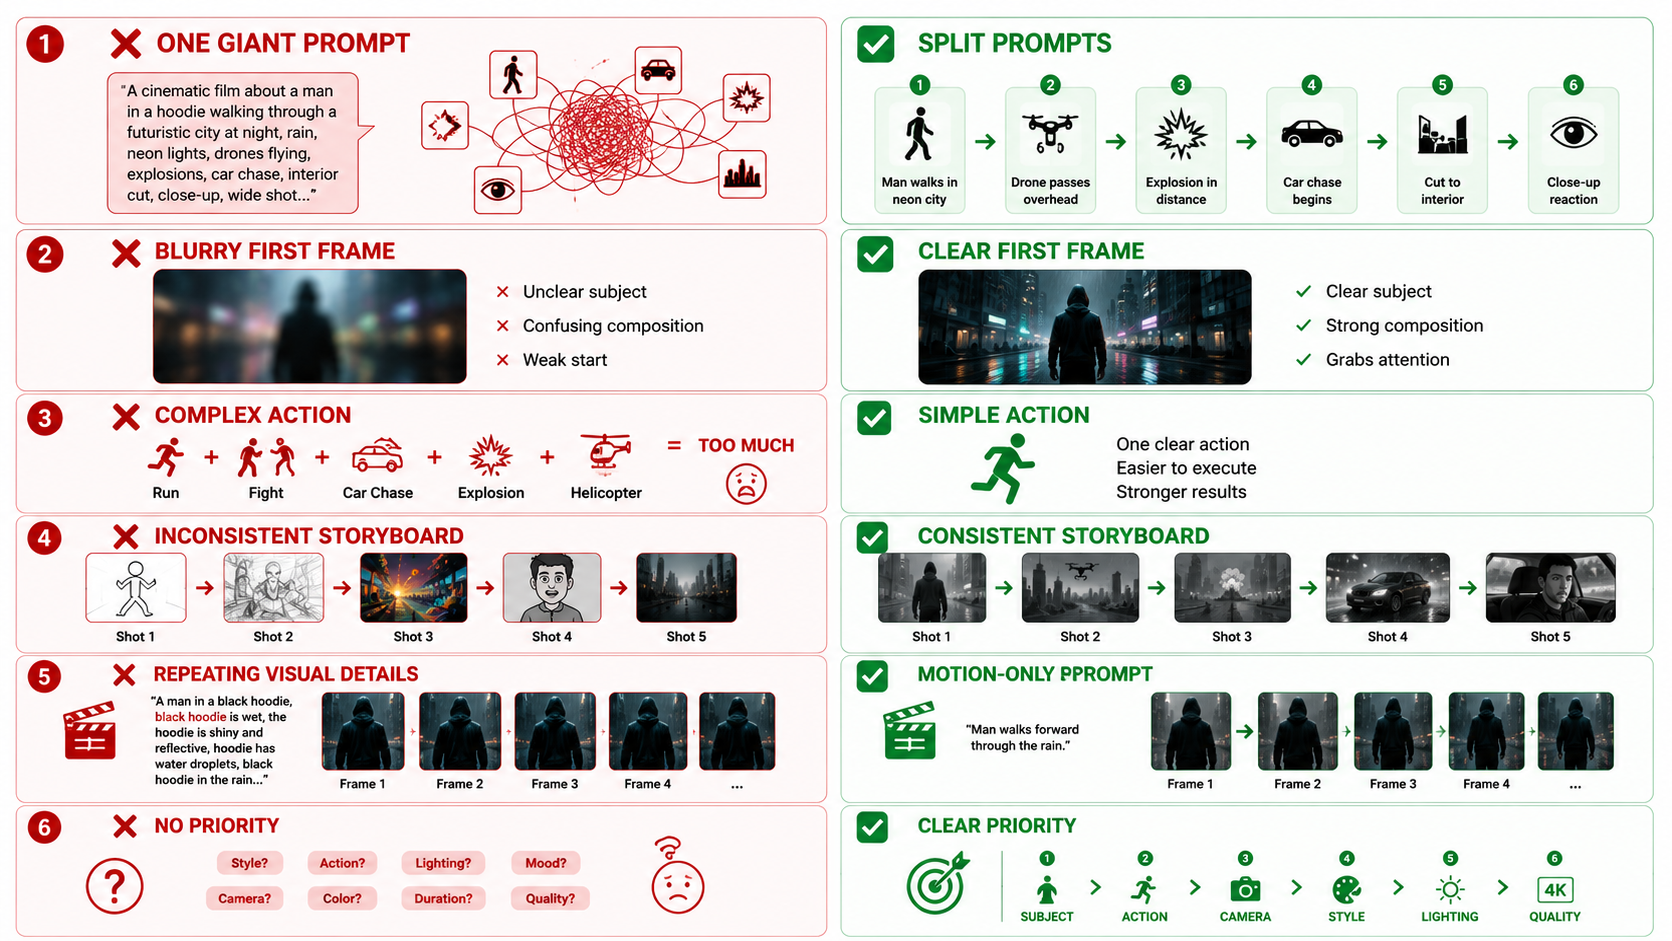
12. 常见错误与避坑指南
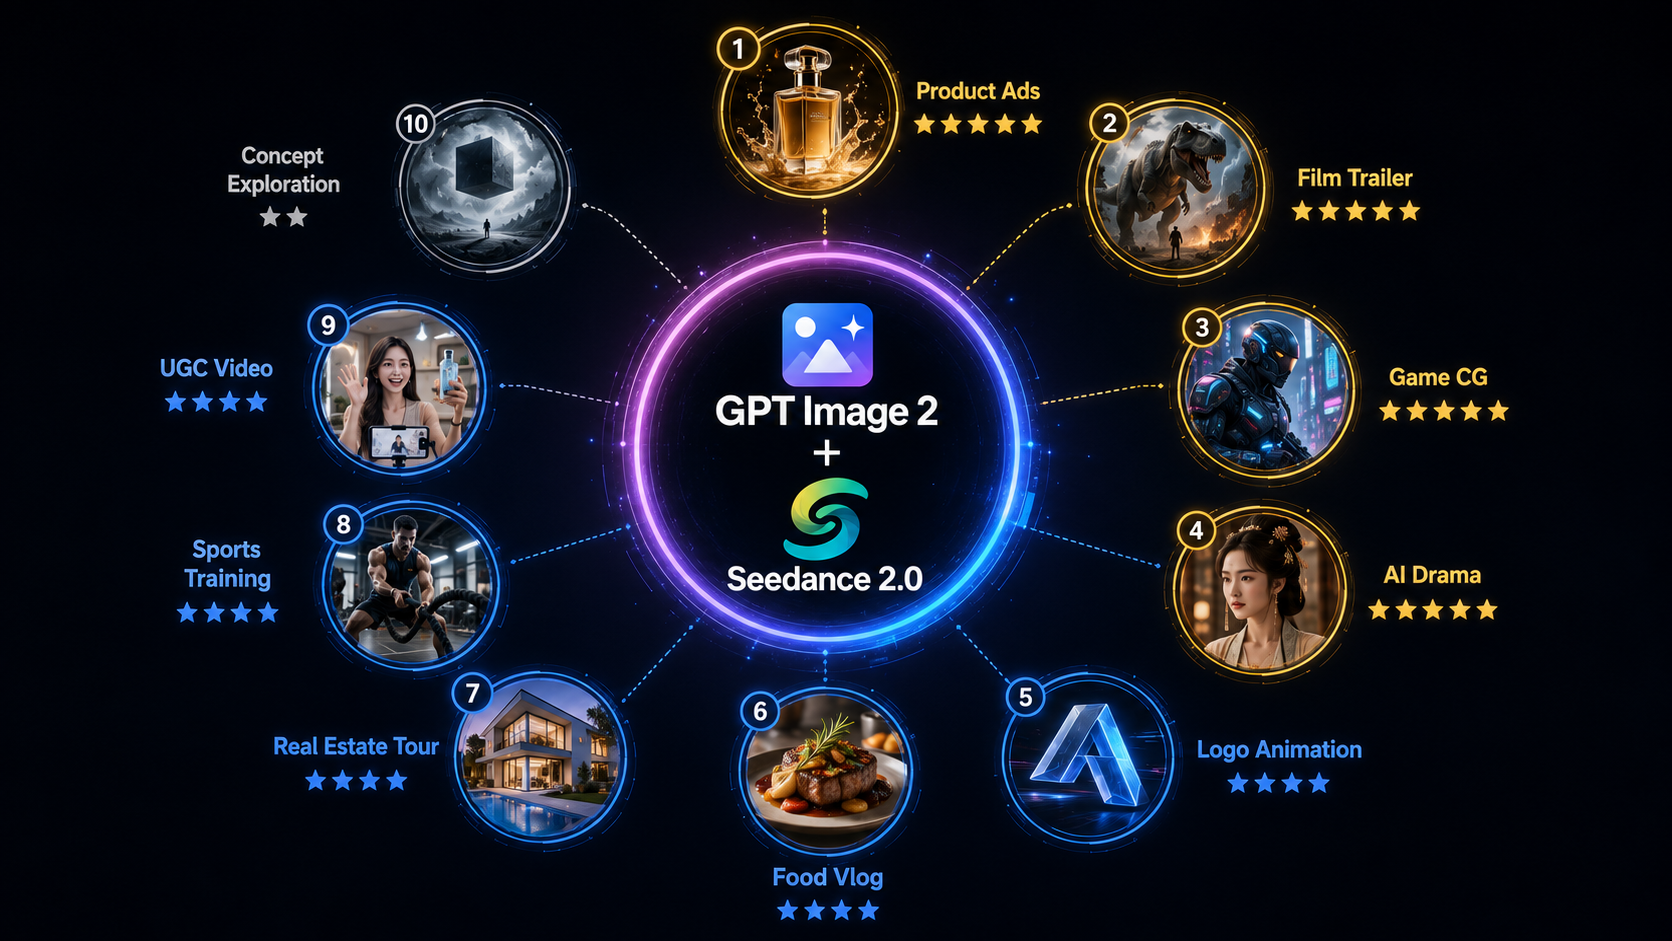
13. 适用场景一览
14. FAQ 常见问题
Q:GPT Image 2 + Seedance 2.0 工作流是什么?
A:一种两阶段图生视频流水线:先用 GPT Image 2 创建受控的英雄帧、故事板网格、产品场景或角色设定表,再将这些静态图上传至 Seedance 2.0,只写运动、镜头、节奏和连续性相关的 prompt。当身份、产品细节、品牌风格或镜头顺序需要在动画中保留时,这比纯文生视频更强。
Q:应该从单张图开始还是从故事板网格开始?
A:单张图适合简单的产品展示、肖像运动、镜头推近。故事板网格适合需要镜头顺序、叙事推进、动作编排或快速剪辑的场景。
Q:Seedance 2.0 的 prompt 应该包含什么?
A:动作、镜头运动、时长/节奏、光线行为、风格、保留规则。不要浪费 prompt 重复描述上传图片中已有的视觉细节。
Q:如何减少图生视频中的视觉漂移?
A:改善源帧质量、简化运动、保持背景干净、明确指定哪些元素不能变。只在真正需要序列时才使用故事板面板。
Q:这个工作流适合产品广告吗?
A:非常适合。产品广告是最典型的用例之一,因为已审核的产品照片可以在 Seedance 2.0 加运动之前锚定形状、材质、Logo 位置和颜色。
Q:可以用于角色动画吗?
A:可以,但建议从温和的动作开始。角色设定表、姿势网格和简单镜头运动通常比激进动作更能保持身份一致性。
Q:GPT Image 2 和 DALL-E 3 有什么区别?
A:GPT Image 2 是 OpenAI 于 2026 年 4 月发布的最新图像模型,取代了 DALL-E 3(2026 年 5 月 12 日下线)。主要提升包括:99%+ 文字渲染准确率、Thinking Mode(联网验证)、2K 分辨率、更强的 prompt 理解力和多语言支持。
Q:Seedance 2.0 和 Kling 3.0、Veo 3 相比如何?
A:vs Kling 3.0:Kling 首次尝试的电影感输出通常更平滑,但 Seedance 在多场景身份锚定上更强,适合系列化内容。vs Veo 3 / Sora:这些模型侧重电影写实和叙事规模,Seedance 侧重模块化组合控制。vs Runway:Runway 在后期编辑和场景操控上更强,Seedance 在前期多模态调节上更强。
总结
GPT Image 2 + Seedance 2.0 故事板工作流的核心逻辑非常简单:
1. 先想清楚 — 写运动简报,明确拍什么、怎么动
2. 先画清楚 — 用 GPT Image 2 把故事板做到完美
3. 再动起来 — 用 Seedance 2.0 只处理运动
4. 快速迭代 — 构图只做一次,运动可以反复调
这不是"哪个模型更强"的问题,而是如何让每个模型做它最擅长的事。当你把视觉设计和运动执行分开,AI 视频的稳定性和可控性会产生质的飞跃。
这正是 AI 创作的真正价值:不是帮你更快地产出内容,而是帮你在投入大量时间和预算之前,探索更多创意可能性。
更多推荐
 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)