
【项目】【文件检索小工具】【内容查询word ppt wps文件】基于 Python + PyQt6 + Elasticsearch + Redis + Docker 开发的桌面端文件全文检索小工具。
·
【项目地址】【求star】
whyokok/tool https://github.com/whyokok/tool喜欢的可以点下star,谢谢你!!!
喜欢的可以点下star,谢谢你!!!
喜欢的可以点下star,谢谢你!!!
【项目效果】
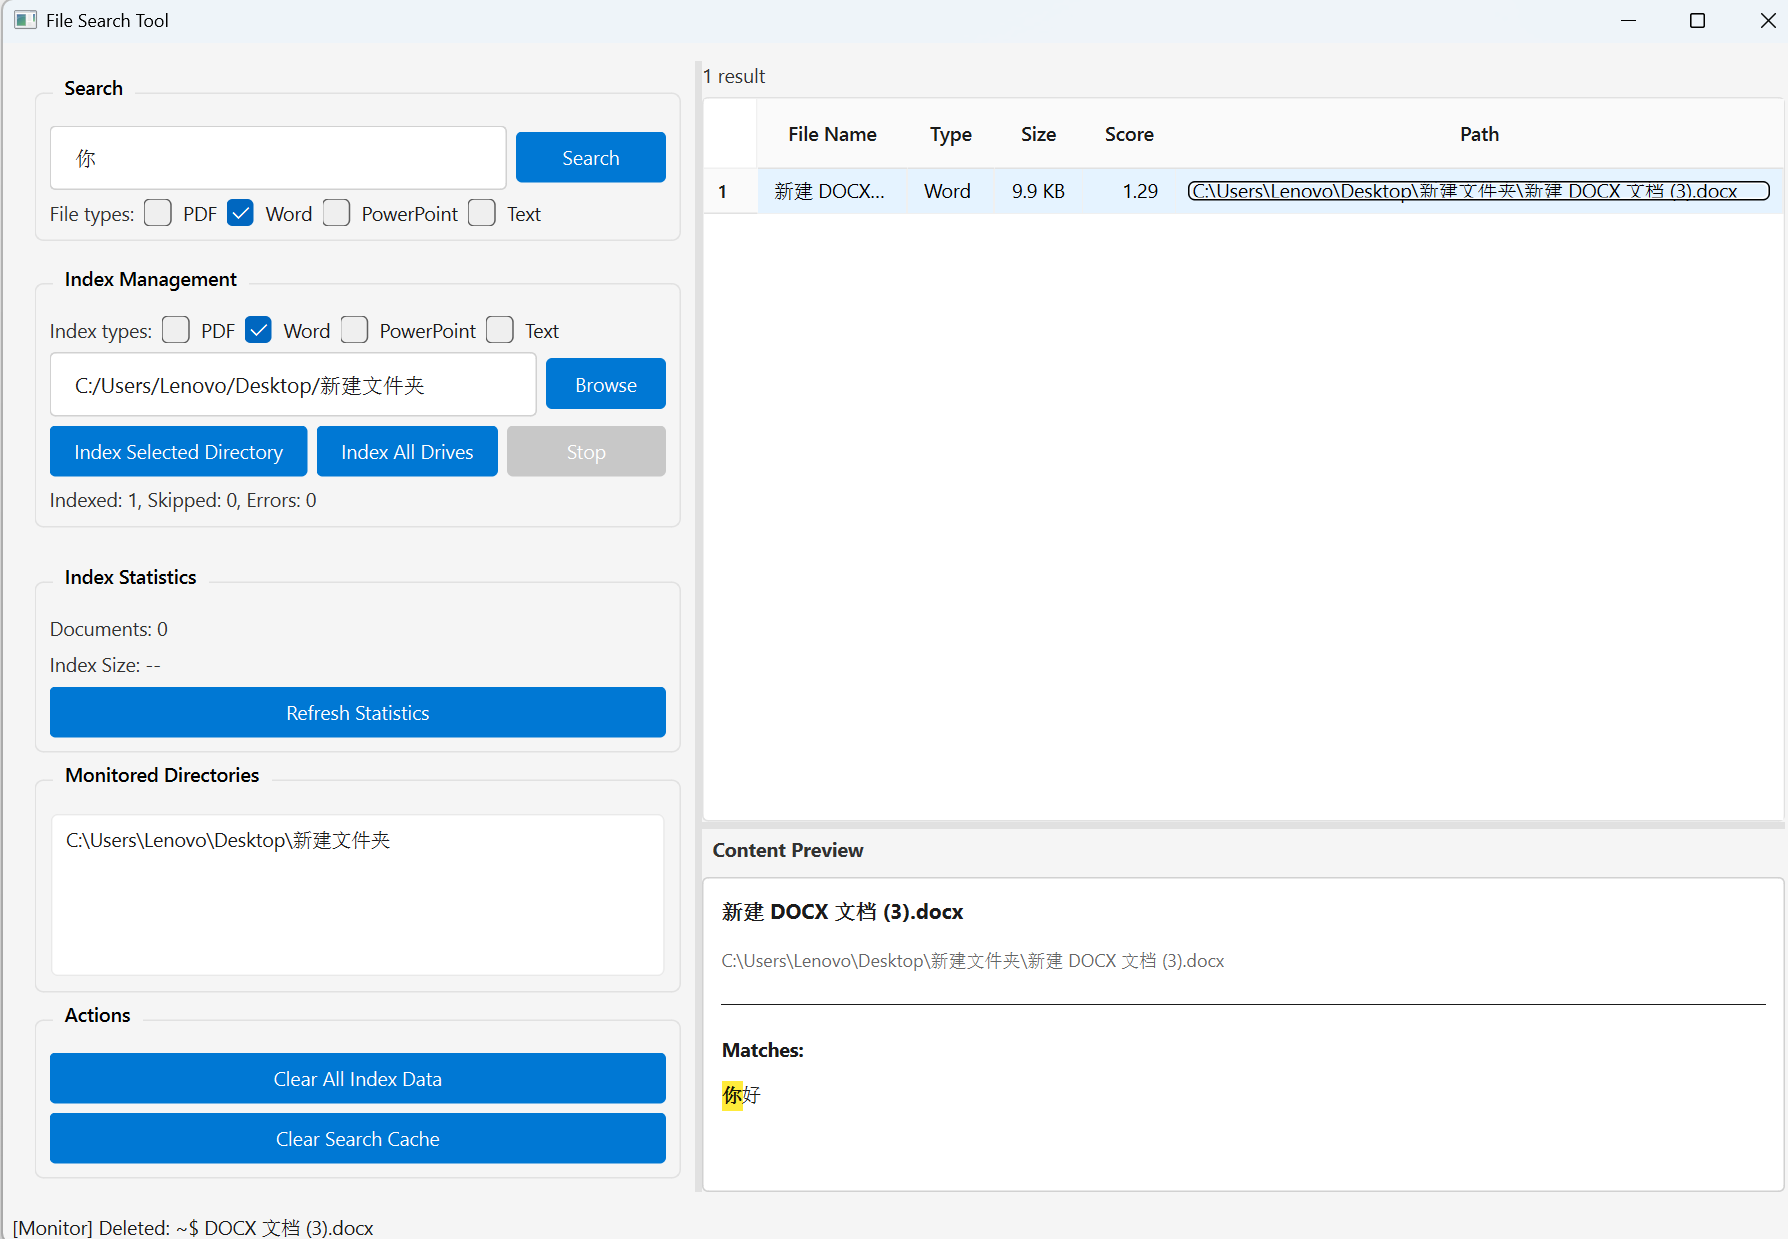
【项目启动】
在启动项目前,请确保你的电脑已安装以下软件:
-
Python 3.9 及以上版本
-
Docker(含 Docker Compose)
-
Git(用于克隆项目)
//克隆
git clone https://github.com/你的用户名/tool.git cd tool
//中间件docker
docker-compose up -d//依赖
pip install -r requirements.txt//界面运行
python main.py【项目结构】
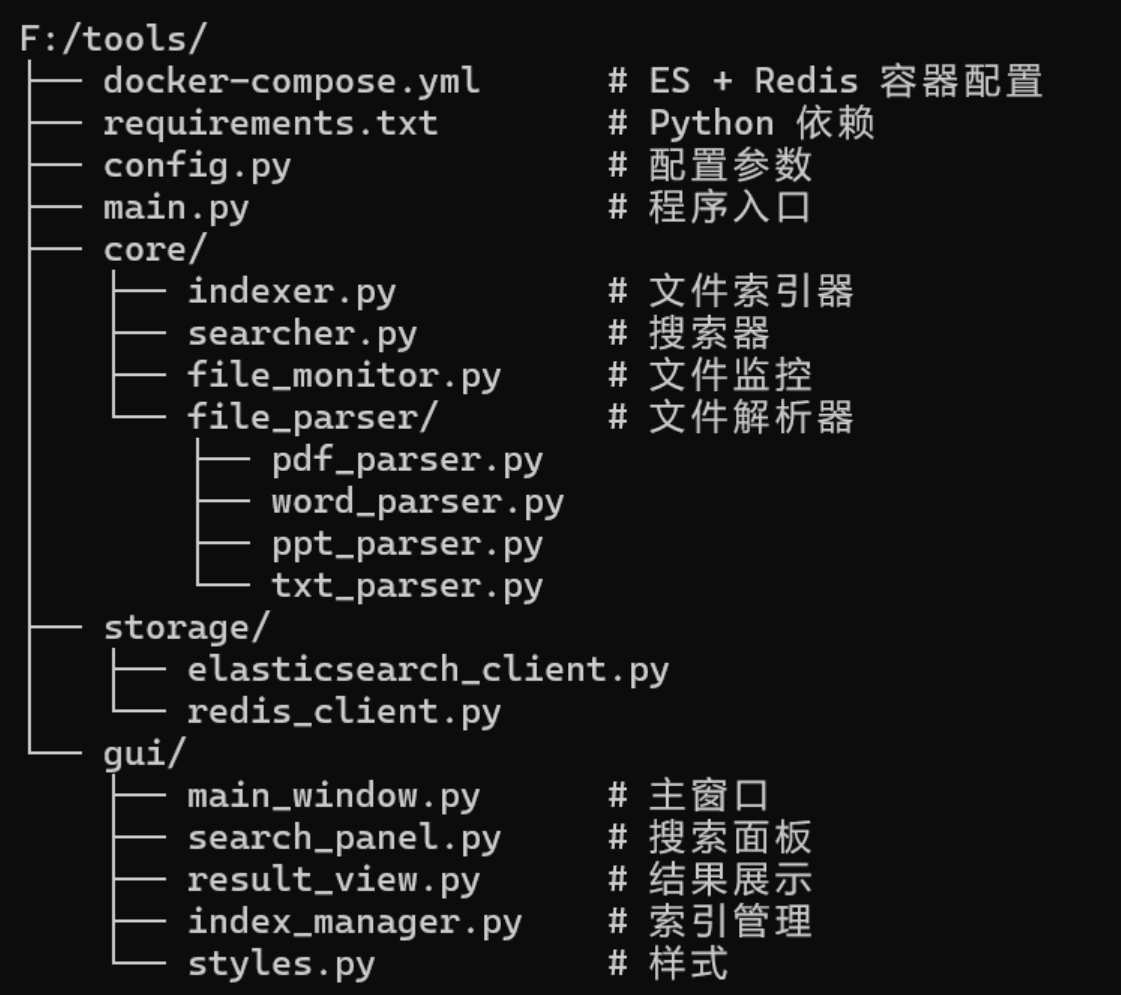
【docker容器】
//启动命令
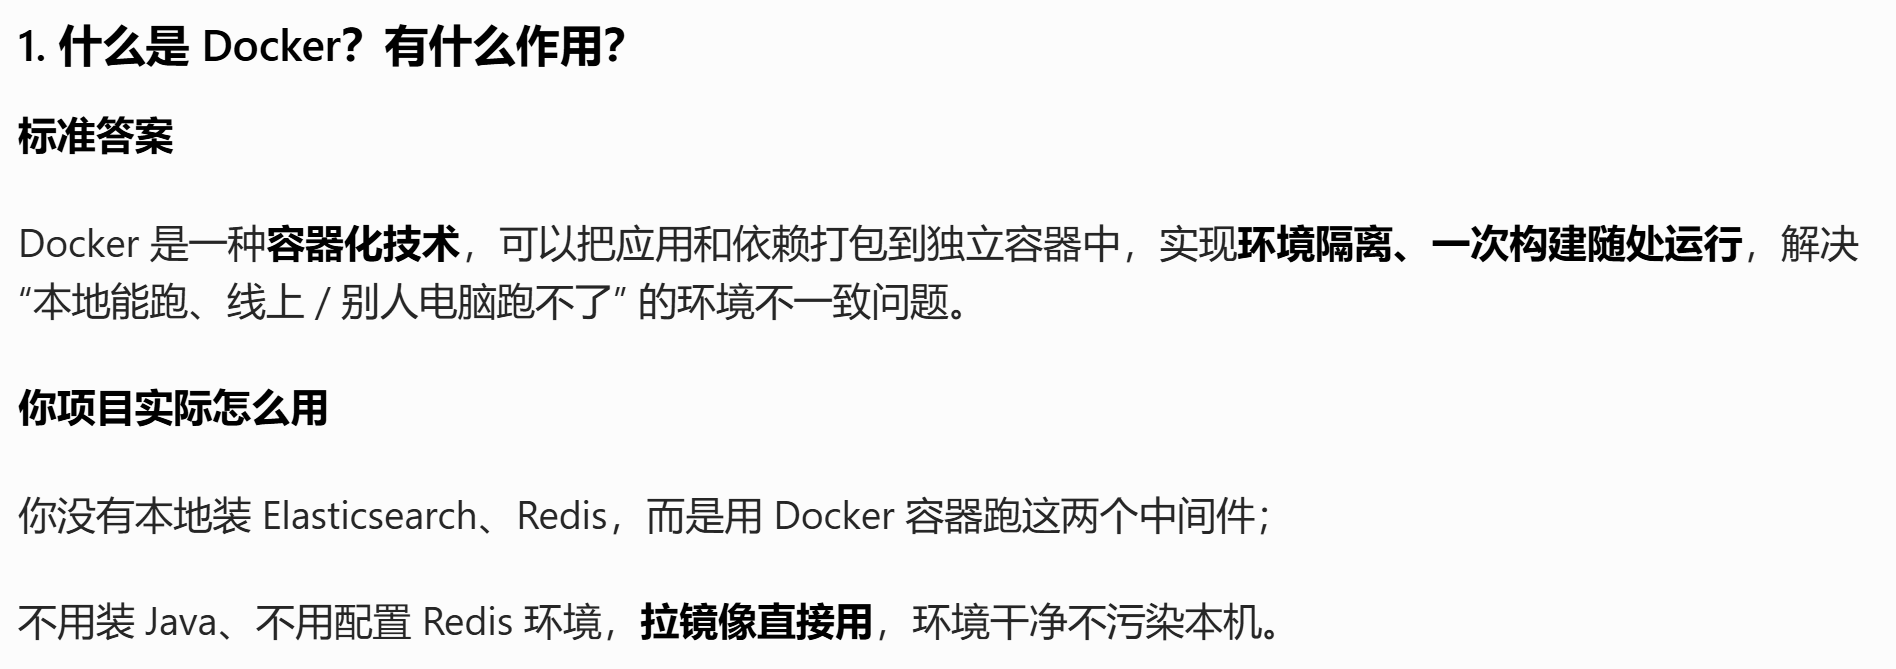
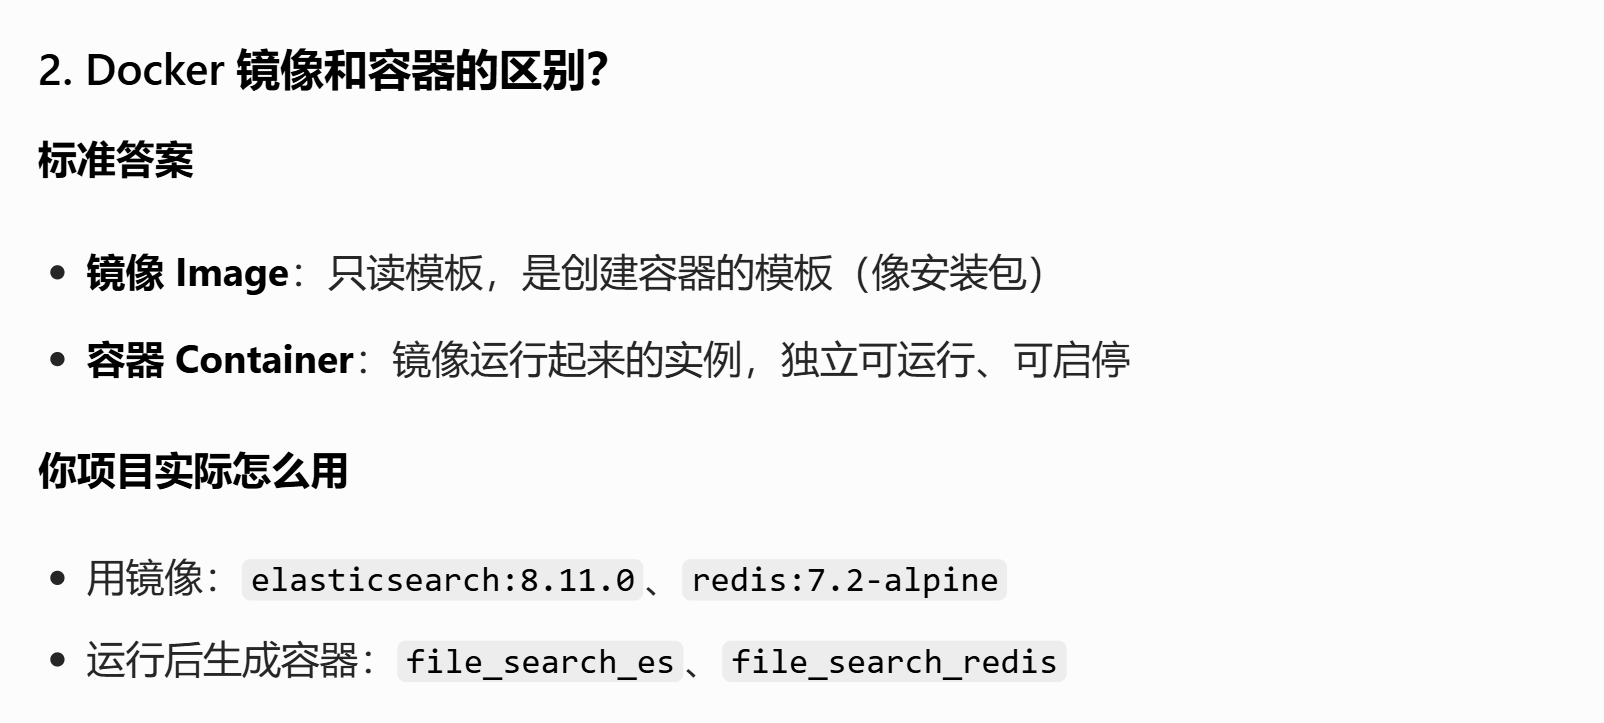
docker-compose up -d
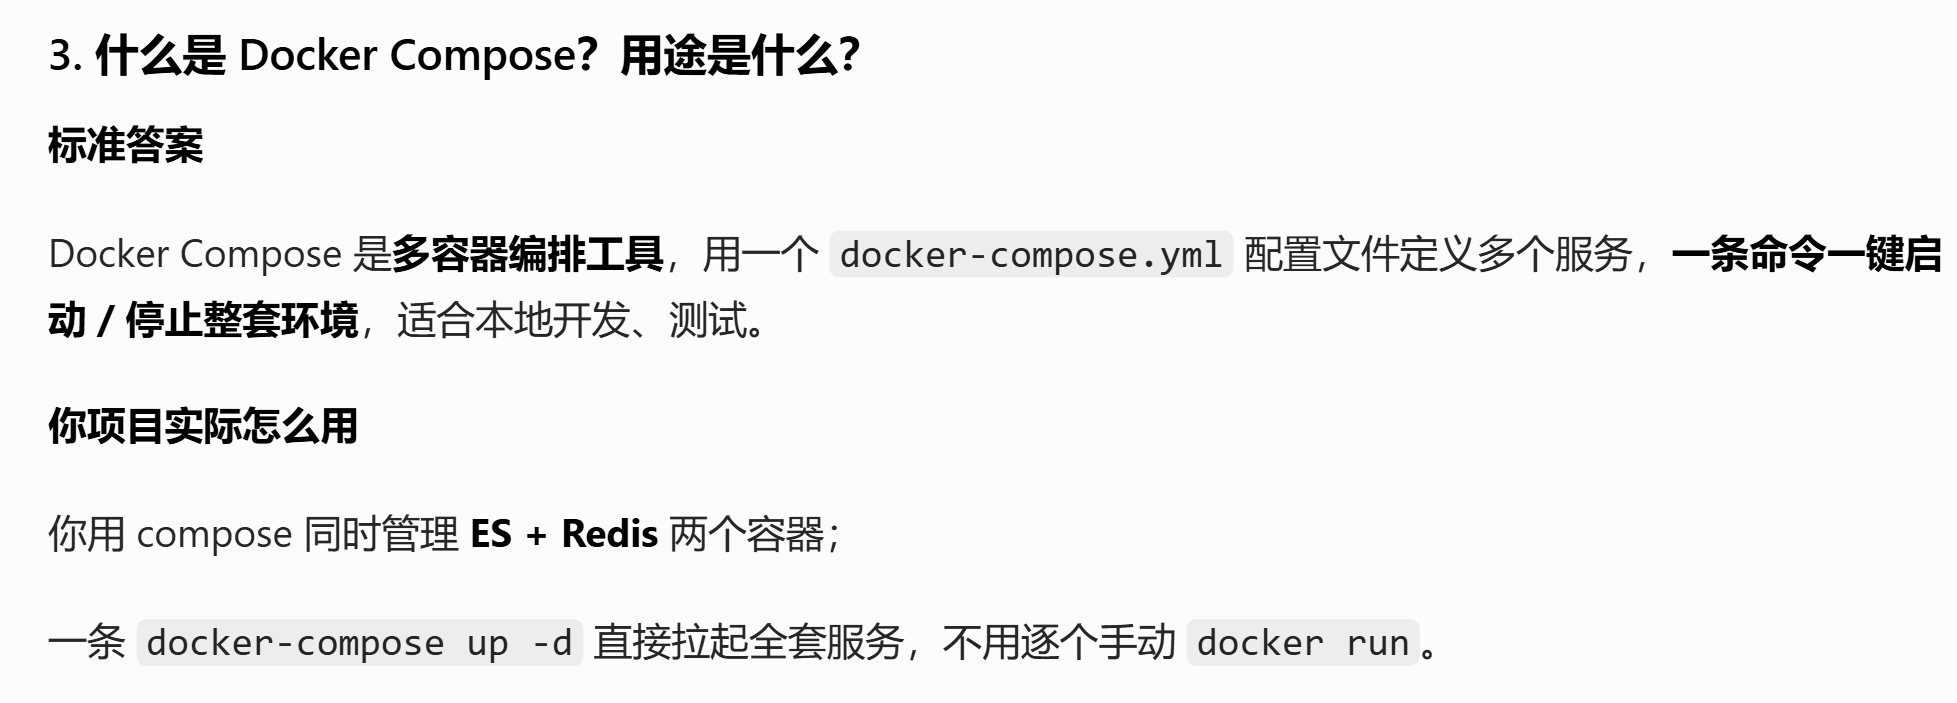
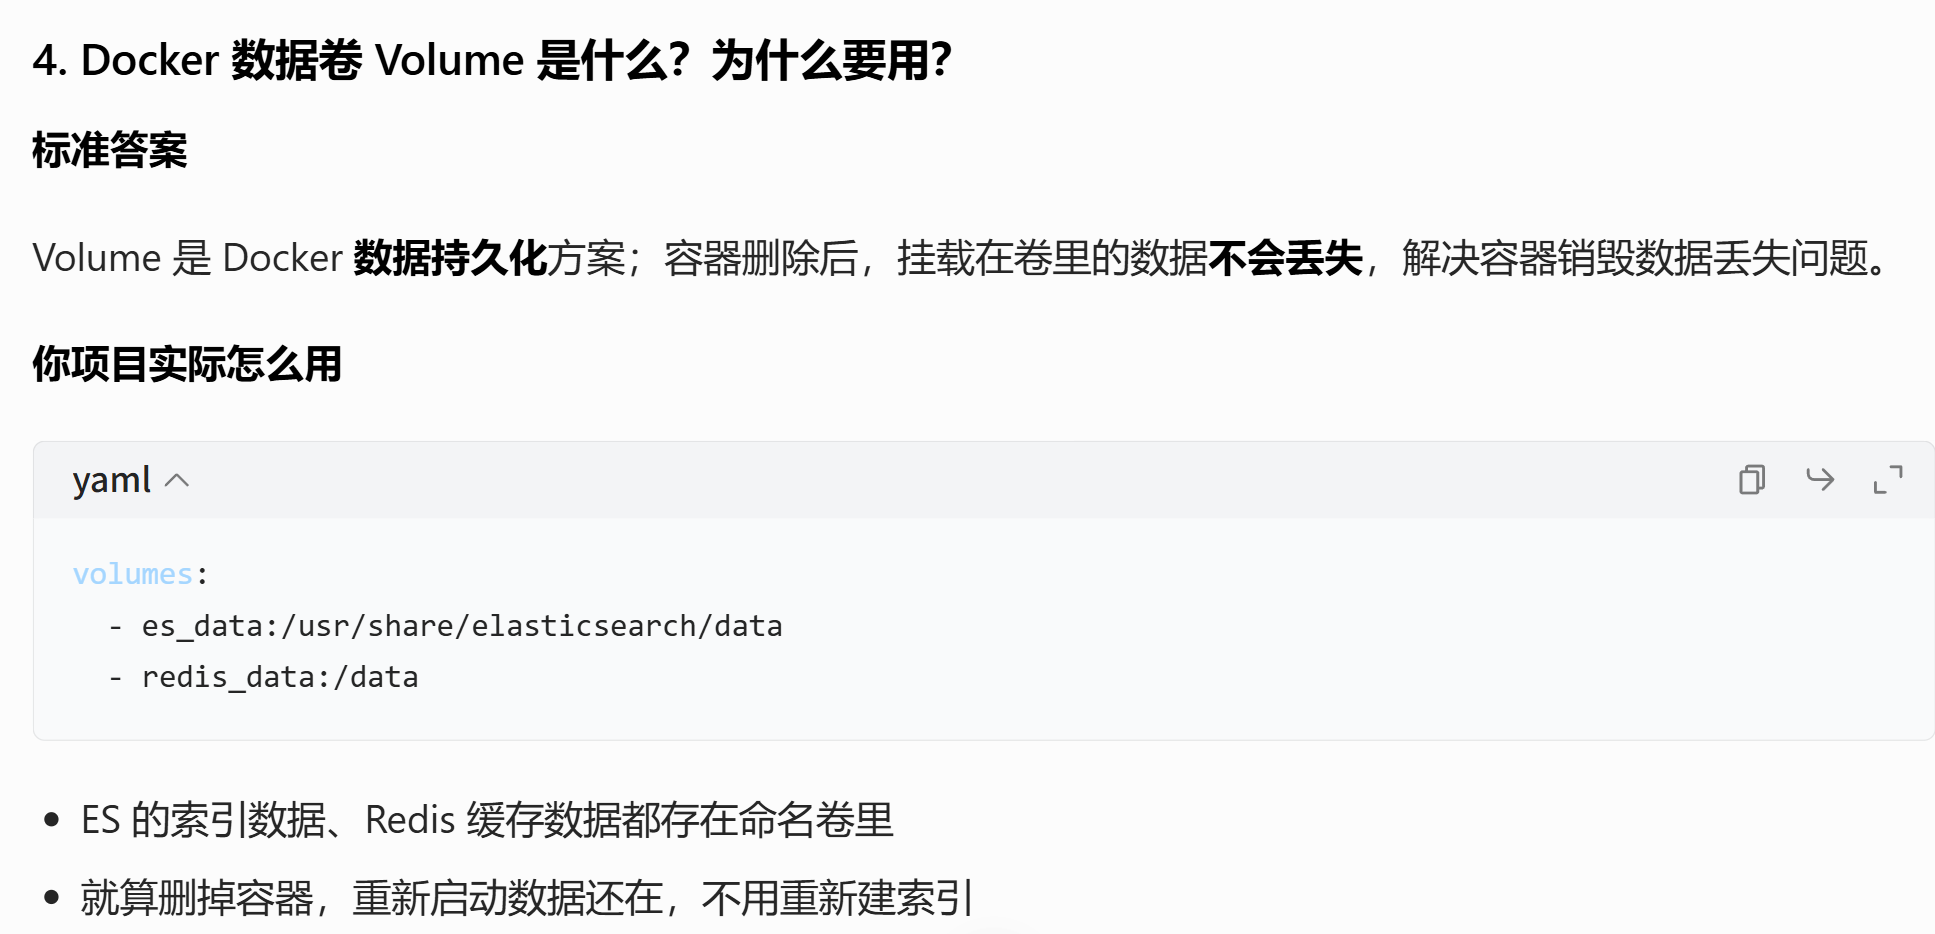
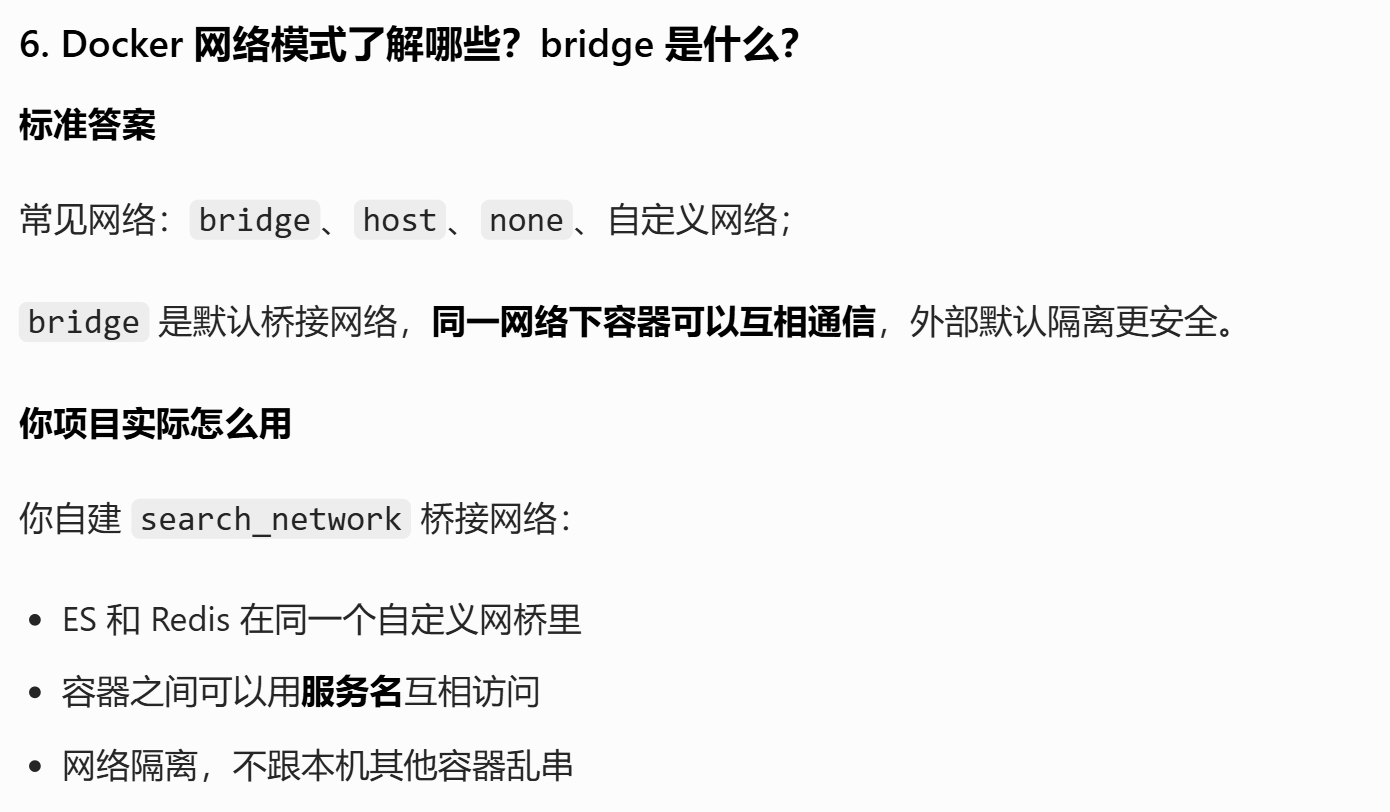
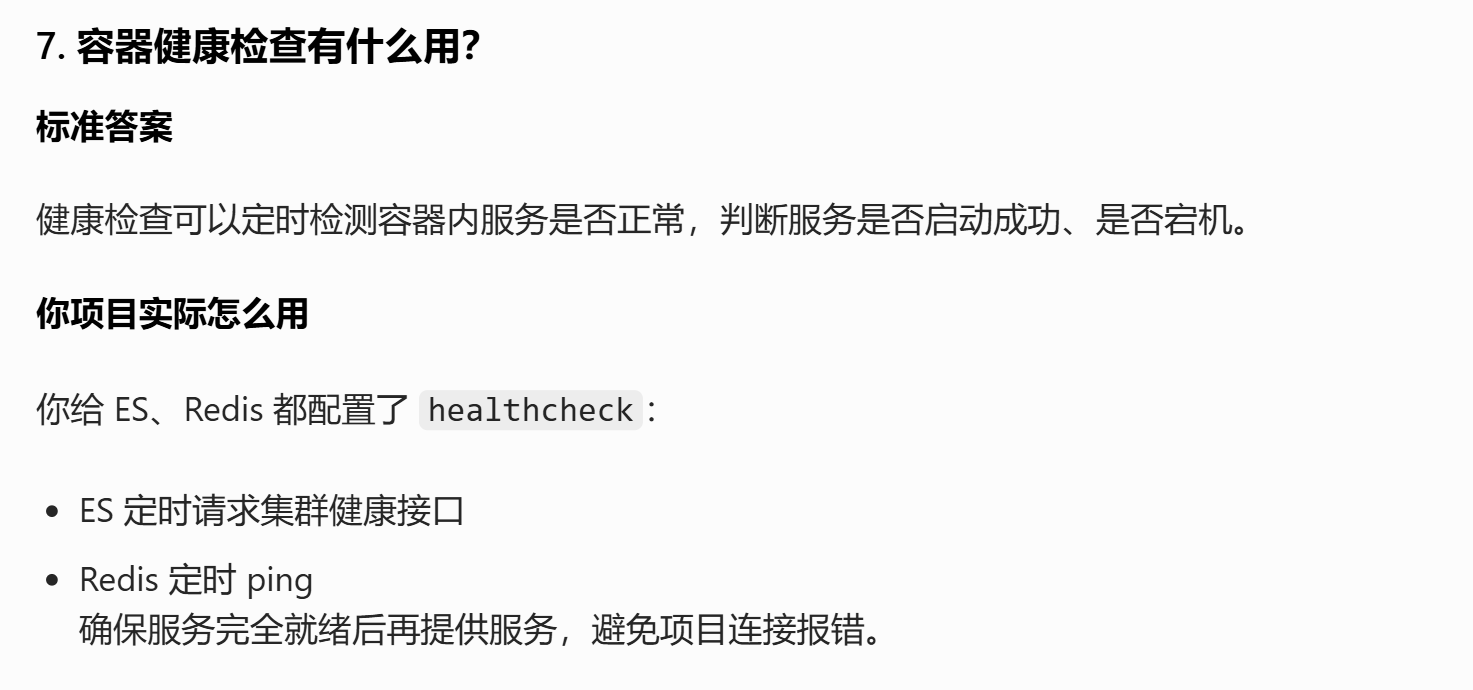
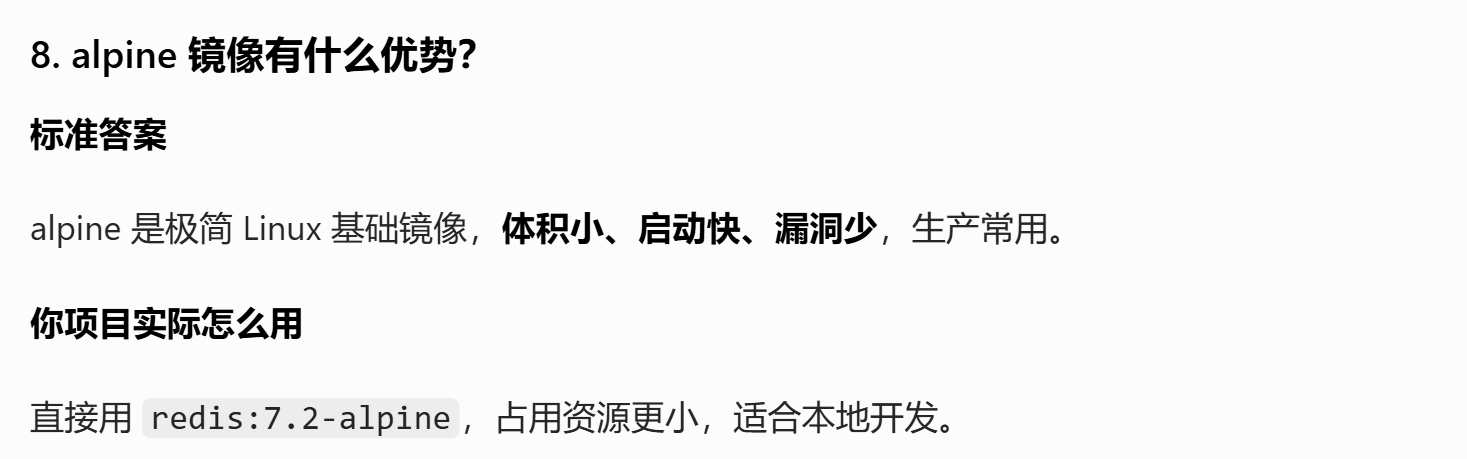
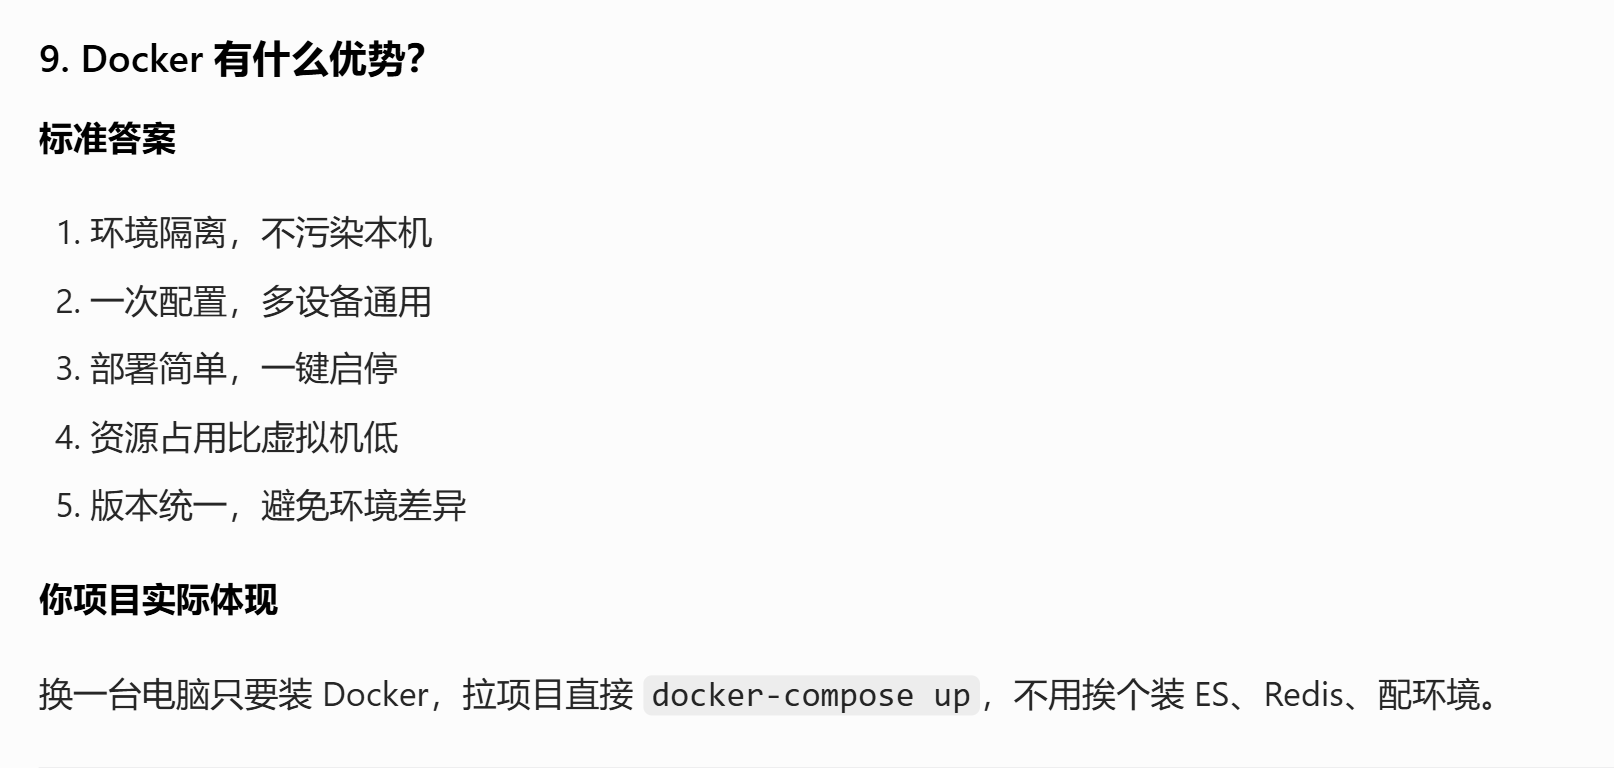
项目使用 Docker Compose 容器化部署 Elasticsearch 和 Redis 服务,实现环境一键搭建、隔离运行与数据持久化,确保开发、部署、多平台运行环境完全一致。
【文件检索 CORE】
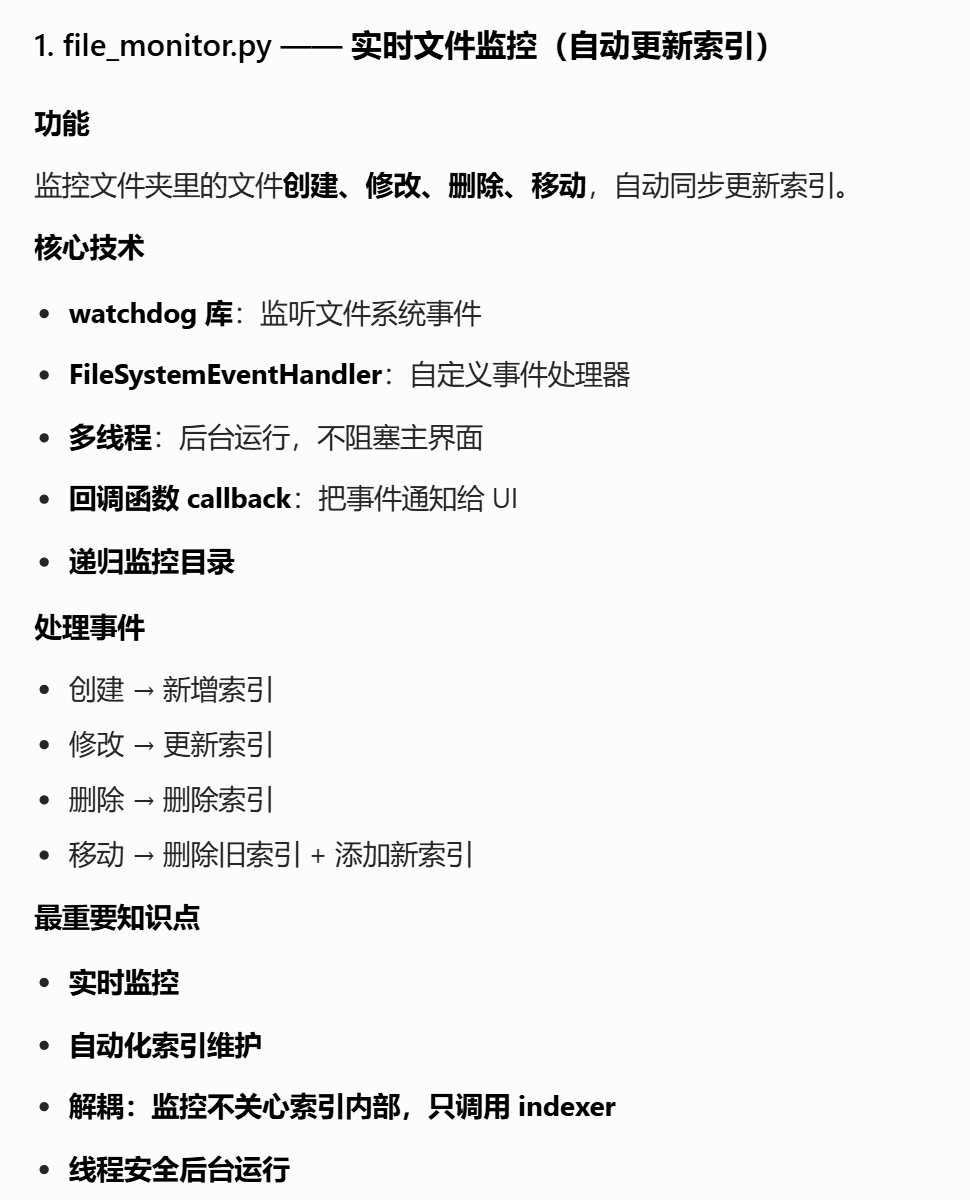
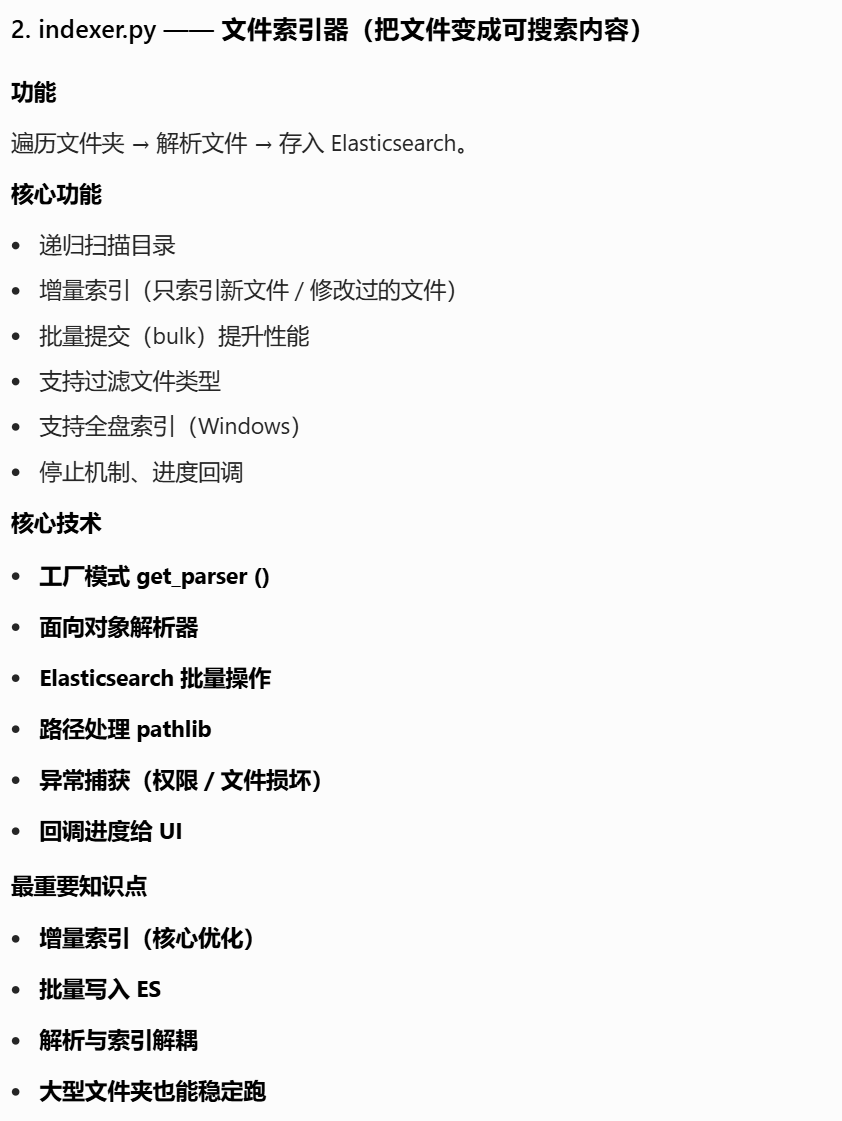
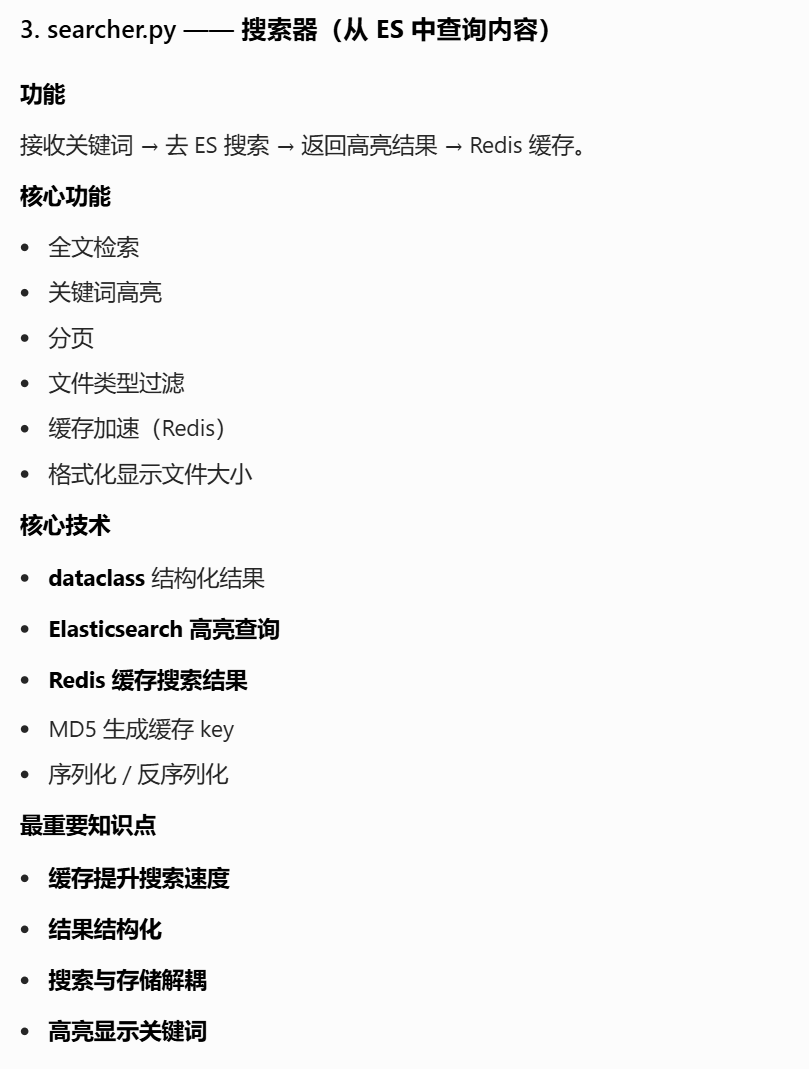
本模块是文件检索系统的核心业务层,包含实时文件监控、增量索引构建、全文搜索、缓存加速四大功能。通过 watchdog 实现目录实时监听,自动同步索引;使用 Elasticsearch 实现高效全文检索与高亮;通过 Redis 缓存搜索结果;采用工厂模式解析多格式文档;整体架构模块化、解耦、可扩展,支持大规模文件高效检索。
【ES】
"multi_match": {
    "query": query,
    "fields": ["content", "file_name"],
    "type": "best_fields",
    "fuzziness": "AUTO"
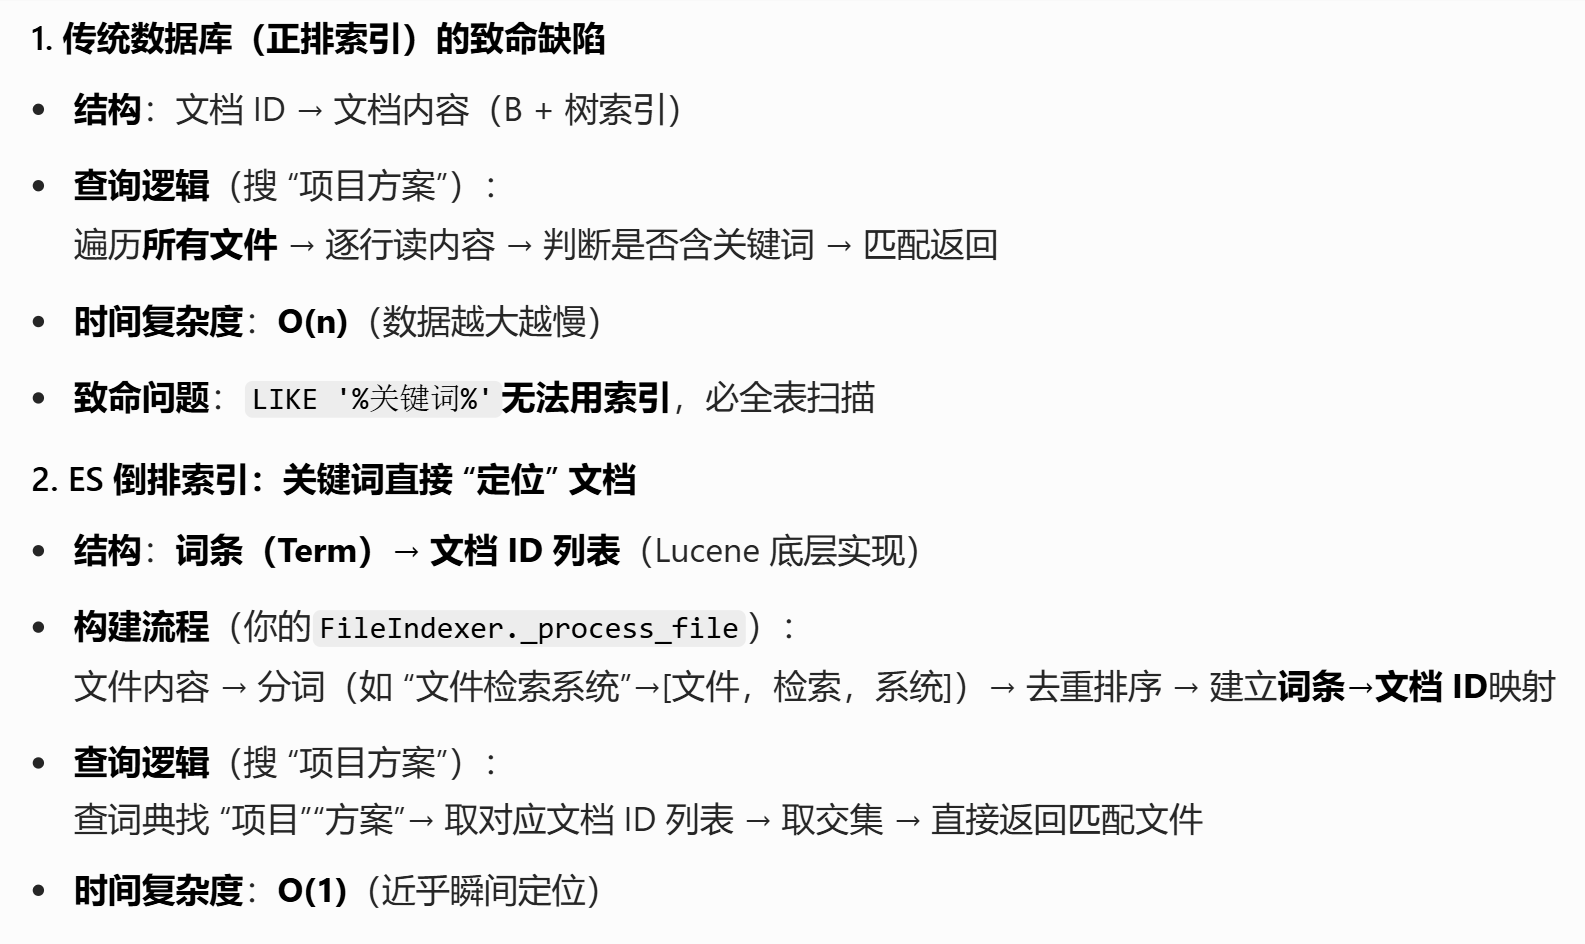
}- 同时搜文件名 + 文件内容
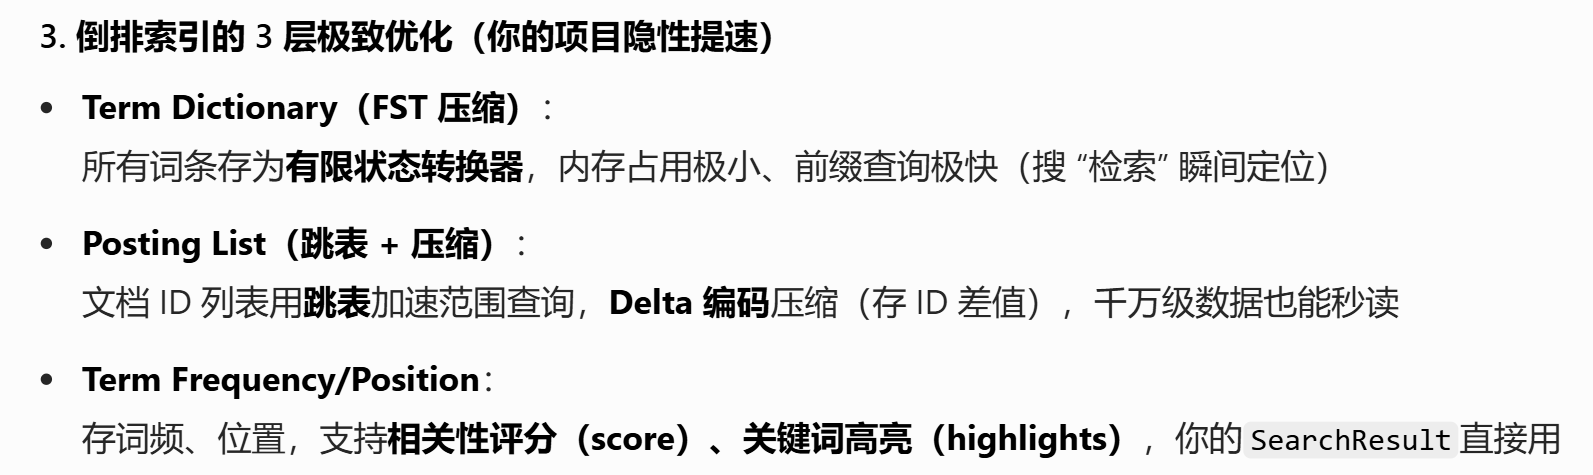
- 自带分词、倒排匹配
- 模糊匹配(拼错一点也能搜到)
- 不是暴力字符串匹配,是索引匹配
输入任意关键词,毫秒级返回,不是逐个文件扫描。
"highlight": {
    "fields": {
        "content": {
            "fragment_size": 200,
            "number_of_fragments": 3
        }
    }
}
ES 在索引中直接定位关键词位置,截取片段返回。
如果自己做:
- 查出整篇内容
- 代码里字符串查找、截取
- 很慢、耗内存
现在:ES 底层帮你做好,直接返回结果片段
【REDIS】
缓存搜索结果,让重复搜索 “秒回”
- 第一次搜索 → 查 Elasticsearch
- 第二次相同搜索 → 直接从 Redis 取,不查 ES
- 速度提升 10~100 倍
1. Key-Value 缓存(最基础)
Redis 是内存型键值数据库,项目中:
self.client.setex(key, ttl, value)
self.client.get(key)
体现:
- 缓存 = 把结果存在 内存
- 读速度远快于磁盘数据库
2. TTL 过期自动删除
def set(self, key: str, value: str, ttl: int = None):
    self.client.setex(key, ttl, value)
知识点:
- 设置过期时间
- 过期自动删除
- 防止缓存无限堆积
3. JSON 序列化与反序列化
def get_json(self, key: str) -> Optional[dict]:
    value = self.client.get(key)
    return json.loads(value)

def set_json(self, key: str, value: dict):
    self.client.set(key, json.dumps(value))
知识点:
- Redis 不能直接存对象
- 必须转成 JSON 字符串
- 取出来再转回字典 / 对象
4. 缓存键规则设计
search:abc123def456
def _make_cache_key(...):
    return f"search:{hash_key}"
知识点:
- 前缀区分缓存类型
- 便于批量删除
- 便于管理
5. Pattern 批量删除
def clear_search_cache(self):
    return self.clear_pattern("search:*")
知识点:
- 通配符
*匹配所有search:开头的 key - 一键清空所有搜索缓存
6. 单例模式(Singleton)
redis_client = RedisClient()
知识点:
- 全局只创建一个连接
- 避免频繁连接 / 断开
- 性能更高
7. 延迟初始化连接(Lazy Load)
@property
def client(self):
    if self._client is None:
        self._client = redis.Redis(...)
    return self._client
知识点:
- 用到时才创建连接
- 不浪费资源
- 项目启动更快
8. 异常安全处理
def ping(self) -> bool:
    try:
        return self.client.ping()
    except Exception:
        return False
知识点:
- 即使 Redis 挂了
- 主程序不会崩溃
- 降级直接查 ES
9. 内存数据库(速度极快)
Redis 所有数据存在内存ES 是磁盘 + 内存所以:Redis 搜索响应 ≈ 1ms ~ 5msES 搜索响应 ≈ 50ms ~ 200ms
10. 连接池与连接关闭
def close(self):
    if self._client:
        self._client.close()
知识点:
- 资源释放
- 避免连接泄漏
在项目中 Redis 的作用总结
1. 加速搜索
重复搜索不访问 Elasticsearch,直接从内存取结果。
2. 减轻 Elasticsearch 压力
高频率搜索不会把 ES 查崩。
3. 缓存搜索结果
相同查询直接返回,毫秒级响应。
4. 自动过期清理
保持缓存新鲜,避免脏数据。
5. 提高用户体验
搜索秒回,界面不卡顿。
更多推荐


 10
 0
- 0


 已为社区贡献2条内容

所有评论(0)